Introduzione alla cybersecurity e alle vulnerabilità del software


Nel mondo odierno, dove la dipendenza dalla tecnologia è crescente, la cybersecurity è diventata un pilastro fondamentale. La sicurezza informatica non riguarda solo la protezione di dati e risorse, ma anche la gestione delle vulnerabilità che emergono nei sistemi e nelle applicazioni software. Uno degli errori comuni è la fiducia cieca nella fonte da cui si ottiene il software: installare programmi da fonti non verificate può esporre a gravi rischi, poiché software dannosi come trojan e virus sono spesso distribuiti tramite siti web malevoli o email fraudolente. In questi casi, la vulnerabilità risiede non solo nel software ma anche negli utenti, i quali, se non adeguatamente formati, possono commettere errori nella valutazione delle fonti e dei rischi associati.

Affidarsi solo all’affidabilità della fonte di download non è sufficiente. Anche quando scarichiamo software da siti web legittimi, potremmo comunque trovarci esposti a minacce come attacchi “man in the middle” che compromettono il file durante il trasferimento. Inoltre, errori logici interni al software o input inattesi (non è detto che l’input sia fidato, ovvero “soddisfi le precondizioni”), possono compromettere l’intero sistema. Pertanto, la correttezza del software, intesa come aderenza ai requisiti funzionali e prevenzione degli errori, diventa un aspetto cruciale.

Quando una vulnerabilità viene scoperta, l’utente deve segnalarla a un team di risposta agli incidenti informatici, come i CERT (Computer Emergency Response Team) o i CSIRT (Computer Security Incident Response Team). Questi enti, spesso supportati da università o enti governativi, verificano la presenza della vulnerabilità e avvisano i produttori del software, prima di pubblicare un avviso di sicurezza. Tuttavia, esiste anche un mercato illecito per queste vulnerabilità, detto mercato degli “zero-day”, dove le falle sconosciute e non documentate possono essere vendute e sfruttate dai criminali.

L’economia del crimine informatico non si limita alle vulnerabilità zero-day. Esistono veri e propri mercati per exploit, malware, botnet e credenziali rubate, spesso venduti come servizi “as-a-service”. Questi mercati prosperano nel dark web, sfruttando reti anonime come TOR per garantire la segretezza e l’intracciabilità delle transazioni. Ad esempio, i dati delle carte di credito o gli account compromessi possono essere venduti a prezzi che variano a seconda del livello di compromissione e del valore dell’account.

Per catalogare e analizzare le vulnerabilità, sono stati sviluppati database come il National Vulnerability Database (NVD) e il Common Vulnerabilities and Exposures (CVE), che documentano le vulnerabilità note e forniscono indicazioni su come mitigare i rischi. Le vulnerabilità vengono inoltre classificate tramite il Common Vulnerability Scoring System (CVSS), un sistema di valutazione che attribuisce un punteggio alla gravità del rischio, guidando le aziende nelle priorità di intervento.

Il Common Weakness Enumeration (CWE) è un elenco standardizzato delle debolezze più comuni nella sicurezza del software, sviluppato per facilitare l’identificazione e la prevenzione di vulnerabilità. A differenza del CVE, che si concentra su vulnerabilità specifiche e istanze particolari in software o sistemi, il CWE descrive debolezze generali che possono essere sfruttate in una vasta gamma di contesti. Tra le debolezze più rilevanti troviamo problemi come il “buffer overflow”, che può portare a corruzione della memoria e attacchi di esecuzione arbitraria di codice, la “SQL Injection”, dove l’immissione di comandi non validati può compromettere database e sistemi, e l’“out-of-bounds write”, dove l’accesso a memoria al di fuori dei limiti previsti può causare crash o vulnerabilità critiche. Il CWE non solo funge da linguaggio comune per discutere di questi problemi, ma fornisce anche una base per sviluppare strumenti di testing e pratiche di sicurezza, aiutando gli sviluppatori a progettare sistemi più robusti e resilienti fin dalle fasi iniziali di sviluppo.

Uno dei miti più diffusi è che un software sia “sicuro” se funziona come previsto. Tuttavia, affidabilità e sicurezza non sono sinonimi: un software può soddisfare i requisiti funzionali ma essere comunque vulnerabile ad abusi e attacchi. Inoltre, la sicurezza non dipende solo dalle caratteristiche visibili come la crittografia o il controllo degli accessi, ma anche dall’integrazione sicura di ogni funzione. Le minacce derivano anche dall’imprevedibilità dell’uso del software: moderni sistemi connessi e complessi sono difficili da proteggere completamente.

Alcuni “falsi miti” e la realtà

  • Funziona in modo affidabile, soddisfacendo tutti i requisiti funzionali.
    –Affidabilità non vuol dire sicurezza: “Il software affidabile fa quello che deve fare. Il software sicuro fa quello che deve fare e nient’altro” (Ivan Arce). Non si tratta solo di come il software deve essere usato, ma anche di come può essere abusato: in quanto i requisiti funzionali sono guidati dai casi d’uso, mentre i requisiti di sicurezza sono guidati da casi di abuso.
  • Dispone di tutte le caratteristiche di sicurezza appropriate.
    –Funzionalità di sicurezza non vuol dire funzionalità sicure: le funzionalità di sicurezza sono– caratteristiche direttamente collegate agli obiettivi di sicurezza, come l’uso della crittografia, la gestione delle password, il controllo degli accessi, ecc. Devono essere implementate con attenzione, ma lo sviluppo non può concentrarsi solo sulle caratteristiche di sicurezza (Seven Pernicious Kingdoms). Le funzionalità sicure sono qualsiasi funzionalità, anche se non direttamente correlate a un requisito di sicurezza, che possono mettere a rischio la sicurezza.
  • I possibili utilizzi sono ben noti e sotto controllo.
    –Non è possibile prevedere tutti i possibili usi di un sistema software. Il software moderno è soggetto alla “The Trinity of Trouble” (ToT) (Trinità dei problemi) :
  1. Connettività: i sistemi software sono connessi.
  2. –Complessità: la loro organizzazione può essere intricata e complessa.
  3. –Estensibilità: si evolvono e possono essere estesi in modo imprevedibile.

Tutti questi aspetti sono naturalmente correlati tra loro.

  1. – Principio n. 1: il difensore deve difendere tutti i punti; l’attaccante può scegliere il punto più debole.
  2. – Principio n. 2: il difensore può difendersi solo da attacchi noti; l’attaccante può sondare le vulnerabilità sconosciute.
  3. – Principio n. 3:  il difensore deve essere costantemente vigile; l’attaccante può colpire a piacimento. –
  4. Principio n. 4: il difensore deve rispettare le regole; l’attaccante può giocare sporco.
  • Il codice è “chiuso” e le versioni binarie sono offuscate. Anche i nostri meccanismi di crittografia sono segreti.
    –“Security by design vs security by obscurity”: security by obscurity si basa sulla segretezza come metodo generale per la sicurezza. Funziona come deterrente, aumenta il lavoro dell’attaccante, ma i segreti sono difficili da mantenere a lungo (ad es. considerare le fughe di notizie, le tecniche di reverse engineering). – In generale, ricordiamo i principi dei “vantaggi dell’attaccante”. Security by design si basa su 10 principi generali di sicurezza:
  1. Semplicità
  2. Design Open
  3. Suddivisione
  4. Esposizione minima
  5. Minimo privilegio
  6. Minima fiducia e massima affidabilità
  7. Difetti sicuri e a prova di errore
  8. Mediazione completa
  9. Nessun singolo punto di errore
  10. Tracciabilità
  • Per quanto riguarda la sicurezza, conduciamo un pentest approfondito alla fine del ciclo di sviluppo del software.
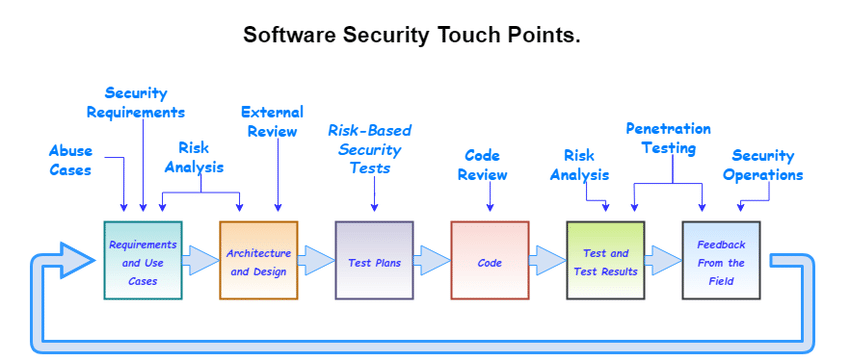
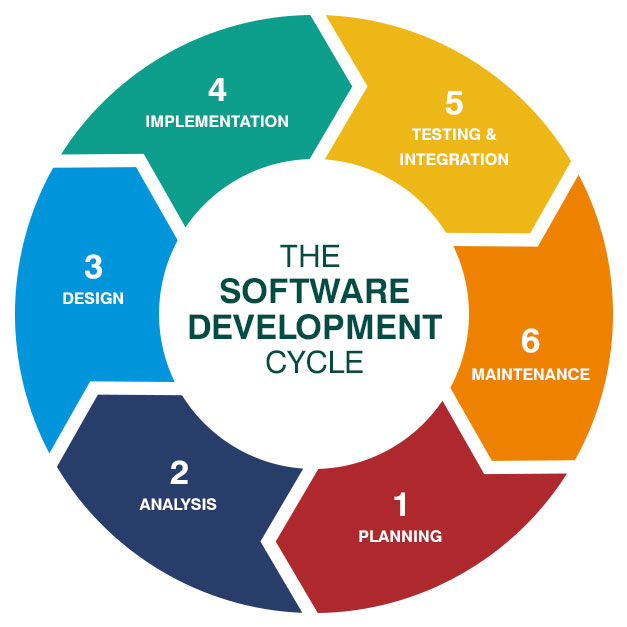
    –Software development life cycle (SDLC) e il “modello touchpoint”. Il Software Development Life Cycle (SDLC) è un processo strutturato per lo sviluppo di software di alta qualità. Include una serie di fasi che gli sviluppatori seguono per pianificare, progettare, costruire, testare e distribuire un software. L’SDLC fornisce una mappa per il team di sviluppo e garantisce che il prodotto finale soddisfi i requisiti e sia affidabile. Le fasi tipiche dell’SDLC sono:
  1. Pianificazione e analisi dei requisiti: si identificano le esigenze del cliente e si definiscono i requisiti che il software deve soddisfare. Si stabiliscono obiettivi, risorse e tempistiche.
  2. Progettazione: si pianifica l’architettura del software, definendo l’organizzazione del sistema, l’interfaccia utente e il flusso di dati.
  3. Implementazione e codifica: in questa fase si scrive il codice del software. Gli sviluppatori traducono il progetto in codice funzionante, seguendo standard e pratiche di programmazione.
  4. Test: si eseguono vari tipi di test (unit testing, integration testing, system testing, ecc.) per verificare che il software funzioni correttamente e soddisfi i requisiti.
  5. Deployment (distribuzione): una volta che il software è stato testato e considerato pronto, viene distribuito agli utenti finali.
  6. Manutenzione e supporto: dopo il rilascio, il software entra in una fase di manutenzione in cui si correggono bug, si ottimizza il funzionamento e si gestiscono aggiornamenti.
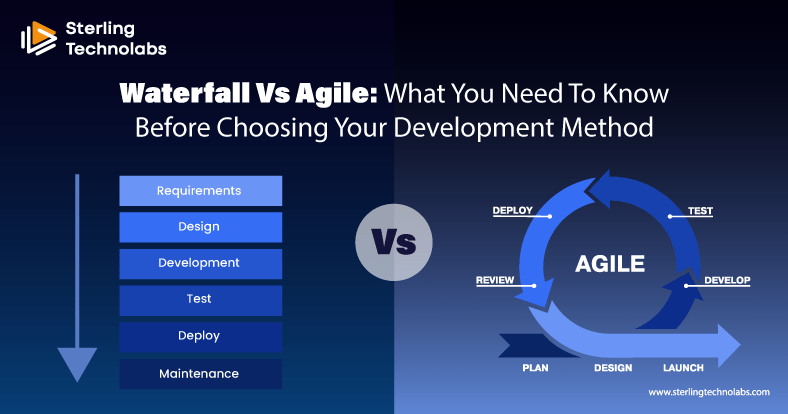
Il modello Touchpoint, sviluppato da Gary McGraw, è una metodologia per incorporare la sicurezza in ogni fase dell’SDLC. A differenza di un approccio “a cascata”, dove la sicurezza è spesso trattata come una fase separata o come un controllo finale, il modello touchpoint incoraggia la sicurezza come parte integrante di tutte le fasi dello sviluppo. I “touchpoint” sono punti strategici dell’SDLC in cui vengono applicate pratiche di sicurezza specifiche. Le principali attività di sicurezza nel modello touchpoint includono:

  1. Code review (revisione del codice): effettuare revisioni del codice manuali o automatiche per identificare vulnerabilità, come SQL injection o buffer overflow. Questo consente di correggere errori di sicurezza direttamente nel codice.
  2. Design review (revisione del progetto): rivedere l’architettura e la progettazione del software per assicurarsi che le decisioni di design non introducano vulnerabilità. Questo può includere un’analisi dei controlli di accesso, della crittografia e delle interazioni con altri sistemi.
  3. Testing di sicurezza: durante i test funzionali, è essenziale includere anche test di sicurezza, come penetration testing o test di fuzzing, per verificare che il software non sia vulnerabile a exploit.
  4. Gestione delle minacce (threat modeling): in questa fase si identificano e valutano le potenziali minacce al sistema, pianificando contromisure e strategie di mitigazione. Il threat modeling può avvenire in diverse fasi, ma è tipicamente più efficace nella fase di progettazione.
  5. Configurazione sicura (security configuration): assicurarsi che i componenti del software, così come i server e le reti, siano configurati in modo sicuro, riducendo al minimo le superfici di attacco.
  6. Incident response planning (piano di risposta agli incidenti): peparare un piano di risposta agli incidenti per gestire eventuali attacchi e violazioni. Avere questo piano in atto sin dalle prime fasi consente di ridurre l’impatto di eventuali exploit.
  7. Formazione sulla sicurezza per gli sviluppatori: assicurarsi che il team di sviluppo sia informato sulle migliori pratiche di sicurezza, per evitare errori comuni durante la scrittura del codice.
  • Abbiamo appena rilasciato una patch che ha risolto tutti i problemi di sicurezza ed è protetta contro ogni exploit conosciuto.
    –Finestra di vulnerabilità, exploit zero-day. La finestra di vulnerabilità è un concetto utilizzato in sicurezza informatica per descrivere l’intervallo di tempo in cui una vulnerabilità è nota ma non ancora corretta. Durante questo periodo, i sistemi e le applicazioni che presentano la vulnerabilità sono a rischio di attacco, poiché i difetti possono essere sfruttati dagli attaccanti prima che i proprietari del sistema o i fornitori del software rilascino una patch o una correzione.
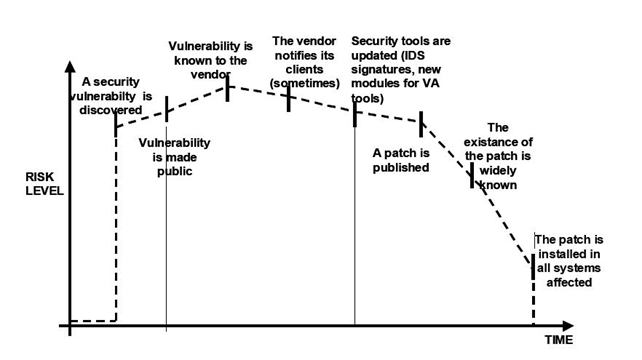
Ciclo di vita delle vulnerabilità di sicurezza – Fonte OWASP

Caratteristiche della finestra di vulnerabilità

  1. Inizio della finestra: la finestra di vulnerabilità inizia nel momento in cui una falla di sicurezza è scoperta e viene resa pubblica o comunque conosciuta dagli attaccanti.
  2. Fine della finestra: la finestra termina quando viene distribuita e applicata una patch di sicurezza che corregge la vulnerabilità su tutti i sistemi interessati.
  3. Durata variabile: la durata della finestra di vulnerabilità può variare. In alcuni casi, i fornitori rilasciano rapidamente una patch, riducendo il tempo di esposizione. In altri casi, la correzione può richiedere più tempo, prolungando la finestra e aumentando il rischio.

Un exploit zero-day (o attacco zero-day) è una tipologia di attacco che sfrutta una vulnerabilità nel software non ancora conosciuta dai produttori o dal pubblico. In altre parole, si tratta di una vulnerabilità “a giorno zero” perché non è stata ancora scoperta o affrontata con un aggiornamento di sicurezza, lasciando il sistema completamente esposto.

Caratteristiche degli Exploit Zero-Day

  1. Ignoranza del fornitore: un exploit zero-day sfrutta una vulnerabilità di cui il fornitore non è ancora a conoscenza. Questo significa che non esiste alcuna patch o correzione disponibile al momento dell’attacco.
  2. Alta efficacia: gli exploit zero-day sono particolarmente pericolosi perché possono bypassare le misure di sicurezza esistenti, proprio perché non sono ancora stati catalogati né gestiti.
  3. Difficoltà di rilevamento: questi exploit sono difficili da rilevare e mitigare, poiché le soluzioni di sicurezza non hanno ancora aggiornamenti o regole specifiche per bloccare l’attacco.

Relazione tra finestra di vulnerabilità ed exploit zero-day. Quando viene scoperta una vulnerabilità zero-day, si apre immediatamente una finestra di vulnerabilità. Finché la falla non è nota pubblicamente, il rischio è limitato a un numero ristretto di attaccanti che conoscono l’exploit. Tuttavia, quando l’exploit diventa di dominio pubblico, la finestra di vulnerabilità può aumentare considerevolmente in termini di esposizione.

Mitigazione della finestra di vulnerabilità e degli exploit zero-day. Per gestire la finestra di vulnerabilità e ridurre il rischio associato agli exploit zero-day, è possibile adottare le seguenti misure:

  1. Patch management: implementare un sistema di gestione delle patch efficace per applicare rapidamente gli aggiornamenti di sicurezza appena disponibili.
  2. Threat intelligence: utilizzare fonti di threat intelligence per rimanere aggiornati sulle nuove minacce e sugli exploit zero-day che potrebbero colpire i sistemi.
  3. Implementazione di sicurezza multi-livello: avere sistemi di sicurezza su più livelli, come firewall, sistemi di rilevamento e prevenzione delle intrusioni (IDS/IPS) e controlli di accesso rigorosi, può ridurre l’impatto di un exploit zero-day.
  4. Analisi del comportamento e anomaly detection: tecniche di rilevamento basate sull’analisi del comportamento aiutano a identificare attività anomale anche se un attacco zero-day cerca di eludere i controlli di sicurezza convenzionali.
  5. Segmentazione della rete: segmentare la rete può limitare i danni che un attaccante può causare in caso di sfruttamento di una vulnerabilità zero-day.

È quindi necessario sviluppare software secondo i principi della “security by design”, in contrasto alla “security by obscurity”. I principi di sicurezza da incorporare includono semplicità, suddivisione dei privilegi, esposizione minima, tracciabilità e l’assenza di punti di errore singoli. A differenza del classico test di sicurezza svolto a fine sviluppo, un ciclo di vita dello sviluppo del software (SDLC) ben pianificato include la sicurezza in ogni fase, minimizzando le vulnerabilità di design.

In sintesi, la cybersecurity non è un obiettivo raggiungibile con un unico intervento. Essa richiede un approccio integrato, che combini formazione, adozione di tecniche sicure nello sviluppo e costante monitoraggio delle minacce emergenti. Una comprensione profonda delle vulnerabilità e l’implementazione di una sicurezza “by design” rappresentano i fondamenti per proteggere i sistemi in un panorama digitale in continua evoluzione.

Seven Pernicious Kingdoms

Una tassonomia creata per aiutare gli sviluppatori a comprendere gli errori di programmazione più comuni che influiscono sulla sicurezza.

Il modello del Seven Pernicious Kingdoms è un framework utilizzato per classificare le principali categorie di vulnerabilità nel codice, in particolare in ambito di sicurezza applicativa. Sviluppato dai ricercatori di Cigital (in particolare Gary McGraw), il modello è un modo per raggruppare le vulnerabilità in base alla loro natura e impatto. I “Sette Regni” rappresentano tipi distinti di difetti nel codice, che possono essere utilizzati per strutturare e migliorare la sicurezza del software.

Ecco i sette “regni” di vulnerabilità:

  1. Input validation and representation: si riferisce ai difetti che derivano da una gestione impropria dei dati di input o dalla rappresentazione inadeguata dei dati, portando a vulnerabilità come SQL injection, command injection e cross-site scripting (XSS).
  2. API abuse: riguarda l’uso improprio delle API, spesso dovuto a una mancata comprensione dei limiti o delle modalità d’uso corrette delle stesse, che può consentire exploit a livello di API.
  3. Security features: include difetti legati all’implementazione errata delle caratteristiche di sicurezza, come l’autenticazione, la gestione delle sessioni, e il controllo degli accessi. Difetti in questo “regno” possono portare a problemi come session hijacking o bypass delle restrizioni di accesso.
  4. Time and state: questo “regno” riguarda vulnerabilità legate alla gestione del tempo e degli stati. Problemi come race conditions (condizioni di corsa) o gestione inadeguata delle risorse possono far sì che un utente malintenzionato prenda il controllo di una risorsa o esegua azioni dannose.
  5. Errors: si riferisce alla gestione errata degli errori, come la visualizzazione di messaggi d’errore dettagliati che rivelano informazioni sensibili o la mancanza di controllo su errori imprevisti, che possono facilitare l’enumerazione o l’accesso a dettagli interni.
  6. Code quality: questo “regno” comprende le vulnerabilità derivanti da una scarsa qualità del codice, come buffer overflow, pointer dereferencing e altri errori che possono portare a comportamenti imprevisti o a falle di sicurezza.
  7. Encapsulation: si riferisce a difetti nella separazione dei dati e nella gestione dell’accesso. Problemi di incapsulamento possono portare a fughe di informazioni o all’alterazione di dati interni che dovrebbero essere inaccessibili all’utente.

(torna su)
Mobile analysis per la rilevazione di virus e malware su Android e iOS

La sicurezza dei dispositivi mobile è diventata una preoccupazione critica nell’era digitale. Con oltre 6 miliardi di utenti di smartphone in tutto il mondo, questi dispositivi sono diventati un obiettivo primario per i criminali informatici. Gli smartphone contengono una vasta quantità di dati personali e aziendali sensibili, rendendo l’analisi malware su questi dispositivi un aspetto fondamentale della cybersecurity moderna.

Android e iOS presentano approcci diversi in termini di architettura e sicurezza. Android, essendo un sistema più aperto, consente maggiore flessibilità agli utenti ma anche una maggiore esposizione alle minacce. Al contrario, iOS adotta un modello più chiuso, con rigidi controlli su app e accessi, il che rende più difficile compromettere il sistema, ma non lo esclude.

L’analisi malware su smartphone è il processo di esaminare un dispositivo mobile per rilevare, identificare e comprendere software malevoli che potrebbero comprometterne la sicurezza. Questa pratica è essenziale per:

  • proteggere le informazioni personali degli utenti;
  • salvaguardare i dati aziendali su dispositivi BYOD (Bring Your Own Device)[1];
  • mantenere l’integrità delle reti mobili;
  • prevenire frodi finanziarie e furti di identità.

I malware per smartphone si sono evoluti in diverse forme, ciascuna con obiettivi e metodi di attacco specifici:

  • Spyware: raccoglie informazioni sull’utente senza il suo consenso;
  • Ransomware: estorce denaro bloccando l’accesso ai dati o al dispositivo crittografando i file;
  • Adware: genera ricavi attraverso pubblicità invasive, mostra annunci non richiesti, reindirizza a siti web malevoli;
  • Trojan: si nasconde come app legittima per eseguire azioni malevole in background;
  • Rootkit: ottiene l’accesso privilegiato al sistema operativo modificando il kernel del sistema per nascondere la propria presenza.

I malware possono infettare gli smartphone attraverso vari vettori:

  • download di app da fonti non ufficiali;
  • phishing attraverso SMS, email o messaggi sui social media con link malevoli;
  • exploit di vulnerabilità del sistema operativo sfruttando bug o falle di sicurezza non corrette nel sistema operativo;
  • connessioni Wi-Fi non sicure: intercettazione dei dati su reti pubbliche non protette.

L’analisi del malware per smartphone richiede un approccio multifaceted che combina diverse tecniche per ottenere una comprensione completa della minaccia. In tal senso, personale specializzato di questa articolazione Anticrimine ha implementato procedure e tecniche informatiche orientate all’analisi:

  • del traffico di rete: una delle tecniche principali per identificare la presenza di malware su un dispositivo mobile è l’analisi del traffico di rete. Il comportamento delle app e dei processi in background può rivelare informazioni cruciali riguardanti attività malevole. Attraverso tecniche di sniffing del traffico, è possibile catturare il flusso di pacchetti di rete, analizzare la destinazione e il contenuto dei dati scambiati, nonché rilevare anomalie nei pattern di traffico[2];
  • del comportamento delle applicazioni: le applicazioni malevole spesso richiedono più autorizzazioni di quelle strettamente necessarie al loro funzionamento;
  • attraverso scansione antivirus: la scansione antivirus è una tecnica fondamentale e ampiamente utilizzata per l’analisi preliminare e la rilevazione di malware su smartphone. Questa metodologia si basa principalmente su un approccio di riconoscimento delle firme[3], integrato con tecniche euristiche e di rilevamento comportamentale[4];
  • delle tracce di compromissione: è particolarmente utile analizzare tracce di compromissione (Indicators of Compromise, IoC), come quelle identificate tramite lo “Structured Threat Information Expression” (STIX)[5], che possono rivelare la presenza di malware o altre attività dannose. L’utilizzo di STIX nell’analisi di malware su smartphone rappresenta un approccio avanzato che combina standardizzazione, condivisione di intelligence e analisi strutturata. Mentre richiede un certo expertise, offre benefici significativi in termini di comprensione approfondita delle minacce e integrazione con l’ecosistema più ampio della cybersecurity.

[1] Espressione usata per riferirsi alle politiche aziendali che permettono di portare i propri dispositivi personali nel posto di lavoro e usarli per avere gli accessi privilegiati alle informazioni aziendali e alle loro applicazioni.

[2] L’analisi dei pattern di comunicazione, come connessioni frequenti a server esterni sconosciuti o trasferimenti di grandi quantità di dati senza autorizzazione dell’utente, può suggerire la presenza di malware.

[3] Gli antivirus confrontano i file presenti nel sistema con un database di firme di malware conosciuti. Ogni virus o malware ha una propria “firma”, una sorta di impronta digitale unica che lo identifica. Se l’antivirus rileva una corrispondenza, segnala il file come dannoso.

[4] Questa tecnica si basa sull’analisi del comportamento dei file e delle applicazioni. Piuttosto che cercare solo firme conosciute, il rilevamento euristico osserva i comportamenti anomali, come l’accesso non autorizzato ai dati sensibili o l’invio di pacchetti di dati a server remoti. Ciò permette all’antivirus di identificare anche malware sconosciuti, basandosi sulle azioni che essi tentano di compiere.

[5] Lo Structured Threat Information Expression (STIX) è un linguaggio standardizzato per la rappresentazione di informazioni sulle minacce informatiche. Nel contesto dell’analisi di malware su smartphone, STIX fornisce un framework strutturato per identificare, catalogare e analizzare le tracce di compromissione (Indicators of Compromise, IoC).

Wireshark

Una breve guida introduttiva a Wireshark: “The world’s most popular network protocol analyzer”.

Wireshark è il più celebre e diffuso analizzatore di pacchetti di rete, utilizzato ampiamente sia nel mondo accademico che professionale. Originariamente lanciato nel 1998 sotto il nome di “Ethereal”, Wireshark ha guadagnato una reputazione solida per la sua efficacia e versatilità nella diagnosi di problemi di rete e nella comprensione approfondita dei protocolli di rete, tanto da essere utilizzato da:

  • sistemisti: usano Wireshark per diagnosticare e risolvere problemi di prestazioni della rete;
  • studenti: trovano in Wireshark uno strumento prezioso per apprendere e visualizzare il funzionamento dei protocolli di rete;
  • analisti di sicurezza: verificano con Wireshark la presenza di dati non autorizzati o sospetti nella rete.
  • licenza GPL: Wireshark è distribuito con una licenza GPL, rendendolo un software libero e gratuito disponibile per Windows, macOS e GNU/Linux. Sul sito ufficiale è possibile trovare i file per l’installazione oltre a una vasta documentazione di riferimento;
  • formati di file: Il formato nativo per il salvataggio dei dati è il .PCAP (Packet Capture), ma Wireshark supporta e può aprire molti altri formati di file di cattura e permette l’esportazione in vari formati;
  • riconoscimento dei protocolli: Wireshark è in grado di riconoscere automaticamente una vasta gamma di protocolli di rete, consentendo agli utenti di leggere tutti i dettagli relativi ai pacchetti catturati;
  • filtraggio e ricerca: Il software permette di filtrare i dati catturati e di svolgere ricerche selettive utilizzando una sintassi comprensiva ma accessibile.

Quando si avvia Wireshark, la prima cosa che si nota sarà l’elenco delle interfacce di rete rilevate dal proprio sistema. Questo permette di visualizzare facilmente quali interfacce sono attive e di iniziare immediatamente la cattura del traffico con un semplice doppio clic su un’interfaccia specifica. Accanto alle interfacce attive, apparirà anche un piccolo grafico che indica l’attività di rete in tempo reale.

Funzionalità chiave dell’area di lavoro di Wireshark:

  • cattura e analisi di traffico preesistente: oltre a catturare traffico in tempo reale (v. Appendice “Wireshark – uso dei filtri di cattura”), Wireshark permette di aprire e analizzare file di cattura .PCAP esistenti, facilitando l’analisi di dati raccolti in precedenza;
  • visualizzazione dei dati catturati: una volta avviata la cattura, i dati vengono visualizzati in tempo reale nell’area centrale della finestra di Wireshark, nota come “elenco pacchetti”. Qui è possibile interrompere la cattura cliccando sull’icona a forma di quadrato situata nella barra degli strumenti principale, sopra l’elenco pacchetti.

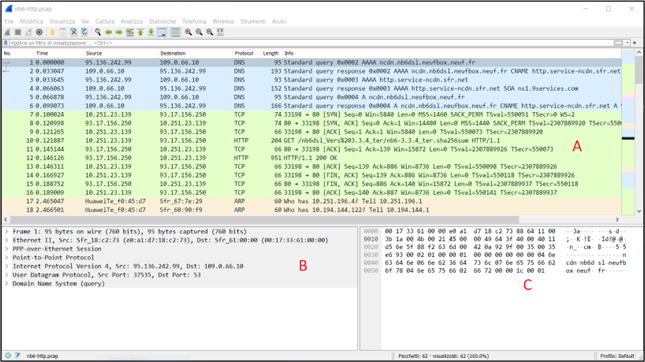
Figura 1 – L’interfaccia di Wireshark

Suddivisione dell’area di lavoro (Figura 1):

  • elenco dei pacchetti: questa è la parte principale dell’interfaccia di Wireshark (lettera A), dove tutti i pacchetti di dati catturati o caricati vengono elencati. Ogni riga rappresenta un pacchetto individuale con informazioni di base come il numero di sequenza, il protocollo utilizzato, la lunghezza del pacchetto e altro;
    • dettagli del pacchetto: selezionando un pacchetto dall’elenco, i dettagli specifici del pacchetto saranno mostrati in questa area (lettera B). I dettagli sono organizzati in un formato ad albero, che riflette l’incapsulamento dei protocolli all’interno del pacchetto. Questo aiuta a comprendere come i dati sono strutturati e quali informazioni trasportano;
    • dati contenuti nel pacchetto: in questa parte dell’interfaccia, il contenuto del pacchetto selezionato viene visualizzato in forma originale, sia in esadecimale che in ASCII (lettera C). Questo è particolarmente utile per l’analisi a basso livello dei dati e per l’individuazione di specifici pattern o informazioni all’interno del payload del pacchetto.

Barre degli strumenti e utilità:

  • barra degli strumenti principale: le icone che permettono di avviare e fermare la cattura, salvare i dati, configurare le opzioni di cattura e accedere ad altre funzioni comuni;
    • barra degli strumenti di filtraggio: posta sotto la barra degli strumenti principale, questa barra permette di inserire filtri per raffinare la visualizzazione dei pacchetti. Supporta l’evidenziazione sintattica per aiutarti a scrivere correttamente le espressioni di filtro;
    • barra di stato: situata in fondo alla finestra, mostra il numero di pacchetti catturati e fornisce accesso rapido alle proprietà del file di cattura e altre informazioni rilevanti.

L’elenco dei pacchetti è il cuore del flusso di lavoro per l’analisi di una cattura dati in Wireshark. Una volta avviata la cattura, i dati vengono decodificati e ordinati in una tabella, permettendo di seguire la sequenza di cattura dal primo all’ultimo pacchetto.

Informazioni chiave per ciascun pacchetto:

  • No.: numero progressivo del pacchetto, iniziando da 1.
  • Time: istante in cui il pacchetto è stato catturato.
  • Source: indirizzo IP sorgente.
  • Destination: indirizzo IP di destinazione.
  • Protocol: protocollo di più alto livello contenuto nel pacchetto.
  • Length: dimensione del pacchetto in byte.
  • Packet Info: estratto delle informazioni più rilevanti contenute nel pacchetto.

Wireshark, inoltre, utilizza diverse colorazioni per aiutare a identificare rapidamente i tipi di pacchetti.

La barra del menu contiene moltissime funzioni e strumenti utili per gestire e analizzare le catture di rete:

  • File: importazione ed esportazione dei dati in diversi formati.
  • Modifica: ricerca e selezione dei pacchetti, modifica del profilo di configurazione e accesso alle preferenze generali.
  • Visualizza: gestione delle barre, formato di visualizzazione del tempo di cattura, regole di colorazione.
  • Vai: navigazione e ricerca nell’elenco pacchetti.
  • Cattura: opzioni e comandi per la cattura dei dati.
  • Analizza: costruzione di filtri di visualizzazione e altre funzioni di analisi dei dati.
  • Statistiche: contiene statistiche pronte per l’analisi del traffico, grafici e proprietà del file di cattura.
  • Telefonia: strumenti per l’analisi e decodifica di flussi VoIP.
  • Wireless: dedicato al traffico Bluetooth e WiFi.
  • Strumenti: funzione per la creazione di regole per i firewall.
  • Aiuto: accesso alla guida web, wiki, FAQ, catture di esempio e altre risorse utili. Include anche informazioni sulla versione di Wireshark e sulle combinazioni di tasti.

Tra le diverse funzionalità di analisi fornite da Wireshark vi è il menu statistiche, una risorsa potente per effettuare una prima analisi generale dei dati catturati. Questo menu offre una varietà di strumenti che permettono di visualizzare informazioni dettagliate sul traffico di rete, gli host coinvolti, le connessioni stabilite e i protocolli utilizzati. Ecco una panoramica delle voci più utili disponibili nel menu Statistiche:

  • proprietà del file di cattura: questa opzione fornisce una visione generale dei metadati del file di cattura, come la dimensione in byte, la data e l’ora di cattura, il nome del file e altre informazioni simili. È utile per ottenere un riepilogo rapido delle caratteristiche principali della sessione di cattura;
  • terminatori (Endpoints): la voce “Endpoint” elenca tutti gli host coinvolti nel traffico di rete catturato. Per ciascun host, Wireshark mostra dettagli come gli indirizzi IP, gli indirizzi MAC, e le porte utilizzate per le connessioni TCP e UDP. Questo strumento è essenziale per identificare rapidamente gli attori chiave nella rete e per comprendere meglio la distribuzione del traffico;
  • conversazioni: simile alla voce “Endpoint”, “Conversazioni” mostra tutte le connessioni presenti nella cattura. Per ogni connessione, vengono dettagliati gli host coinvolti, i loro indirizzi IP, e le porte di connessione. Particolarmente utile per seguire il flusso di comunicazione tra specifici host e per identificare possibili pattern di traffico o connessioni sospette;
  • gerarchia dei protocolli: elenca tutti i protocolli di rete presenti nella cattura, organizzati per incapsulamento. Mostra chiaramente come i vari protocolli si stratificano e interagiscono tra loro nel flusso di dati, fornendo una visione comprensiva della struttura del traffico;
  • altre statistiche utili: il menu Statistiche contiene molte altre voci che forniscono dati specifici per protocollo e analisi più dettagliate, possono includere elementi come flussi di rete, utilizzi di banda, errori di trasmissione;
  • filtraggio automatico: una funzionalità particolarmente utile di ciascuna voce del menu Statistiche è la possibilità di costruire automaticamente filtri di visualizzazione basati sui dati analizzati.

I filtri di visualizzazione sono uno strumento essenziale in Wireshark per isolare specifiche parti del traffico di rete in base alle necessità di analisi. Questi filtri consentono di affinare la visualizzazione dei dati catturati, rendendo più efficiente l’analisi di grandi quantità di traffico (v. Appendice “Analizzare una cattura usando i filtri di visualizzazione”).

Identificati i pacchetti di interesse in Wireshark, il passo successivo è l’analisi approfondita dei dati che contengono. Wireshark offre un riquadro dedicato chiamato dettagli dei pacchetti, che consente di esplorare in dettaglio l’incapsulamento dei protocolli e i dati trasportati da ciascun pacchetto. I dettagli dei pacchetti sono organizzati gerarchicamente, rispecchiando l’incapsulamento dei protocolli all’interno del pacchetto. Questo permette di visualizzare ogni livello di dati, dal più esterno al più interno. Ecco un esempio tipico di come potrebbero essere strutturati i dettagli per un pacchetto contenente dati HTTP:

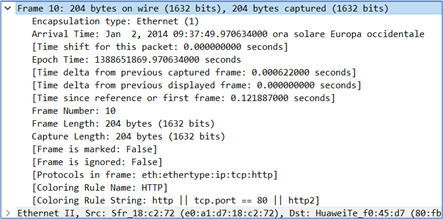
Figura 2 – Pacchetto frame
  • Frame: mostra il pacchetto dati catturato completo di tutti i metadati associati, come l’ora di cattura, la lunghezza del frame, e altre informazioni utili (Figura 2);
Figura 3 – Trama Ethernet II
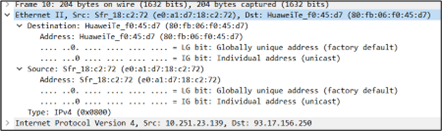
  • Ethernet II: mostra la trama Ethernet, il primo livello di incapsulamento, che include dettagli come l’indirizzo MAC sorgente e destinazione e il tipo di protocollo, tipicamente IP (Figura 3);
Figura 4 – Pacchetto IPv4
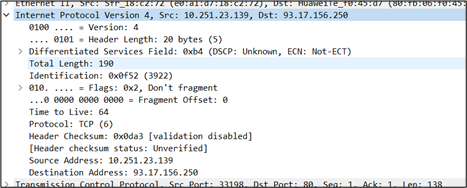
  • IP Version 4:il pacchetto IP incapsulato dentro la trama Ethernet. Mostra i dettagli come l’indirizzo IP sorgente e destinazione, la versione del protocollo, il tipo di servizio, e altri parametri relativi al protocollo IP (Figura 4);
Figura 5 – Segmento TCP
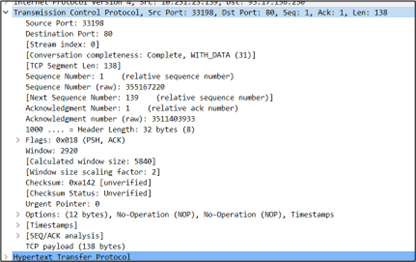
  • TCP: il segmento TCP incapsulato dentro il pacchetto IP, include informazioni come le porte sorgente e destinazione, i numeri di sequenza e di conferma, e altri dettagli relativi alla gestione della connessione TCP (Figura 5);
Figura 6 – HTTP
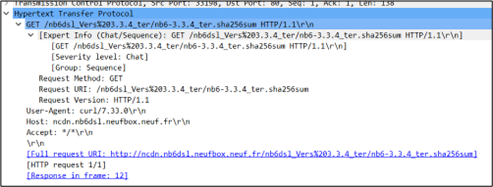
  • HTTP: l’unità di dati HTTP trasportata nel segmento TCP. Qui vengono visualizzate informazioni specifiche dell’HTTP, come il metodo di richiesta (GET, POST, ecc.), l’URL richiesto e gli header HTTP (Figura 6).

Nel vasto e complesso mondo delle reti, la capacità di monitorare e analizzare il traffico di rete è fondamentale per garantire la sicurezza, la stabilità e l’efficienza delle comunicazioni digitali. Wireshark offre gli strumenti necessari per esaminare dettagliatamente il flusso dei dati attraverso una rete, è in grado di catturare e visualizzare il contenuto dei pacchetti di rete in tempo reale, permettendo una profonda analisi di vari protocolli essenziali. Tra questi troviamo:

  • ARP risolve il problema di mappare un indirizzo IP, utilizzato nei pacchetti di rete, all’indirizzo MAC fisico della scheda di rete. L’analisi del traffico ARP è cruciale per (v. Appendice “Analizzare il traffico ARP utilizzando Wireshark”):

– identificare problemi di rete: come conflitti di indirizzi IP o problemi di risoluzione degli indirizzi;

– rilevare attività sospette: come attacchi di ARP spoofing o ARP poisoning, dove un malintenzionato potrebbe tentare di intercettare o alterare il traffico modificando le risposte ARP.

  • ICMP è fondamentale per la gestione e il debug delle reti IP. Viene spesso utilizzato per testare la connettività e tracciare il percorso dei pacchetti attraverso la rete ad esempio mediante i comandi come ping e traceroute (v. Appendice “Come analizzare i messaggi ICMP in Wireshark”)
  • TCP, UDP e porte associate. Quando si analizza il traffico di rete con Wireshark, è possibile vedere l’indirizzo IP e il numero di porta per i protocolli TCP e UDP in ogni pacchetto. Questo aiuta a identificare non solo l’origine e la destinazione dei dati a livello di rete, ma anche l’applicazione specifica a cui i dati sono destinati. L’identificazione delle porte utilizzate può fornire indizi vitali in scenari di troubleshooting di rete, sicurezza informatica e conformità di configurazione di rete (v. Appendice “Analisi di TCP e UDP in Wireshark”).
  • Domain Name System (DNS). Traduce i nomi di dominio facilmente memorizzabili in indirizzi IP numerici che le macchine possono comprendere e a cui possono connettersi (v. Appendice “Analisi del traffico DNS in Wireshark”):

– la maggior parte delle comunicazioni DNS avviene tramite UDP su porta 53, per la sua efficienza in termini di velocità e utilizzo ridotto delle risorse, ideale per le brevi query DNS;

– il DNS usa anche TCP, soprattutto per operazioni che richiedono affidabilità o per risposte che superano il limite di dimensione del pacchetto UDP (512 byte), come nei trasferimenti di zona tra server DNS.

– richiesta (Request): il client web invia una richiesta al server per ottenere dati o per inviare informazioni. Le richieste più comuni includono il metodo GET per richiedere dati e POST per inviare dati al server;

– risposta (Response): il server elabora la richiesta e invia una risposta al client. La risposta include uno status code che indica il successo o il fallimento della richiesta, dati (se richiesti), e header che forniscono informazioni aggiuntive.

  • HTTPS (HTTP Secure). Utilizza il protocollo Transport Layer Security (TLS) per cifrare le comunicazioni tra il client e il server, garantendo così privacy e sicurezza dei dati trasmessi. Wireshark può essere usato per analizzare il traffico TLS/SSL, sebbene il contenuto specifico delle comunicazioni sia cifrato e non direttamente leggibile (v. Appendice “Analisi del Traffico HTTPS e Decodifica di TLS in Wireshark”). La decodifica del traffico TLS in Wireshark richiede l’accesso alle chiavi di sessione, che non sono trasmesse in rete ma generate localmente da client e server durante l’handshake TLS. Per analizzare i dati HTTPS (nascosti dentro il livello TLS) è necessario esportare queste chiavi mentre il browser web stabilisce una connessione TLS (v. Appendice “Decodifica del traffico TLS in Wireshark utilizzando le chiavi di sessione”). Ogni protocollo ha un ruolo unico e critico nella facilitazione e nella sicurezza delle comunicazioni su Internet e l’analisi di questi protocolli attraverso Wireshark è cruciale per diagnosticare problemi di rete, ottimizzarne le prestazioni nonché a mitigare gli attacchi informatici.

La decodifica del traffico TLS in Wireshark richiede l’accesso alle chiavi di sessione, che non sono trasmesse in rete ma generate localmente da client e server durante l’handshake TLS. Per analizzare i dati HTTPS (nascosti dentro il livello TLS) è necessario esportare queste chiavi mentre il browser web stabilisce una connessione TLS. Ogni protocollo ha un ruolo unico e critico nella facilitazione e nella sicurezza delle comunicazioni su Internet e l’analisi di questi protocolli attraverso Wireshark è cruciale per diagnosticare problemi di rete, ottimizzarne le prestazioni nonché a mitigare gli attacchi informatici.

Oltre a Wireshark (v. Appendice “Wireshark – personalizzazione dell’area di lavoro” e Appendice “Wireshark – predisposizione dell’area di lavoro”), esistono diversi altri strumenti utili per l’analisi di file PCAP. Questi strumenti offrono funzionalità specializzate che possono completare o estendere le analisi effettuate con Wireshark, particolarmente utili per identificare minacce, analizzare malware, e visualizzare le connessioni di rete:

A-Packets, permette:

  • analisi generale: caricando un file PCAP su A-Packets, si ottiene un report dettagliato che include l’analisi dei protocolli di rete e i file presenti nel traffico;
  • estrazione di credenziali: il sito offre funzionalità per estrarre le credenziali che possono essere trasmesse nel traffico di rete;
  • visualizzazione di rete: mostra una rappresentazione grafica degli host e delle loro interconnessioni, facilitando la comprensione delle relazioni di rete.

Note: I file caricati su A-Packets diventano pubblicamente accessibili, quindi è importante considerare la sensibilità dei dati prima di utilizzare questo servizio.

Hybrid Analysis, permette:

  • analisi malware: focalizzata sulla verifica della presenza di malware nei file PCAP;
  • sandbox: offre una sandbox per l’analisi di sicurezza, che può essere utile per esaminare i file estratti dai PCAP in un ambiente controllato.

Note: i risultati sono generalmente molto sintetici e orientati esclusivamente all’identificazione di malware.

VirusTotal, permette:

  • analisi malware: VirusTotal analizza i file PCAP per la presenza di malware e fornisce risultati dettagliati;
  • analisi IDS: include un’analisi Intrusion Detection System (IDS) che può rilevare attività sospette o malevole;
  • Community: se il malware è noto, la sezione Community può fornire ulteriori informazioni utili condivise da altri utenti.

PacketTotal, permette:

  • analisi di rete: non si concentra sull’analisi di malware, ma offre strumenti per esaminare le connessioni di rete dentro il PCAP;
  • strumenti integrati: include funzionalità per il whois e la geolocalizzazione;
  • grafici del traffico: fornisce una rappresentazione grafica dello stream di dati, simile a quella di Wireshark, aiutando a visualizzare il flusso di traffico in maniera intuitiva.

Network Miner è un potente strumento forense che si specializza nell’estrarre e visualizzare informazioni dai file PCAP. È particolarmente utile per gli analisti che necessitano di un’analisi rapida e diretta delle comunicazioni di rete. Questo strumento è spesso usato in complemento a Wireshark per offrire una vista più orientata ai dati estratti piuttosto che alla pura analisi del traffico:

  • Hosts: mostra un elenco di host coinvolti nel traffico di rete;
  • Files: elenca i file trasferiti attraverso la rete, che possono essere esaminati o scaricati direttamente dall’interfaccia;
  • Sessions: fornisce una panoramica delle sessioni di comunicazione tra i dispositivi;
  • Credentials: rivela credenziali che potrebbero essere state trasmesse in chiaro.

ANY.RUN è un servizio di analisi malware basato su sandbox che permette agli utenti di eseguire file sospetti in un ambiente controllato e sicuro, garantisce:

  • ambiente isolato: utilizza una macchina virtuale (VM) Windows 7 per isolare il malware dal sistema operativo principale e dalla rete locale;
  • interattività: fornisce un ambiente interattivo, consentendo agli utenti di interagire direttamente con il sistema operativo della VM durante l’analisi;
  • monitoraggio in tempo reale: durante l’esecuzione del malware, ANY.RUN visualizza in tempo reale le connessioni di rete e l’albero dei processi generati dall’eseguibile;
  • community e database: gli utenti possono accedere a un database di analisi precedenti, che include i dettagli delle minacce più comuni e recenti, consentendo uno studio approfondito prima di iniziare nuove analisi.

CyberChef, sviluppato dall’agenzia di intelligence britannica GCHQ, è uno strumento versatile per l’analisi e la manipolazione di dati. Viene chiamato “il coltellino svizzero della cyber-security” vista la grande quantità di tools di cui dispone.

Tra le tante categorie di operazioni disponibili vi sono:

  • operatori aritmetici e logici;
  • conversione di formato;
  • codifica e decodifica, crittografia e hashing;
  • compressione e decompressione dati, strumenti di elaborazione grafica;
  • estrazione di dati, stringhe e files.

Wireshark – uso dei filtri di cattura

Wireshark è uno strumento estremamente potente per l’analisi di rete e comprendere come utilizzare efficacemente i filtri di cattura può significativamente migliorare l’efficienza delle sessioni di monitoraggio. Ecco una guida per configurare e applicare filtri di cattura.

Configurazione Iniziale

All’avvio, Wireshark mostra l’elenco delle interfacce di rete disponibili:

  • grafico dell’interfaccia: accanto a ciascuna interfaccia c’è un grafico che mostra l’attività di rete in tempo reale, facilitando l’identificazione delle interfacce attive;
    • avvio della cattura: un doppio clic su un’interfaccia avvia la cattura del traffico su quella specifica interfaccia.

Finestra opzioni di cattura

Per accedere:

  • dal menu Cattura selezionare Opzioni;
  • Selezione Multipla: seleziona più interfacce per la cattura simultanea;
  • File di Cattura: definisce un file per salvare i dati catturati, specifica una dimensione massima e imposta la rotazione del file per gestire grandi quantità di dati;
  • Risoluzione dei Nomi: abilita la risoluzione dei nomi per gli indirizzi IP e per il livello di trasporto, facilitando la lettura e l’analisi del traffico.

Filtri di cattura

A differenza dei filtri di visualizzazione, i filtri di cattura limitano i dati al momento dell’acquisizione. Ciò significa che i dati non corrispondenti al filtro non saranno disponibili in Wireshark dopo la cattura.

Come inserire un filtro di cattura:

  • nella finestra Opzioni di Cattura, vi è un campo dedicato ai filtri di cattura;
  • scegliere un filtro predefinito cliccando il nastro verde accanto al campo di inserimento o scrivere manualmente il filtro.

Esempi di filtri di cattura

  • Cattura traffico da un singolo host:

host 192.168.0.99

  • Cattura traffico da una rete specifica:

src net 10.1.0.0/16

oppure:

src net 10.1.0.0 mask 255.255.0.0

  • Cattura traffico HTTP diretto a una porta specifica:

tcp dst port 80

  • Escludere il traffico IP:

not ip

  • Cattura traffico non-broadcast:

not broadcast

  • Cattura pacchetti di dimensione specifica:

less 250

oppure:

greater 250 and ip

  • Cattura traffico da VLAN specifiche:

vlan 10 or vlan 20

  • Cattura traffico destinato a un MAC specifico:

ether dst 01:00:0c:cc:cc:cc

(torna su)

Analizzare una cattura usando i filtri di visualizzazione

La sintassi di base per creare un’espressione di filtraggio richiede la specifica di un protocollo seguito da un dettaglio del protocollo, utilizzando un formato protocollo.campo:

Esempio: ip.addr == 192.168.1.1 seleziona tutti i pacchetti che contengono l’indirizzo IP specificato, sia come mittente che come destinatario.

Gli operatori di confronto sono fondamentali nella costruzione dei filtri:

  • == oppure eq: uguale a;
  • != oppure neq: diverso da;
  • > oppure gt: maggiore di;
  • < oppure lt: minore di.

Per combinare più condizioni, si utilizzano gli operatori logici:

  • && oppure and: entrambe le condizioni devono essere soddisfatte;
  • || oppure or: una delle condizioni deve essere soddisfatta;

Esempio: ip.src == 192.168.1.151 && ip.dst == 62.10.45.151 seleziona solo il traffico dall’indirizzo IP sorgente al destinatario specificato.

Filtraggio per protocollo o porta

Per selezionare traffico specifico basato su protocolli o porte, si possono utilizzare espressioni come:

  • tcp.port == 80 || http: seleziona tutto il traffico HTTP.
  • udp.port == 53 || dns: seleziona tutte le query DNS.

Ricerca di stringhe con contains

L’operatore contains è utilizzato per cercare specifiche stringhe all’interno dei pacchetti:

Esempio: dns contains “google” trova tutti i pacchetti DNS che includono il termine “google”.

(torna su)

Analizzare il traffico ARP utilizzando Wireshark

Per analizzare il traffico ARP utilizzando Wireshark, seguire questi passaggi:

  1. Filtrare il Traffico ARP: digitare arp nella barra di filtraggio di Wireshark per isolare il traffico ARP. Questo filtro visualizzerà tutti i pacchetti ARP scambiati nella rete.
  2. Selezionare un Messaggio ARP: cliccare su un pacchetto ARP nell’elenco per visualizzarne i dettagli nel pannello dei dettagli.
  3. Esaminare i Dettagli del Messaggio ARP: nel Pannello dettagli, sotto la voce “Ethernet II”, vi è la sezione ARP che include i seguenti campi:
    1. Opcode: indica il tipo di messaggio ARP, dove 1 rappresenta una REQUEST e 2 un REPLY;

indirizzi IP e MAC: mostra gli indirizzi IP e MAC dell’host sorgente e del destinatario. Notare che l’ARP REQUEST è inviato al broadcast, cioè all’indirizzo MAC di destinazione ff:ff:ff:ff:ff:ff.

(torna su)

Come analizzare i messaggi ICMP in Wireshark

Per analizzare i Messaggi ICMP utilizzando Wireshark, seguire questi passaggi:

  1. filtrare il Traffico ICMP: digitare icmp nella barra di filtraggio di Wireshark per isolare solo il traffico ICMP;
  2. selezionare un pacchetto ICMP: nella lista dei pacchetti filtrati, selezionare un pacchetto che si desidera analizzare. I pacchetti di Echo Request e Echo Reply sono facilmente identificabili dai loro tipi;
  3. esaminare i dettagli dei pacchetti:
    1. nel pannello dei dettagli di Wireshark, cercare la sezione ICMP che si trova subito sotto la sezione di IPv4;
    1. osservare il campo Type per identificare il tipo di messaggio ICMP:
      1. Type 8: ICMP Echo Request;
      1. Type 0: ICMP Echo Reply;
    1. il Timestamp mostra l’orario esatto in cui il messaggio è stato inviato dall’host originale, che può essere utile per calcolare la latenza.

(torna su)

Analisi di TCP e UDP in Wireshark

Quando si utilizza Wireshark per analizzare il traffico di rete, comprendere le differenze tra TCP (Transmission Control Protocol) e UDP (User Datagram Protocol) è fondamentale per l’interpretazione dei dati di rete. Ecco come analizzare questi due protocolli cruciali usando Wireshark.

Filtraggio TCP e UDP

Per iniziare l’analisi:

  1. filtraggio: inserire tcp o udp nella barra di filtraggio di Wireshark per isolare il traffico corrispondente;
  2. selezione del pacchetto: scegliere un pacchetto per analizzare i dettagli nel pannello dei dettagli, immediatamente sotto il livello di IPv4.

Dettagli TCP in Wireshark

Con TCP, si troveranno informazioni dettagliate utili per monitorare e diagnosticare la connessione:

  • Sequence Number e Acknowledge Number: questi numeri sono cruciali per il controllo di flusso e per garantire che i dati siano trasmessi in modo affidabile e in ordine.
  • flags di TCP: i flags come SYN, ACK, e FIN sono utilizzati per gestire lo stato della connessione. Ad esempio:
    • SYN: utilizzato per iniziare una connessione;
    • SYN-ACK: risposta dal server per accettare la connessione;
    • ACK: utilizzato per confermare la ricezione dei pacchetti;
    • FIN: indica la chiusura di una connessione;
    • RST: quando l’handshake a tre vie non viene concluso correttamente, ad esempio per indisponibilità del servizio, il server restituirà altri messaggi di controllo, come il RST (reset).

L’analisi dei flags è importante per identificare il comportamento della connessione, come l’inizio e la conclusione delle sessioni TCP o possibili anomalie nelle connessioni di rete.

Seguire il Flusso TCP

Per una visione più dettagliata della comunicazione tra client e server:

  1. attivare “Segui il Flusso TCP”: dopo aver selezionato un pacchetto TCP, clic destro e selezionare “Segui” e poi “Flusso TCP”. Questo aprirà una nuova finestra con i dati trasmessi nel flusso TCP;
  2. analisi del dialogo: I dati vengono visualizzati con i messaggi del client in rosso e quelli del server in blu, facilitando la visualizzazione della conversazione tra i due;
  3. leggibilità dei dati: la facilità di lettura dei dati dipende dal protocollo di livello applicativo trasportato. Per esempio, il traffico HTTP è generalmente più facile da interpretare rispetto ad altri protocolli meno verbosi.

Dettagli UDP in Wireshark

UDP è meno complesso rispetto a TCP in quanto non stabilisce una connessione e non garantisce il controllo di flusso o la conferma di ricezione.

(torna su)

Analisi del traffico DNS con Wireshark

  1. filtraggio del Traffico DNS: per analizzare il traffico DNS in Wireshark, digitare dns nella barra di filtraggio per isolare solo i pacchetti DNS;
  2. esaminare le Query e le Risposte DNS:
    1. nel pannello dei dettagli di Wireshark, è possibile vedere la struttura delle query e delle risposte DNS. Questo include i nomi di dominio richiesti, i tipi di record (come A, AAAA, MX), gli indirizzi IP risolti, e altri dettagli DNS;
    1. ogni pacchetto DNS mostrerà se si tratta di una query o di una risposta e includerà dettagli come il numero di record nella risposta e gli eventuali errori (es. “Non-Existent Domain”).
  3. monitoraggio per anomalie:
    1. analizzare il traffico DNS può aiutare a identificare comportamenti anomali come attività di malware, che spesso utilizzano query DNS per comunicare con i server di comando e controllo;
    1. l’alta frequenza di query DNS fallite o un volume insolitamente elevato di query può essere indicativo di configurazioni errate o attività sospette.

(torna su)

Analisi del Traffico HTTP in Wireshark

Per analizzare il traffico HTTP in Wireshark:

  1. impostare il filtro: digitare http nella barra di filtraggio di Wireshark per visualizzare solo i pacchetti http;
  2. selezionare un pacchetto: cliccare su un pacchetto di interesse per visualizzare i dettagli nel pannello inferiore.

Dettagli del traffico HTTP in Wireshark

Nel pannello dettagli di Wireshark, sotto il livello TCP, si trova il livello HTTP che include:

  • Content-Type: indica il tipo di dati trasferiti, come text/html per le pagine web o application/json per dati in formato JSON;
  • Server: il software server che gestisce la richiesta;
  • Request URI: l’URI specifico richiesto dal client;
  • User-Agent: identifica il client web e il sistema operativo utilizzato per fare la richiesta;
  • Referrer: l’URL della pagina che ha originato la richiesta.

Seguire il flusso TCP

Per una visione completa della conversazione:

  1. selezionare “Segui Flusso TCP”: clic destro sul pacchetto quindi Analizza > Segui > Flusso TCP. Questo mostra l’intera conversazione tra client e server, inclusi tutti i dati trasmessi;
  2. analisi: la finestra del flusso TCP permette di leggere l’interazione completa, visualizzando i dati trasferiti e gli header HTTP in un formato leggibile.

Utilizzare il Menu Statistiche

Per una panoramica più ampia:

  • gerarchia di protocolli: nel menu Statistiche, selezionare Gerarchia di Protocolli per vedere una sintesi dei protocolli usati nella cattura, inclusi quelli trasportati via http;
  • esportazione di oggetti HTTP: Da File > Esporta Oggetti > HTTP, è possibile esportare elementi come immagini, fogli di stile e script che sono stati trasferiti via HTTP.

(torna su)

Analisi del traffico HTTPS e decodifica di TLS in Wireshark

Analisi di HTTPS – TLS in Wireshark

  1. filtrare il traffico TLS: inserire tls nella barra di filtraggio di Wireshark per isolare il traffico TLS;
  2. esaminare i dettagli TLS:
    1. nel pannello dettagli, sotto il livello TCP, si trova il livello TLS;
    1. HTTP nascosto: poiché il traffico HTTP è cifrato, non comparirà esplicitamente. Sarà indicato come “Encrypted Application Data”;
    1. dettagli TLS: analizzare i messaggi di “Client Hello” e “Server Hello” per vedere dettagli come la versione TLS, i metodi di cifratura negoziati e i numeri casuali usati per generare la chiave di sessione;
    1. chiave pubblica: nel certificato del server, si può vedere la chiave pubblica usata per la negoziazione della cifratura;
  3. visualizzazione di certificati e handshake: è possibile esaminare i certificati scambiati e i dettagli dei messaggi di handshake per avere un’idea di come viene stabilita la sicurezza prima di trasmettere dati sensibili.

Limitazioni nell’analisi di TLS in Wireshark

Decifrare i dati TLS: Wireshark non può decifrare i dati TLS senza le appropriate chiavi di decifrazione. Tuttavia, è possibile configurare Wireshark per decifrare il traffico TLS se si ha accesso alle chiavi di sessione o ai parametri di pre-master secret.

(torna su)

Decodifica del traffico TLS in Wireshark utilizzando le chiavi di sessione

Ecco come farlo utilizzando Firefox e configurando Wireshark per utilizzare il file di log delle chiavi.

Configurazione di Firefox per esportare le chiavi di sessione TLS

  • impostazione della variabile di ambiente SSLKEYLOGFILE:
    • chiudere Firefox e Wireshark: assicurarsi che entrambe le applicazioni siano chiuse prima di modificare le impostazioni;
    • aprire le impostazioni di sistema:
      • nel menu di Avvio cercare “env” o “environment variables”.
      • cliccare su “Modifica le variabili d’ambiente per il tuo account”;
    • aggiungere la variabile SSLKEYLOGFILE:
      • clicca su “Nuova…” per creare una nuova variabile d’ambiente;
      • assegnare come nome della variabile SSLKEYLOGFILE;
      • come valore della variabile, impostare un percorso per il file di log, ad esempio: %USERPROFILE%\Documents\sslkey.log.
    • salvare e chiudere: confermare e chiudi tutte le finestre di dialogo;
  • verifica della configurazione:
    • riaprire Firefox e visitare un sito HTTPS;
    • verificare che il file sslkey.log sia stato creato nel percorso specificato e controllare se contiene le chiavi di sessione;

Importazione delle chiavi di sessione in Wireshark

  1. avviare Wireshark e iniziare una cattura: avviare una cattura di rete in Wireshark mentre si usa Firefox per generare traffico HTTPS;
  2. configurazione delle preferenze di Wireshark per TLS:
    1. da Modifica → Preferenze → Protocols → TLS;
    1. trovare la voce “(Pre)-Master-Secret log filename” e cliccare su Sfoglia….
    1. selezionare il file sslkey.log che si è precedentemente configurato e confermare;
  3. analizzare il traffico decodificato:
    1. con le chiavi di sessione importate, Wireshark sarà in grado di decodificare il traffico TLS e mostrare i dati HTTP in chiaro;
    1. per esaminare un flusso di comunicazione specifico, cliccare con il tasto destro su un pacchetto e selezionare Segui → Flusso TLS o Flusso HTTP per visualizzare l’intera conversazione tra client e server.

(torna su)

Wireshark – personalizzazione dell’area di lavoro

Wireshark offre ampie possibilità di personalizzazione per adattarsi meglio alle esigenze specifiche di ciascun utente o tipo di analisi. La personalizzazione può aiutare a migliorare l’efficienza nell’analisi del traffico di rete.

Creazione e gestione dei profili di configurazione

  • Creare un nuovo profilo:
    • da Modifica → Profili di configurazione;
    • cliccare su Nuovo e assegnare un nome al nuovo profilo. Questo permette di personalizzare e salvare le impostazioni senza alterare il profilo Default.
  • Cambio del profilo: è possibile cambiare profilo ogni qual volta è necessario adattarsi a diversi scenari di analisi. Selezionare semplicemente il profilo desiderato dall’elenco nel menu dei profili di configurazione.
  • Esportazione e importazione di un profilo: questo è utile per trasferire le personalizzazioni su un’altra installazione di Wireshark. Dallo stesso menu dei profili, è possibile esportare un profilo e poi importarlo su un’altra macchina.

Modifica delle regole di colorazione

  • Accesso alle regole di colorazione:
    • da Visualizza → Regole di colorazione;
    • modificare le regole esistenti o aggiungerne di nuove cliccando sul simbolo +.
  • Personalizzazione dei colori: ogni regola è legata a un filtro di visualizzazione specifico. Definire il colore del testo e dello sfondo per rendere più intuitiva l’analisi visiva del traffico.

Configurazione delle colonne

  • Modifica delle colonne:
    • da Modifica → Preferenze → Aspetto;
    • eliminare colonne non necessarie o aggiungerne di nuove.
  • Aggiunta di nuove colonne:
    • assegna un nome alla nuova colonna e seleziona il dettaglio da visualizzare, come indirizzi IP o porte;
    • è possibile visualizzare i nomi risolti o mantenere i numeri con l’opzione resolved o unresolved.
  • Riorganizzazione delle colonne: è possibile trascina le colonne nella posizione desiderata per un’analisi più efficiente.

Memorizzazione dei filtri di visualizzazione

  • Aggiunta di filtri personalizzati:
    • utilizzare il pulsante + vicino alla barra di filtraggio per salvare i filtri utilizzati frequentemente.
    • assegnare un nome al filtro e, se necessario, aggiungere un commento per descriverne l’uso.
  • Utilizzo dei filtri salvati: i filtri salvati appariranno come pulsanti nella barra di filtraggio e saranno applicabili rapidamente con un clic.

(torna su)

Wireshark – predisposizione dell’area di lavoro

Per rafforzare la capacità di rilevamento di malware nel traffico di rete, è possibile configurare specificamente Wireshark per analizzare le sessioni HTTP e HTTPS:

Creazione di un nuovo profilo di configurazione: da Modifica → Profili di configurazione e creare un nuovo profilo, es. “Analyst”.

Modifica delle colonne per analisi HTTP/HTTPS

  • aprire le preferenze: da Modifica → Preferenze → Aspetto.
  • configurazione delle colonne: rimuovere le colonne non necessarie e aggiungere le seguenti per ottimizzare l’analisi del traffico web:
    • Time: imposta il formato su UTC per garantire che l’ora sia uniforme e confrontabile globalmente;
    • Src e Dst: aggiungere colonne per gli indirizzi IP sorgente e destinatario;
    • Port: colonne per le porte sorgente e destinatario, utili per identificare il tipo di traffico;
    • Host: una colonna personalizzata che usa il filtro http.host o tls.handshake.extensions_server_name per visualizzare i nomi dei server web.
    • Info: per dettagli generali sulla trasmissione.

Impostazioni di data e ora: assicurarsi che il tempo sia impostato su UTC per la consistenza attraverso il menu Visualizza → Formato visualizzazione tempo → Data e ora del tempo UTC.

Creazione di pulsanti di filtraggio

Usare il pulsante + accanto alla barra di filtraggio per creare filtri rapidi:

  • (http.request or tls.handshake.type eq 1) and !(ssdp): filtra le richieste HTTP e i nomi di dominio HTTPS, escludendo il traffico SSDP;
  • (http.request or tls.handshake.type eq 1 or tcp.flags eq 0x0002 or dns) and !(ssdp): aggiunge TCP SYN e DNS alle sessioni HTTP e HTTPS.

Analisi delle conversazioni di rete e ricerca di minacce

  • Gerarchia dei protocolli: da Statistiche → Gerarchia di protocolli per vedere la distribuzione dei dati tra i protocolli;
  • Endpoint e conversazioni: utilizzare le opzioni sotto Statistiche per visualizzare gli endpoint e le conversazioni, che possono aiutare a identificare i “top talkers” o le connessioni sospette.
  • HTTP Requests: Statistiche → HTTP → Richieste per un elenco di richieste a server web, che può rivelare connessioni a domini sconosciuti o maligni.

Uso avanzato dei filtri di visualizzazione

  • udp.port eq 67: visualizza i messaggi DHCP inviati dai client che contengono l’indirizzo IP, l’indirizzo MAC e l’hostname;
  • nbns: mostra il traffico Netbios utilizzato tipicamente dagli host Windows, utile per ricavare l’hostname degli endpoint;
  • http.request: mostra tutte le richieste di accesso ai server web, che contengono utili info;
  • udp and !(dns): visualizza le connessioni UDP non attinenti al trasporto di DNS;
  • dns.qry.name contains dominio: mostra le richieste di risoluzione per il dominio indicato;
  • frame contains “MZ” and frame contains “DOS”: trova il trasferimento di eseguibili Windows. Le stringhe specificate sono i cosiddetti magic numbers (o anche file signatures[1]), piccole sequenze di caratteri poste all’inizio di ogni file grazie alle quali è possibile identificare il tipo di file; il magic number MZ identifica un file eseguibile per Windows.
  • l’operatore matches: simile a contains ma abilita l’uso delle espressioni regolari:
    • frame matches “\.(?i)(exe|zip|doc|xls|ppt|jar)”: visualizza i pacchetti che contengono file;
    • frame matches “(?i)(username|password)”: trova i pacchetti con credenziali;
    • frame matches “User-Agent: Mozilla.*”: visualizza solo le richieste HTTP dei client Mozilla

Attivazione della geolocalizzazione con MaxMind

Durante la ricerca di una minaccia risulta utile avere informazioni sulla provenienza geografica ovvero la nazionalità degli host coinvolti nelle conversazioni di rete; di base Wireshark non fornisce tali informazioni ma possono essere integrati grazie al database fornito dal sito di MAXMIND:

  • download dei database MaxMind: registrarsi e scaricare i file .mmdb[2] da MaxMind;
  • configurazione in Wireshark:
    • da Modifica → Preferenze → Name Resolution;
    • aggiungere la directory contenente i file .mmdb.

Utilizzo dei Filtri di Display per la Geolocalizzazione

Completata l’attivazione dei file di database si troveranno subito le nuove informazioni:

  • nel pannello dettagli di un pacchetto selezionato, espandendo il livello IPv4;
  • nella finestra dedicata alle statistiche per i terminatori di rete (endpoint), scheda IPv4, il pulsante Mappa posto a sinistra nella finestra permette di osservare gli indirizzi IP su di una mappa geografica.

Wireshark permette di utilizzare i dati di geolocalizzazione per filtrare il traffico di rete in base alla località geografica:

  • questo filtro visualizza tutti i pacchetti che hanno origine o destinazione nella città di Roma:

ip.geoip.city == “Rome”

  • filtro specifico per la città di destinazione:

ip.geoip.dst_city == “Dublin”

  • filtro per nazione di destinazione:

ip.geoip.dst_country == “Italy”

(torna su)


[1] https://en.wikipedia.org/wiki/List_of_file_signatures

[2] GeoLite2 ASN, GeoLite2 City e GeoLite2 Country

Tor contro VPN

TOR (The Onion Router) e VPN (Virtual Private Network) sono entrambi strumenti che possono essere utilizzati per proteggere la privacy e la sicurezza online. Sebbene entrambi abbiano alcune somiglianze, presentano anche differenze fondamentali che li rendono più adatti a diversi tipi di utenti e a diversi tipi di attività online.

TOR (abbreviazione di The Onion Router) è un software gratuito e open source che consente agli utenti di navigare in Internet in modo anonimo. È stato sviluppato a metà degli anni ‘90 dal Laboratorio di Ricerca Navale statunitense come modo per proteggere le comunicazioni governative. Oggi TOR è utilizzato da una vasta gamma di persone, da giornalisti e attivisti a individui comuni che desiderano proteggere la propria privacy online.

TOR funziona crittografando il traffico Internet di un utente e instradandolo attraverso una rete di server gestiti da volontari, noti come “nodi”, prima di raggiungere la sua destinazione. Questo processo rende difficile per chiunque monitorare l’attività online di un utente o determinarne la posizione fisica.

Per utilizzare TOR, un utente deve semplicemente scaricare e installare il browser TOR, basato sul popolare browser Web Firefox. Una volta installato, il browser TOR consente all’utente di accedere a Internet proprio come farebbe con qualsiasi altro browser Web, ma con l’ulteriore protezione dell’anonimato.

Uno dei principali vantaggi dell’utilizzo di TOR è che fornisce un elevato livello di privacy e sicurezza. Poiché il traffico Internet dell’utente è crittografato e instradato attraverso più nodi, è molto difficile per chiunque monitorare la propria attività online o determinare la propria posizione. Ciò rende TOR uno strumento popolare per giornalisti e attivisti che potrebbero operare in paesi con governi repressivi, poiché consente loro di comunicare e condividere informazioni senza timore di essere monitorati o puniti.

Un altro vantaggio di TOR è che può aiutare gli utenti a aggirare la censura di Internet. In molti paesi, i governi censurano determinati siti Web o tipi di contenuti, rendendo impossibile agli utenti l’accesso. Ma con TOR, gli utenti possono accedere a questi siti web instradando il loro traffico attraverso nodi in altri paesi dove non si applica la censura.

Tuttavia, il TOR non è privo di inconvenienti. Poiché la rete fa affidamento su volontari per gestire i nodi, a volte può essere lenta e inaffidabile. Inoltre, poiché TOR è spesso associato ad attività criminali, alcuni siti Web potrebbero bloccare gli utenti che vi accedono tramite la rete TOR.

Una VPN, o rete privata virtuale, è uno strumento che aiuta a mantenere la tua attività online privata e sicura. Lo fa crittografando il tuo traffico Internet e instradandolo attraverso un server remoto sicuro prima che raggiunga la sua destinazione. Ciò rende difficile per chiunque vedere cosa si sta facendo online o monitorare le attività online.

Ci sono molte situazioni per cui un utente potrebbe voler utilizzare una VPN. Ad esempio, superare una rigorosa censura di Internet di alcuni Paesi per accedere a siti Web o servizi bloccati. Oppure connettersi su una rete Wi-Fi pubblica e voler proteggere i propri dati dall’intercettazione da parte di altri sulla stessa rete o da altre minacce crittografando il traffico Internet e instradandolo attraverso un server sicuro: quando ci si connette a una rete Wi-Fi pubblica, si espone potenzialmente il proprio dispositivo e i propri dati a una serie di minacce, come hacking o malware.

L’uso di una VPN può anche aiutare a proteggere la privacy online. Molti siti Web e servizi monitorano le attività online e raccolgono dati personali, che possono essere utilizzati per pubblicità mirata o addirittura venduti a terzi. Una VPN crittografa il traffico Internet, rendendo molto più difficile per queste aziende tracciare e raccogliere i dati.

Esistono molti provider VPN diversi tra cui scegliere: aspetti fondamentali da considerare quando si sceglie un provider VPN sono il livello di crittografia utilizzato, la posizione e il numero dei server, nonché le politiche sulla privacy e sulla registrazione.

Una delle principali differenze tra TOR e VPN è il modo in cui instradano il traffico Internet. TOR instrada il traffico attraverso più livelli di server, o “router a cipolla”, prima che raggiunga la destinazione. Ciò rende difficile per chiunque monitorare le attività online o determinare il vero indirizzo IP mittente.

D’altro canto, una VPN instrada il traffico attraverso un unico server sicuro. Questo server crittografa il traffico e assegna un nuovo indirizzo IP temporaneo, rendendo difficile per chiunque vedere cosa si sta facendo online o tracciare il vero indirizzo IP.

Un’altra differenza fondamentale tra TOR e VPN è il livello di crittografia che forniscono. TOR crittografa il traffico più volte mentre passa attraverso i router Onion, fornendo un livello di sicurezza molto elevato. Tuttavia, ciò significa anche che TOR può essere più lento della VPN, poiché il traffico deve passare attraverso più livelli di crittografia. D’altra parte, la VPN crittografa il traffico solo una volta, rendendolo più veloce di TOR. Tuttavia, ciò significa anche che la VPN potrebbe[1] fornire un livello di sicurezza inferiore rispetto a TOR, poiché il traffico viene crittografato solo una volta.


[1] Dipende dalla complessità della crittografia.

Individuazione dell’account ID

Breve raccolta di  procedure per l’individuazione dell’account ID

Il social network Facebook distingue tre tipologie di account:

  • Profilo
  • Pagina
  • Gruppo

Per individuare l’ID associato all’account Facebook occorre:

  • visualizzare la home dell’account, cliccare sulla stessa con il tasto destro del mouse e selezionare l’opzione “Visualizza sorgente pagina”;
  • cliccare CTRL+F e inserire le parole chiave “userID” (in caso di profilo), “pageID” (in caso di una pagina) e “groupID” (in caso di un gruppo);
  • cercare, nella pagina aperta CTRL + F,una delle parole chiave che sarà seguita da un codice numerico che rappresenta l’ID del profilo;

Per ulteriore conferma – una volta ricavato l’ID – provare su una nuova pagina l’url così composto: www.facebook.com/ID (inserire il numerico ricavato).

Per individuare l’ID associato all’account Tik Tok occorre:

  • visualizzare la home dell’account, cliccare sulla stessa con il tasto destro del mouse e selezionare l’opzione “Visualizza sorgente pagina”;
  • cliccare CTRL+F e inserire le parole chiave “uID”
  • cercare, nella pagina aperta CTRL + F,una delle parole chiave che sarà seguita da un codice numerico che rappresenta l’ID del profilo;

Accedere nell’account che – per Telegram – vengono distinti in:

  • utente
  • gruppo
  • supergruppo
  • canale privato

Andare in Search chats e inserire get_id_bot avendo come risposta: Your Chat ID is=ID (numerico ricavato).

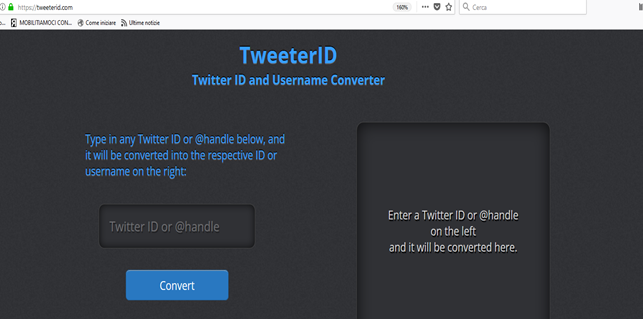
Per individuare l’ID associato ad un profilo twitter si può utilizzare il link https://tweeterid.com

Inserire nel campo di ricerca l’handle, cliccare convert e l’applicazione restituirà un codice numerico che rappresenta l’ID del profilo twitter.

Analogamente, se si conosce l’ID, inserendolo e cliccando convert si otterrà l’handle dell’account twitter.

Per individuare l’ID associato all’account Instagram occorre:

  • visualizzare la pagina del profilo di interesse, cliccare sulla stessa con il tasto destro del mouse e selezionare l’opzione “Visualizza sorgente pagina”;
  • cliccare CTRL+F e inserire le parole chiave “profilePage”;
  • cercare, nella pagina aperta CTRL + F,le parole chiave che saranno seguite come segue (page_id: profilePage_: ID) da un codice numerico che rappresenta l’identificativo del profilo.

 Link per trovare da ID a USERNAME https://commentpicker.com/instagram-username.php?utm_content=cmp-true

Link per trovare da  USERNAME a ID  https://commentpicker.com/instagram-user-id.php

Telegram e l’Internet libero

Telegram è un’applicazione di messaggistica focalizzata su velocità e sicurezza, è semplice e gratuita.

Telegram è sostenuto da Pavel Durov[1] e suo fratello Nikolai. Pavel supporta Telegram finanziariamente e ideologicamente, mentre il contributo di Nikolai è tecnologico.

Il team di sviluppo di Telegram ha la sua sede a Dubai e la maggior parte degli sviluppatori viene da San Pietroburgo. Il team di Telegram ha dovuto lasciare la Russia a causa delle normative legate al mondo IT, e ha cercato posizioni diverse come base, incluse Berlino, Londra e Singapore.

  • Una delle caratteristiche distintive di Telegram è la sua filosofia orientata alla privacy e alla sicurezza.
  • Supporta due livelli di crittografia[2]:
  •  crittografia server-client che è usata nelle Chat Cloud (chat private e di gruppo);
  • crittografia end-to-end: opzionale per le chat segrete che garantisce che solo mittente e il destinatario possano leggere i messaggi scambiati in una chat segreta. Non è abilitata di default.

Tutti i dati, a prescindere dal tipo, sono crittografati nella stessa maniera, sia che siano testi, media o altro tipo.

  • Chat segrete: le chat segrete sono chat cifrate end-to-end, che offrono una maggiore sicurezza per le conversazioni. In queste chat, i messaggi possono essere autodistrutti dopo un certo periodo di tempo o dopo la lettura e non permettono l’inoltro.  Un messaggio eliminato nella conversazione, viene eliminato anche “dall’altra parte”. Inoltre, per garantire una maggiore privacy, i messaggi scambiati non lasciano tracce sui server Telegram, non fanno parte del cloud di Telegram e vi si può accedere solo dal dispositivo di origine[3].
  • Cloud storage illimitato: offre uno spazio di archiviazione cloud gratuito e illimitato, rendendo facile il recupero dei dati in caso di perdita del dispositivo.
  • È basato sul cloud con sincronizzazione istantanea. Ciò consente di accedere ai propri messaggi da diversi dispositivi contemporaneamente e condividere un numero illimitato di file fino a 2 GB ciascuno.
  • Gruppi di chat: è possibile creare gruppi di chat fino a 200.000 partecipanti e condividerli con il mondo o mantenerli privati. Gli amministratori di gruppo hanno il controllo su chi può unirsi al gruppo e quali azioni possono essere seguite all’interno.
  • Canali Telegram: i canali sono simili ai gruppi, ma consentono agli amministratori di inviare messaggi in un solo senso, a un pubblico illimitato. Sono spesso usati per diffondere notizie, aggiornamenti e contenuti a un pubblico vasto.
  • Multi-piattaforma: Telegram è disponibile su diverse piattaforme, tra cui iOS, Android, Windows, macOS e anche come versione web.
  • Chiamate vocali e video: supporta chiamate vocali e video. Supporta inoltre le chiamate vocali con crittografia end-to-end.
  • Bot Telegram: è possibile aggiungere bot di terze parti alle proprie chat o ai propri gruppi per svolgere una varietà di compiti, come ricevere aggiornamenti meteo, notizie o eseguire attività automatizzate.
  • L’infrastruttura con più data center e la crittografia implementata, permette a Telegram di essere più veloce e molto più sicuro.
  • È possibile eliminare tutti i messaggi inviati o ricevuti in una chat individuale, mentre nei gruppi eliminare solo i propri messaggi. È possibile anche cancellare l’intera cronologia della chat individuale e del gruppo: i messaggi eliminati non lasciano traccia nella chat.

Gruppi e canali, le differenze

Sono entrambi strumenti di comunicazione che consentono agli utenti di condividere messaggi, contenuti e comunicare con altri membri. Tuttavia, ci sono alcune differenze chiave tra i due:

  • Interazione bidirezionale nei gruppi, unidirezionale nei canali
  • Gruppi: tutti i membri possono inviare messaggi e partecipare attivamente alla conversazione. Gli amministratori del gruppo possono moderare i messaggi e gestire i membri. È possibile attivare la cronologia permanente per consentire ai nuovi membri di accedere ai messaggi precedenti.
  • Canali: la comunicazione è unidirezionale. Gli amministratori o i proprietari del canale possono inviare messaggi, ma i membri possono solo leggere e reagire ai messaggi inviati.
  • Privacy e visibilità
  • Gruppi: possono essere pubblici o privati. Nei gruppi pubblici, chiunque può cercare e unirsi al gruppo, mentre nei gruppi privati, è necessario un invito da parte di un amministratore per partecipare (solitamente un link).
  • Canali: possono essere pubblici, il che significa che chiunque può iscriversi al canale senza bisogno di un invito. Per i canali privati occorre essere aggiunto dal creatore o avere un link di invito per unirsi.
  • Numeri di partecipanti
  • Gruppi: possono ospitare fino a 200.000 membri.
  • Canali: possono ospitare un numero virtualmente illimitato di iscritti.
  • Moderazione:
  • Gruppi: gli amministratori di gruppo hanno il controllo su chi può unirsi al gruppo, chi può inviare messaggi e quali azioni possono essere eseguite all’interno del gruppo. Possono rimuovere o bandire membri inappropriati o disturbatori.
  • Canali: gli amministratori dei canali possono moderare i commenti nei messaggi, ma non possono impedire a nessuno di iscriversi o di visualizzare i messaggi del canale.

Gli utenti

Gli utentiÈ possibile contattare un utente su Telegram attraverso il suo numero di telefono[4], altrimenti:

  • quando si è membri dello stesso gruppo;
  • se viene impostato un username pubblico altri utenti potranno usare la “ricerca globale” in base a quell’username;
  • se si sceglie di comparire nella sezione “Persone vicine”[5] (questa opzione è disattivata di default).

Inoltre:

  • non è necessario avere un username di Telegram e averne uno serve solamente perché le persone possano trovare quell’utente nella ricerca globale senza conoscere il numero telefonico;
  • è possibile avere solo un username di base e un numero qualsiasi di username collezionabili contemporaneamente. Questo vale anche per i gruppi pubblici e i canali pubblici. Gli username collezionabili[6] funzionano esattamente come gli username base, appaiono nei risultati della “ricerca globale”, e hanno i propri link dedicati che possono essere usati al di fuori di Telegram[7];
  • nessuno degli interlocutori vedrà gli altrui numeri telefonici a meno che questo non sia permesso nelle impostazioni della privacy;
  • è possibile eliminare l’account dalla pagina di disattivazione[8]. L’operazione rimuoverà permanentemente tutti i propri messaggi, i propri gruppi e i propri contatti. Tale azione deve essere confermata dal proprio account Telegram[9] e non può essere annullata. Infine, l’account Telegram viene eliminato dopo 6 mesi di inutilizzo[10].

Telegram ha due principi fondamentali quando si tratta di raccogliere ed elaborare dati privati:

  • non utilizza i dati personali per mostrare annunci pubblicitari;
  • conserva solo i dati di cui ha bisogno per funzionare come servizio di messaggistica sicuro e funzionale.

Nella fattispecie Telegram:

  • ai fini della legislazione applicabile sulla protezione dei dati, è il titolare del trattamento dei dati, responsabile dei dati personali quando si utilizzano i suoi servizi;
  • per i paesi dello Spazio Economico Europeo (SEE), poiché si trova al di fuori dello SEE, Telegram ha designato una terza parte: l’Ufficio Europeo per la Protezione dei Dati (EDPO) come rappresentante ai sensi dell’articolo 27 del GDPR. È possibile indirizzare all’EDPO qualsiasi domanda relativa al GDPR utilizzando il modulo di richiesta online all’indirizzo https://edpo.com/gdpr-data-request/ oppure scrivendo all’EDPO in Avenue Huart Hamoir 71, 1030 Bruxelles, Belgio;
  • tratta i dati personali sulla base del fatto che tale trattamento è necessario per garantire i propri interessi legittimi (tra cui: (1) fornire servizi efficaci e innovativi agli utenti; (2) rilevare, prevenire o altrimenti affrontare frodi o problemi di sicurezza in relazione alla fornitura di servizi), a meno che tali interessi non siano superati dall’interesse o dai diritti e libertà fondamentali che richiedono la protezione dei dati personali dell’utente.

Di seguito come Telegram utilizza e gestisce dati personali dell’utente:

  • dati dell’account di base: utilizza il numero di cellulare e i dati di base dell’account (ovvero: nome del profilo, immagine del profilo e informazioni), ma specifica che “…non vogliamo sapere il tuo vero nome, sesso, età o cosa ti piace” e non è necessario che il nickname sia il vero nome[11];
  • l’indirizzo di posta elettronica: quando si abilita la verifica in due passaggi per l’account o si archivia documenti utilizzando la funzione Telegram Passport, è possibile scegliere di impostare un’e-mail di recupero password. Questo indirizzo verrà utilizzato solo per l’invio di un codice di recupero password. In caso di accesso con Google o Apple, Telegram potrebbe chiedere ad alcuni utenti di fornire un indirizzo email per ricevere i codici di accesso via email anziché via SMS, in questo caso tale indirizzo email verrà archiviato separatamente dall’email di recupero e verrà utilizzato solo per l’invio dei codici di autenticazione per l’accesso all’account;
  • i messaggi: Telegram è un servizio cloud sul quale tutti i dati (messaggi, foto, video e documenti delle chat cloud), vengono archiviati e fortemente crittografati e le chiavi di crittografia sono archiviate in diversi altri data center in diverse giurisdizioni. In questo modo nessuno può accedere ai dati dell’utente.

Le chat segrete utilizzano la crittografia end-to-end, ciò significa che tutti i dati vengono crittografati con una chiave che solo mittente e destinatario conoscono. Non c’è modo per Telegram o chiunque altro senza accesso diretto al dispositivo di conoscere quei messaggi. Telegram non memorizza le chat segrete sui server e per tanto le chat segrete non sono disponibili nel cloud: è possibile accedere a quei messaggi solo dal dispositivo a o da cui sono stati inviati[12].

Oltre ai messaggi privati, Telegram supporta anche canali pubblici e gruppi pubblici. Tutte le chat pubbliche sono chat cloud e sono crittografate, sia in archiviazione che in transito;

  • numero di telefono e contatti: Telegram utilizza i numeri di telefono come identificatori univoci in modo che sia facile passare dagli SMS e da altre app di messaggistica e mantenere così la rete sociale. Telegram chiede il consenso prima di sincronizzare i contatti (solo numero e nome e cognome)[13];
  • dati sulla posizione: se si condivide una posizione in una chat, questi dati sulla posizione vengono trattati rispettivamente come altri messaggi nel cloud o nelle chat segrete;cookies: vengono utilizzati solo quelli necessari per operare e fornire i servizi sul web[14];
  • memorizzazione dei dati: per iscritti a Telegram dal Regno Unito o dallo Spazio Economico Europeo, i dati vengono archiviati in data center nei Paesi Bassi[15]. Tutti i dati vengono archiviati pesantemente crittografati in modo che nessuno possa accedere al loro contenuto.

In quanto un servizio cloud, Telegram elabora i dati per fornire la cronologia della chat cloud, inclusi messaggi, contenuti multimediali e file, a qualsiasi dispositivo di a scelta dell’utente senza la necessità di utilizzo di backup di terze parti.


  • Sicurezza e protezione: data l’enorme popolarità, per migliorare la sicurezza dell’account utente, nonché per prevenire spam, abusi e altre violazioni ai termini di servizio, Telegram potrebbe raccogliere metadati come l’indirizzo IP, i dispositivi e le app Telegram utilizzate, la cronologia delle modifiche al nome utente, ecc. Se raccolti, questi metadati possono essere conservati per un massimo di 12 mesi. I moderatori possono controllare i messaggi che sono stati segnalati loro dai loro destinatari, in caso accertata violazione su un messaggio inviato l’account mittente potrebbe essere limitato dal contattare estranei, temporaneamente o permanentemente. In caso di violazioni più gravi, l’account potrebbe essere bannato. Telegram può anche utilizzare algoritmi automatizzati per analizzare i messaggi nelle chat cloud per bloccare spam e phishing.
  • Nessuna pubblicità basata sui dati dell’utente: Telegram non utilizza i dati utente per il targeting degli annunci o altri scopi commerciali.I bot: Telegram ha un’API che consente agli sviluppatori di terze parti di creare bot, utilizzandoli, l’utente invierà alcuni dei propri dati dell’account pubblico ai rispettivi sviluppatori di bot di terze parti: nome utente e immagine/i del profilo.
  • I diritti riguardo ai dati personali forniti: ai sensi della legislazione applicabile sulla protezione dei dati, in determinate circostanze, l’utente ha i il diritto di:richiedere una copia di tutti i propri dati personali conservati e di trasmettere tale copia a un altro titolare del trattamento;cancellare o modificare i dati personali;limitare o opporsi al trattamento dei propri dati personali;correggere eventuali dati personali inesatti o incompleti.

Se Telegram riceve un’ordinanza del tribunale che conferma che un utente è sospettato di terrorismo, potrebbe divulgare l’indirizzo IP e numero di telefono alle autorità competenti. In tal caso, l’esecuzione di tale ordinanza verrà inclusa in un rapporto semestrale sulla trasparenza pubblicato all’indirizzo: https://t.me/transparency. Alla data di redazione di questo documento, 26/08/2024, non vi sono report per l’Italia:

Nota: affinché una decisione giudiziaria sia rilevante, deve provenire da un paese con un indice di democrazia sufficientemente alto per essere considerato una democrazia (https://en.wikipedia.org/wiki/Democracy_Index). Possono essere condivisi solo l’indirizzo IP e il numero di telefono.

Account

L’eliminazione di un account è possibile nella pagina di disattivazione. L’eliminazione dell’account rimuove tutti i messaggi, i contenuti multimediali, i contatti e ogni altro dato archiviato nel cloud di Telegram. Questa azione deve essere confermata tramite l’account Telegram e non può essere annullata. Per impostazione predefinita, se si smette di usare Telegram e non si è online per almeno 6 mesi, l’account verrà eliminato insieme a tutti i messaggi, i media, i contatti e ogni altro dato nel cloud di Telegram. Su Impostazioni è possibile modificare tale periodo;

Messaggi

  • nelle chat segrete, l’eliminazione di un messaggio indica sempre all’app dall’altra parte di eliminarlo;
  • nelle chat individuali qualsiasi parte può scegliere di eliminare qualsiasi messaggio, sia inviati che ricevuti, per entrambe le parti. Non c’è limite di tempo. Qualsiasi parte può anche scegliere di cancellare l’intera cronologia della chat per entrambe le parti, nel qual caso alle app verrà richiesto di rimuovere tutti i messaggi in quella chat, indipendentemente dal numero di messaggi conservati da uno dei partecipanti;
  • nei supergruppi e nei canali, l’eliminazione di un messaggio lo rimuove per tutti i partecipanti. I messaggi eliminati e le versioni originali dei messaggi modificati dei supergruppi vengono archiviati per 48 ore dopo l’eliminazione per poter essere visualizzati nel registro degli amministratori;
  • è possibile ordinare ai messaggi nelle chat segrete di autodistruggersi non appena viene letto. Allo scadere del timer, ad entrambi i dispositivi che partecipano ad una chat segreta viene richiesto di eliminare il messaggio (foto, video, ecc.).
  • Informativa sulla Privacy
  • @EURegulation per richiedere una copia di tutti i propri dati archiviati da Telegram o altre info sulla privacy dei dati;
  • contenuto illegale su Telegram[17]: i set di sticker, i canali e i bot su Telegram sono disponibili pubblicamente, se ritenuti illegali o pornografici è possibile segnalarli a abuse@telegram.org;
  • set di sticker che violano i diritti di proprietà intellettuale: dmca@telegram.org;
  • inviare una richiesta relativa al Regolamento UE 2021/784: il Regolamento (UE) 2021/784 del Parlamento europeo e del Consiglio, del 29 aprile 2021, relativo al contrasto della diffusione di contenuti terroristici online (Terrorist Content Online Regulation, o regolamento TCO), consente alle autorità dei Paesi dell’UE di inviare richieste di rimozione di contenuti terroristici, se scoperti sulla piattaforma pubblica di Telegram; quest’ultimo inoltre ha designato una terza parte, l’European Digital Services Representative (EDSR), per assistere nelle comunicazioni relative al TCO. Gli utenti le cui pubblicazioni sono state rimosse in seguito al regolamento TCO possono richiedere dettagli sul motivo per cui le loro pubblicazioni sono state considerate terroristiche e su come contestare la rimozione:
    • scrivendo a EDSR, Avenue Huart Hamoir 71, 1030 Bruxelles, Belgio;
    • contattando il bot @EURegulation su Telegram e usando il comando /tco_ask.
  • stopCA@telegram.org: per segnalare abusi sui minori. Mentre t.me/stopCA è il canale che pubblica aggiornamenti giornalieri sui contenuti vietati relativi alle CA – Child Abuse.

[1] https://it.wikipedia.org/wiki/Pavel_Durov

[2] Basata sulla crittografia AES simmetrica a 256-bit, sulla crittografia RSA 2048 e sullo scambio di chiavi di sicurezza Diffie-Hellman.

[3] Tutte le chat segrete su Telegram sono specifiche del dispositivo e non fanno parte del cloud di Telegram. Questo significa che vi si può accedere solo dal dispositivo di origine.

[4] Il numero di telefono è l’unico modo per identificare un utente Telegram. Telegram non raccoglie ulteriori informazioni sull’utente, quindi chi ha il numero ha l’account.

[5] Persone vicine è una funzione opzionale che permette agli utenti di Telegram di scoprire i gruppi locali, trovare amici con cui chattare nella loro zona, o scambiare rapidamente contatti con chi si trova nelle vicinanze. Nota: Persone vicine non è mai attivo di default – gli utenti devono abilitarlo manualmente.

[6] Gli username collezionabili possono essere acquistati e venduti attraverso la piattaforma d’asta Fragment, uno strumento per acquisire e scambiare domini Telegram di valore. L’acquisto di un username tramite la piattaforma conferisce una proprietà permanente, verificata dalla blockchain TON. I proprietari di username collezionabili possono liberamente assegnarli alle chat, venderli ad altri o conservarli per un uso successivo.

[7] username.t.me e t.me/username.

[8] https://my.telegram.org/auth?to=delete

[9] Verrà ricevuto un codice via Telegram e non via SMS,

[10] Assieme a tutti i messaggi, media, contatti e ogni altro dato archiviato nel cloud di Telegram. È possibile cambiare tale periodo.

[11] Tieni presente che gli utenti che ti hanno tra i loro contatti ti vedranno con il nome che hanno salvato e non con il tuo nickname. In questo modo tua madre può avere il nome pubblico “Johnny Depp” mentre appare come “mamma” per te.

[12] I media nelle chat segrete: prima di essere caricato, ogni elemento viene crittografato con una chiave separata, non nota al server. Questa chiave e la posizione del file vengono quindi nuovamente crittografate, questa volta con la chiave della chat segreta e inviate al destinatario. Ciò significa che tecnicamente il file si trova su uno dei server di Telegram, ma a tutti tranne che al mittente e al destinatario sembra un pezzo di spazzatura indecifrabile e casuale. Telegram elimina periodicamente questi dati casuali dai server per risparmiare spazio.

[13] È possibile interrompere la sincronizzazione dei contatti o eliminarli dai server Telegram: Impostazioni > Privacy e sicurezza > Contatti.

[14] Il browser utilizzato dall’utente, inoltre, consente di controllare questi cookie, incluso se accettarli o meno e come rimuoverli.

[15] Si tratta di data center forniti da terze parti in cui Telegram affitta uno spazio designato, tuttavia, i server e le reti che si trovano all’interno di questi data center e su cui sono archiviati i dati personali sono di proprietà di Telegram. Pertanto, non vengono condivisi i dati personali con tali data center.

[16] https://telegram.org/privacy/eu

[17] Tutte le chat e i gruppi di Telegram sono territorio privato dei loro rispettivi partecipanti. Telegram non eseguirà alcuna richiesta relativa ad esse.


Diritto dei dati – Tutela giurisdizionale e amministrativa

Tutela amministrativa e giurisdizionale. Ruolo del Garante privacy e poteri di indagine e correttivi. Sanzioni amministrative pecuniarie, accessorie e risarcimento del danno. Big data e dati non personali.

La tutela giurisdizionale e amministrativa, ovvero come in qualche modo ci si tutela di fronte ad una violazione del trattamento, dei principi del trattamento, comunque in generale delle regole sul trattamento dei dati personali disposte dal GDPR. Andiamo quindi a vedere le regole di cui agli articoli 77 e seguenti del GDPR che prevedono diversi strumenti di tutela. A tutela di cosa? Ovviamente dei diritti dell’interessato che è sempre il soggetto di cui ci dobbiamo accertare che il trattamento sia eseguito in modo corretto. In particolare le forme di tutela, appunto, sono tre. La prima, articolo 77, è la tutela in via amministrativa di fronte a quella che il GDPR chiama l’autorità di controllo. L’autorità di controllo che interviene rispetto ad un trattamento che viola il GDPR è nel nostro ordinamento il Garante Privacy, quindi l’Autorità per la protezione per il trattamento dei dati personali e che chiamiamo in generale o l’autorità o il garante. Quindi tutela amministrativa di fronte all’Autorità garante della privacy. Un secondo profilo di tutela, articolo 78, tutela in via giurisdizionale, quindi di fronte al giudice, rispetto ad una decisione dell’autorità. Quindi quando l’Autorità prende una decisione poi ci si può rivolgere al giudice perché intervenga in seconda battuta rispetto alla decisione presa appunto dall’Autorità. Ultima forma di tutela, di nuovo in via giurisdizionale, quindi di fronte al giudice, per l’esercizio di un diritto riconosciuto dal GDPR. Quindi direttamente mi rivolgo al giudice per far valere un diritto che il GDPR mi riconosce. Innanzitutto partiamo dall’autorità. Qual è l’autorità? Perché ovviamente noi siamo di fronte al GDPR, quindi di fronte a un Regolamento che vale in tutti i Paesi dell’Unione europea. Per individuare l’autorità competente quindi andremo ad applicare il cosiddetto criterio di prossimità con l’interessato, quindi per riconoscere qual è l’autorità competente a intervenire rispetto ad una nostra supposta violazione, quella che noi riteniamo essere una violazione del GDPR andremo a rivolgerci all’autorità o del luogo dove noi come interessati risiediamo, quindi il luogo di residenza abituale dell’interessato, oppure il luogo in cui l’interessato lavora, in alternativa, oppure ancora il luogo in cui è stata effettuata la violazione. Perché la violazione ovviamente inerisce al trattamento e quindi andiamo a rivolgerci all’autorità del luogo in cui il trattamento ha concretamente luogo, quindi se quel certo titolare ha il suo stabilimento in un certo Paese noi ci rivolgeremo all’autorità di quel Paese. Rispetto invece all’autorità giudiziaria, quindi quando adiamo il giudice, quando scegliamo la tutela giurisdizionale, anche qui la regola è quella del rivolgerci al tribunale del luogo in cui il titolare ha lo stabilimento, quindi del luogo in cui si realizza il trattamento di dati oppure il luogo in cui l’interessato ha la sua residenza. Ciò a meno che il titolare non sia una autorità pubblica, quindi se il titolare invece è l’autorità pubblica, allora ci rivolgiamo al giudice del luogo in cui ha sede l’autorità in questione.

Ci soffermiamo sulla tutela dei dati personali all’interno del quadro normativo del Regolamento Generale sulla Protezione dei Dati (GDPR) e la sua implementazione nel diritto italiano, particolarmente attraverso il Codice Privacy aggiornato con il decreto legislativo 101 del 2018. Esploriamo la figura dell’Autorità di controllo, in Italia rappresentata dal Garante per la protezione dei dati personali, e le modalità con cui gli individui possono rivolgersi a questa autorità o al sistema giudiziario per far valere i propri diritti.

Il GDPR prevede strumenti specifici per la tutela dei diritti degli interessati, iniziando con la possibilità di presentare un reclamo amministrativo all’Autorità di controllo qualora si ritenga che sia stata violata la normativa sulla protezione dei dati. Se l’Autorità prende una decisione che non soddisfa l’interessato, quest’ultimo ha il diritto di rivolgersi al sistema giurisdizionale per impugnare tale decisione. Inoltre, esiste la possibilità di avviare azioni giurisdizionali dirette per esercitare i diritti riconosciuti dal GDPR, come il diritto di accesso ai dati, o per ottenere un risarcimento in caso di danni subiti a seguito di violazioni del regolamento.

Un aspetto importante è il principio di alternatività degli strumenti di tutela introdotto dall’articolo 140 bis del Codice Privacy. Questo principio stabilisce che la scelta di una via di tutela (amministrativa o giurisdizionale) preclude automaticamente l’uso dell’altra per lo stesso motivo, a meno che non siano presenti condizioni particolari, come il mancato riscontro da parte del Garante entro i termini massimi stabiliti.

Un accenno, inoltre, alla questione delle sanzioni amministrative pecuniarie, che devono essere effettive, proporzionate e dissuasive, seguendo i criteri stabiliti dall’articolo 83 del GDPR. Viene sottolineato il ruolo del Garante, che può esercitare una varietà di poteri correttivi, da semplici ammonimenti a sanzioni pecuniarie, per garantire la conformità al regolamento.

Diamo un’occhiata ora alle implicazioni più ampie della protezione dei dati nell’era digitale, quando toccano temi come i big data e la distinzione tra dati personali e non personali. In particolare, come il trattamento di grandi volumi di dati spesso unisce informazioni di natura diversa, sollevando sfide significative per quanto riguarda la protezione e l’autodeterminazione degli individui. Questo contesto richiede una regolamentazione che bilanci efficacemente le esigenze economiche e i diritti fondamentali delle persone, una sfida che continua a evolvere con il progresso tecnologico. Le implicazioni dei big data, un concetto che si riferisce all’immensa quantità di dati generati costantemente dall’interazione tra persone e tecnologie digitali. Il trattamento dei big data presenta una serie di sfide particolari per la protezione dei dati personali, poiché spesso combina dati personali e non personali, rendendo il confine tra questi due tipi sempre più sfumato. Il GDPR, che si focalizza sulla protezione dei dati personali, trova applicazione anche nei contesti in cui i dati non personali e personali si intrecciano così strettamente da non poter essere distinti. Questo è particolarmente rilevante in contesti in cui il trattamento di enormi volumi di dati da parte delle tecnologie digitali può influenzare decisioni che hanno impatti diretti sugli individui, come nel caso delle raccomandazioni personalizzate o delle previsioni comportamentali.

L’analisi dei big data può permettere alle organizzazioni di scoprire pattern e tendenze nascoste nei comportamenti umani, offrendo così possibilità predittive che possono essere usate in vari settori, dalla pubblicità al monitoraggio della salute. Queste capacità predittive, tuttavia, sollevano questioni significative riguardo al consenso e alla trasparenza. Per esempio, le persone sono veramente consapevoli e in grado di autorizzare l’uso dei loro dati quando accettano i termini di servizio di app o piattaforme che fanno largo uso di algoritmi di analisi?

Inoltre, l’accento va posto anche su come la normativa europea stia evolvendo per rispondere a questi cambiamenti. Un esempio è il Data Act, un regolamento dell’UE recentemente proposto che mira a regolamentare non solo i dati personali ma anche i dati non personali, riflettendo così la crescente importanza economica e sociale di entrambi i tipi di dati. Questo regolamento si propone di garantire che i dati siano trattati in modo equo e trasparente, cercando di bilanciare le esigenze del mercato digitale con i diritti fondamentali delle persone.

In conclusione, il trattamento dei big data impone una riflessione critica su come le informazioni vengono utilizzate e sulla necessità di garantire che i diritti alla privacy e all’autodeterminazione informativa rimangano centrali nel contesto di una società sempre più guidata dai dati.

Come gestire array RAID

Come gestire gli array RAID con mdadm su Ubuntu 22.04

Gli array RAID forniscono prestazioni e ridondanza migliorate combinando singoli dischi in dispositivi di archiviazione virtuali in configurazioni specifiche. In Linux, l’utility mdadmcrea e gestisce array RAID software.

In questa guida eseguirai diverse configurazioni RAID che possono essere configurate utilizzando un server Ubuntu 22.04.

Per seguire questa guida, avrai bisogno dell’accesso a un utente non-root sudo.

Come accennato, questa guida riguarderà la gestione dell’array RAID. Segui la guida su come creare array RAID con mdadmsu Ubuntu 22.04 per creare uno o più array prima di continuare a leggere. Questa guida presuppone che tu abbia uno o più array su cui operare.

Uno dei requisiti più essenziali per una corretta gestione è la capacità di reperire informazioni sulla struttura, sui dispositivi che lo compongono e sullo stato attuale dell’array.

Per informazioni dettagliate su un dispositivo RAID, passare il dispositivo RAID con l’opzione -Do --detaila mdadm:

sudo mdadm -D /dev/md0

Verranno visualizzate informazioni importanti sull’array:

Output/dev/md0:
           Version : 1.2
     Creation Time : Thu Sep 29 17:07:10 2022
        Raid Level : raid10
        Array Size : 209582080 (199.87 GiB 214.61 GB)
     Used Dev Size : 104791040 (99.94 GiB 107.31 GB)
      Raid Devices : 4
     Total Devices : 4
       Persistence : Superblock is persistent

       Update Time : Thu Sep 29 17:08:24 2022
             State : clean, resyncing
    Active Devices : 4
   Working Devices : 4
    Failed Devices : 0
     Spare Devices : 0

            Layout : near=2
        Chunk Size : 512K

Consistency Policy : resync

              Name : raid2:0  (local to host raid2)
              UUID : 8069bcc7:72e7b49f:fba1c780:560a85e0
            Events : 35

    Number   Major   Minor   RaidDevice State
       0       8        0        0      active sync set-A   /dev/sda
       1       8       16        1      active sync set-B   /dev/sdb
       2       8       32        2      active sync set-A   /dev/sdc
       3       8       48        3      active sync set-B   /dev/sdd

L’output rivela il livello RAID, la dimensione dell’array, lo stato dei singoli pezzi, il file UUIDdell’array, i dispositivi componenti e i loro ruoli.

Per i dettagli abbreviati di un array, adatti per l’aggiunta al file /dev/mdadm/mdadm.conf, puoi passare il flag --briefO -bcon la vista dettagliata:

sudo mdadm -Db /dev/md0

Output
/dev/md0: 199.88GiB raid10 4 devices, 0 spares. Use mdadm --detail for more detail.

Questo può essere utilizzato per trovare a colpo d’occhio le informazioni chiave su un dispositivo RAID.

Ottenere informazioni sui dispositivi componenti

Puoi anche usare mdadmper interrogare i singoli dispositivi componenti.

L’opzione -Q, se utilizzata con un dispositivo componente, ti dirà l’array di cui fa parte e il suo ruolo:

sudo mdadm -Q /dev/sdc

Output
/dev/sdc: is not an md array
/dev/sdc: device 2 in 4 device active raid10 /dev/md0.  Use mdadm --examine for more detail.

È possibile ottenere informazioni più dettagliate utilizzando le opzioni -Eo --examine:

sudo mdadm -E /dev/sdc

Output
/dev/sdc:
          Magic : a92b4efc
        Version : 1.2
    Feature Map : 0x0
     Array UUID : 8069bcc7:72e7b49f:fba1c780:560a85e0
           Name : RAID2204:0  (local to host RAID2204)
  Creation Time : Wed Oct  5 15:56:03 2022
     Raid Level : raid10
   Raid Devices : 4

 Avail Dev Size : 209582080 sectors (99.94 GiB 107.31 GB)
     Array Size : 209582080 KiB (199.87 GiB 214.61 GB)
    Data Offset : 133120 sectors
   Super Offset : 8 sectors
   Unused Space : before=132968 sectors, after=0 sectors
          State : clean
    Device UUID : 027f74c5:6d488509:64844c7a:add75d88

    Update Time : Wed Oct  5 16:13:57 2022
  Bad Block Log : 512 entries available at offset 136 sectors
       Checksum : 98edf3ae - correct
         Events : 35

         Layout : near=2
     Chunk Size : 512K

   Device Role : Active device 2
   Array State : AAAA ('A' == active, '.' == missing, 'R' == replacing)

Queste informazioni sono simili a quelle visualizzate quando si utilizza l’opzione -Dcon il dispositivo dell’array, ma focalizzata sulla relazione del dispositivo componente con l’array.

Leggere le informazioni su /proc/mdstat

Per informazioni dettagliate su ciascuno degli array assemblati sul tuo server, controlla il file /proc/mdstat. Questo è spesso il modo migliore per trovare lo stato corrente degli array attivi sul tuo sistema:

cat /proc/mdstat

Output
Personalities : [linear] [multipath] [raid0] [raid1] [raid6] [raid5] [raid4] [raid10] 
md0 : active raid10 sdd[3] sdc[2] sdb[1] sda[0]
      209584128 blocks super 1.2 512K chunks 2 near-copies [4/4] [UUUU]
      
unused devices: <none>

L’output qui è piuttosto denso e fornisce molte informazioni in una piccola quantità di spazio:

Personalities : [linear] [multipath] [raid0] [raid1] [raid6] [raid5] [raid4] [raid10] 
. . .

La riga Personalitiesdescrive i diversi livelli RAID e le configurazioni attualmente supportate dal kernel.

La riga che inizia con md0descrive l’inizio della descrizione di un dispositivo RAID. Le righe rientrate che seguono descrivono anche questo dispositivo:

. . .
md0 : active raid10 sdd[3] sdc[2] sdb[1] sda[0]
. . .

La prima riga indica che l’array è attivo, non difettoso e configurato come RAID 10. Successivamente vengono elencati i dispositivi componenti utilizzati per costruire l’array. I numeri tra parentesi descrivono il ruolo attuale del dispositivo nell’array. Ciò influisce su quali copie dei dati vengono fornite al dispositivo.

. . .
      209584128 blocks super 1.2 512K chunks 2 near-copies [4/4] [UUUU]
. . .

La seconda riga visualizzata in questo esempio fornisce il numero di blocchi forniti dai dispositivi virtuali, la versione dei metadati (1.2 in questo esempio) e la dimensione del blocco dell’array. Poiché si tratta di un array RAID 10, include anche informazioni sul layout dell’array. In questo esempio, è stato configurato per memorizzare due copie di ogni blocco di dati nel layout near.

Gli ultimi elementi tra parentesi quadre rappresentano entrambi i dispositivi attualmente disponibili di un set integro. Il primo numero tra parentesi numeriche indica la dimensione di un array integro mentre il secondo numero rappresenta il numero di dispositivi attualmente disponibili. Le altre parentesi sono un’indicazione visiva dello stato dell’array, con Uche rappresentano dispositivi sani e _che rappresentano dispositivi difettosi.

Se il tuo array è attualmente in fase di assemblaggio o ripristino, potresti avere un’altra riga che mostra l’avanzamento:

. . .
      [>....................]  resync =  0.9% (2032768/209584128) finish=15.3min speed=225863K/sec
. . .

Descrive l’operazione applicata e lo stato di avanzamento attuale in diversi modi. Fornisce inoltre la velocità attuale e un tempo stimato fino al completamento.

Una volta che ti sei fatto un’idea di quali array sono attualmente in esecuzione sul tuo sistema, puoi intraprendere una serie di azioni.

Per arrestare un array, il primo passo è smontarlo.

Esci dalla directory montata con il comando cd ~:

cd ~

Quindi smonta il dispositivo:

sudo umount /mnt/md0

Puoi interrompere tutti gli array attivi eseguendo:

sudo mdadm --stop --scan

Se vuoi fermare un array specifico, passalo al comando mdadm --stop:

sudo mdadm --stop /dev/md0

Questo fermerà l’array. Dovrai riassemblare l’array per accedervi nuovamente.

Per avviare tutti gli array definiti nei file di configurazione o /proc/mdstat, esegui quanto segue:

sudo mdadm --assemble --scan

Per avviare un array specifico, puoi passarlo come argomento a mdadm --assemble:

sudo mdadm --assemble /dev/md0

Funziona se l’array è definito nel file di configurazione.

Se nel file di configurazione manca la definizione corretta dell’array, l’array può comunque essere avviato passando i dispositivi componenti:

sudo mdadm --assemble /dev/md0 /dev/sda /dev/sdb /dev/sdc /dev/sdd

Una volta assemblato l’array, è possibile montarlo come al solito:

sudo mount /dev/md0 /mnt/md0

È possibile aggiungere dispositivi di riserva a qualsiasi array che offra ridondanza, come RAID 1, 5, 6 o 10. I dispositivi di riserva non verranno utilizzati attivamente dall’array a meno che un dispositivo attivo non si guasti. Quando ciò accade, l’array risincronizzerà i dati sull’unità di riserva per ripristinare l’integrità dell’array. Non è possibile aggiungere ricambi agli array non ridondanti (RAID 0) poiché l’array non sopravvivrà al guasto di un’unità.

Per aggiungere un dispositivo di riserva, passare l’array e il nuovo dispositivo al comando mdadm --add:

sudo mdadm /dev/md0 --add /dev/sde

Se l’array non è in uno stato degradato, il nuovo dispositivo verrà aggiunto come riserva. Se il dispositivo è attualmente danneggiato, inizierà immediatamente l’operazione di risincronizzazione utilizzando l’unità di riserva per sostituire l’unità difettosa.

Dopo aver aggiunto un ricambio, aggiorna il file di configurazione per riflettere il nuovo orientamento del dispositivo:

sudo nano /etc/mdadm/mdadm.conf

Rimuovi o commenta la riga corrente che corrisponde alla definizione dell’array:

. . .
# ARRAY /dev/md0 metadata=1.2 name=mdadmwrite:0 UUID=d81c843b:4d96d9fc:5f3f499c:6ee99294

Successivamente, aggiungi la configurazione corrente:

sudo mdadm --detail --brief /dev/md0 | sudo tee -a /etc/mdadm/mdadm.conf

Le nuove informazioni verranno utilizzate dall’utility mdadmper assemblare l’array.

È possibile espandere un array aumentando il numero di dispositivi attivi all’interno dell’assieme. La procedura esatta dipende leggermente dal livello RAID che stai utilizzando.

Con RAID 1 o 10

Inizia aggiungendo il nuovo dispositivo come riserva, come dimostrato nell’ultima sezione:

sudo mdadm /dev/md0 --add /dev/sde

Scopri il numero attuale di dispositivi RAID nell’array:

sudo mdadm --detail /dev/md0

Output
/dev/md0:
        Version : 1.2
  Creation Time : Wed Aug 10 15:29:26 2016
     Raid Level : raid1
     Array Size : 104792064 (99.94 GiB 107.31 GB)
  Used Dev Size : 104792064 (99.94 GiB 107.31 GB)
   Raid Devices : 2
  Total Devices : 3
    Persistence : Superblock is persistent

    . . .

In questo esempio, l’array è configurato per utilizzare attivamente due dispositivi. Rivela, tuttavia, che il numero totale di dispositivi disponibili nell’array è tre a causa della riserva.

Ora riconfigura l’array per avere un dispositivo attivo aggiuntivo. La riserva verrà utilizzata per soddisfare i requisiti di drive extra. Ricorda di sostituire il numero di destinazione dei dispositivi RAID in questo comando. Qui stiamo aumentando il RAID 1 con 2 dispositivi a 3. Se sei nel RAID 10 con 4 dispositivi e hai l’unità aggiuntiva, aumentala a 5:

sudo mdadm --grow --raid-devices=3 /dev/md0

L’array inizierà a riconfigurarsi con un disco attivo aggiuntivo. Per visualizzare l’avanzamento della sincronizzazione dei dati, eseguire quanto segue:

cat /proc/mdstat

Puoi continuare a utilizzare il dispositivo una volta completato il processo.

Con RAID 5 o 6

Inizia aggiungendo il nuovo dispositivo come ricambio come dimostrato nell’ultima sezione:

sudo mdadm /dev/md0 --add /dev/sde

Scopri il numero attuale di dispositivi RAID nell’array:

sudo mdadm --detail /dev/md0

Output
/dev/md0:
        Version : 1.2
  Creation Time : Wed Oct 5 18:38:51 2022
     Raid Level : raid5
     Array Size : 209584128 (199.88 GiB 214.61 GB)
  Used Dev Size : 104792064 (99.94 GiB 107.31 GB)
   Raid Devices : 3
  Total Devices : 4
    Persistence : Superblock is persistent

    . . .

In questo esempio, l’array è configurato per utilizzare attivamente tre dispositivi e il numero totale di dispositivi disponibili nell’array è quattro a causa del dispositivo di riserva aggiunto.

Ora riconfigura l’array per avere un dispositivo attivo aggiuntivo. La riserva verrà utilizzata per soddisfare i requisiti di drive extra. Quando si espande un array RAID 5 o RAID 6, è importante includere un’opzione aggiuntiva denominata --backup-file. Ciò indicherà una posizione fuori dall’array in cui verrà archiviato un file di backup contenente informazioni critiche:

sudo mdadm --grow --raid-devices=4 --backup-file=/root/md0_grow.bak /dev/md0

Il seguente output indica che verrà eseguito il backup della sezione critica:

Output
mdadm: Need to backup 3072K of critical section..

L’array inizierà a riconfigurarsi con un disco attivo aggiuntivo. Per visualizzare l’avanzamento della sincronizzazione dei dati, eseguire:

cat /proc/mdstat

Puoi continuare a utilizzare il dispositivo una volta completato questo processo.

Una volta completata la rimodellazione, dovrai espandere il filesystem sull’array per utilizzare lo spazio aggiuntivo:

sudo resize2fs /dev/md0

Il tuo array avrà ora un filesystem che corrisponde alla sua capacità.

Con RAID 0

Gli array RAID 0 non possono avere unità di riserva perché non esiste alcuna possibilità per una riserva di ricostruire un array RAID 0 danneggiato. È necessario aggiungere il nuovo dispositivo contemporaneamente all’espansione dell’array.

Innanzitutto, scopri il numero corrente di dispositivi RAID nell’array:

sudo mdadm --detail /dev/md0

Output
/dev/md0:
        Version : 1.2
  Creation Time : Wed Aug 10 19:17:14 2020
     Raid Level : raid0
     Array Size : 209584128 (199.88 GiB 214.61 GB)
   Raid Devices : 2
  Total Devices : 2
    Persistence : Superblock is persistent

    . . .

Ora puoi incrementare il numero di dispositivi RAID nella stessa operazione di aggiunta della nuova unità:

sudo mdadm --grow /dev/md0 --raid-devices=3 --add /dev/sdc

Riceverai un output che indica che l’array è stato modificato in RAID 4:

Output
mdadm: level of /dev/md0 changed to raid4
mdadm: added /dev/sdc

Questo è normale e previsto. L’array tornerà al RAID 0 quando i dati saranno stati ridistribuiti su tutti i dischi esistenti.

Puoi controllare lo stato di avanzamento dell’azione:

cat /proc/mdstat

Una volta completata la sincronizzazione, ridimensiona il filesystem per utilizzare lo spazio aggiuntivo:

sudo resize2fs /dev/md0

Il tuo array avrà ora un filesystem che corrisponde alla sua capacità.

Talvolta è necessario rimuovere un’unità da un array RAID in caso di guasto o se è necessario sostituire il disco.

Per poter rimuovere un dispositivo, è necessario prima contrassegnarlo come “guasto” all’interno dell’array. Puoi verificare se è presente un dispositivo guasto utilizzando mdadm --detail:

sudo mdadm --detail /dev/md0

Output
/dev/md0:
        Version : 1.2
  Creation Time : Wed Aug 10 21:42:12 2020
     Raid Level : raid5
     Array Size : 209584128 (199.88 GiB 214.61 GB)
  Used Dev Size : 104792064 (99.94 GiB 107.31 GB)
   Raid Devices : 3
  Total Devices : 3
    Persistence : Superblock is persistent

    Update Time : Thu Aug 11 14:10:43 2020
          State : clean, degraded 
 Active Devices : 2
Working Devices : 2
 Failed Devices : 1
  Spare Devices : 0

         Layout : left-symmetric
     Chunk Size : 64K

           Name : mdadmwrite:0  (local to host mdadmwrite)
           UUID : bf7a711b:b3aa9440:40d2c12e:79824706
         Events : 144

    Number   Major   Minor   RaidDevice State
       0       0        0        0      removed
       1       8        0        1      active sync   /dev/sda
       2       8       16        2      active sync   /dev/sdb
       0       8       32        -      faulty   /dev/sdc

Tutte le linee evidenziate indicano che un’unità non funziona più. Come esempio, /dev/sdcin questo output rivela che l’unità è difettosa.

Se è necessario rimuovere un’unità che non presenta problemi, è possibile contrassegnarla manualmente come guasta con l’opzione--fail:

sudo mdadm /dev/md0 --fail /dev/sdc

Output
mdadm: set /dev/sdc faulty in /dev/md0

È quindi possibile sostituirlo con una nuova unità, utilizzando lo stesso comando mdadm --addche usi per aggiungere un ricambio:

sudo mdadm /dev/md0 --add /dev/sdd

Output
mdadm: added /dev/sdd

L’array inizierà il ripristino copiando i dati sulla nuova unità.

Per distruggere un array, compresi tutti i dati in esso contenuti, iniziare seguendo il processo utilizzato per arrestare un array.

Esci dalla directory montata con il seguente comando:

cd ~

Quindi smonta il filesystem:

sudo umount /mnt/md0

Quindi, interrompi l’array:

sudo mdadm --stop /dev/md0

Successivamente, elimina l’array stesso con il comando --removedestinato al dispositivo RAID:

sudo mdadm --remove /dev/md0

Una volta rimosso l’array stesso, utilizzare mdadm --zero-superblocksu ciascuno dei dispositivi componenti. Questo cancellerà il superblocco md, un’intestazione utilizzata da mdadmper assemblare e gestire i dispositivi componenti come parte di un array. Se è ancora presente, potrebbe causare problemi quando si tenta di riutilizzare il disco per altri scopi.

Controlla la colonna FSTYPE nell’output lsblk --fsper confermare che il superblocco è presente nell’array:

lsblk --fs

Output
NAME    FSTYPE            LABEL        UUID                                 MOUNTPOINT
…
sda     linux_raid_member mdadmwrite:0 bf7a711b-b3aa-9440-40d2-c12e79824706 
sdb     linux_raid_member mdadmwrite:0 bf7a711b-b3aa-9440-40d2-c12e79824706 
sdc     linux_raid_member mdadmwrite:0 bf7a711b-b3aa-9440-40d2-c12e79824706 
sdd                                                                         
vda                                                                         
├─vda1  ext4              DOROOT       4f8b85db-8c11-422b-83c4-c74195f67b91 /
└─vda15

In questo esempio, /dev/sda, /dev/sdb e /dev/sdcfacevano tutti parte dell’array e sono ancora etichettati come tali.

Rimuovere le etichette con il seguente comando:

sudo mdadm --zero-superblock /dev/sda /dev/sdb /dev/sdc

Successivamente, assicurati di rimuovere o commentare qualsiasi riferimento all’array nel file /etc/fstab. Puoi farlo aggiungendo il simbolo dell’hashtag #all’inizio:

sudo nano /etc/fstab

. . .
# /dev/md0 /mnt/md0 ext4 defaults,nofail,discard 0 0

Salva e chiudi il file quando hai finito.

Rimuovere o commentare eventuali riferimenti all’array anche dal file /etc/mdadm/mdadm.conf:

nano /etc/mdadm/mdadm.conf

# ARRAY /dev/md0 metadata=1.2 name=mdadmwrite:0 UUID=bf7a711b:b3aa9440:40d2c12e:79824706

Salva e chiudi il file quando hai finito.

Quindi aggiorna l’initramfs:

sudo update-initramfs -u

Ciò rimuoverà il dispositivo dall’ambiente di avvio iniziale.

Diritto dei dati – I dati personali dei minori

Minori e privacy. Età del consenso digitale e liceità del trattamento, identità personale, intervento dell’esercente la responsabilità genitoriale. Riferimenti a casi giurisprudenziali.

L’articolo 8 del GDPR riguarda il tema dei dati personali dei minori. Quindi facciamo un focus proprio sui minori di età, i soggetti under 18. È un tema che da alcuni punti di vista può sembrare ovvio, il fatto che si parli di dati personali di minori di età, ma in realtà è una cosa relativamente nuova perché prima del GDPR non era previsto nulla che riguardasse in modo specifico il modo in cui si trattano i dati personali dei minori. È una novità del GDPR, a cui poi ha fatto seguito ovviamente il coordinamento da parte del legislatore italiano con il decreto legislativo 101 del 2018. Però è anche un tema abbastanza nuovo per motivi diversi. Sicuramente quello più immediato è il contesto storico di riferimento di questa normativa, normativa del 2016. Però ovviamente la specifica attenzione ai minori è data dal fatto che negli ultimi anni, nell’ultimo decennio, i minori di età hanno una possibilità di accedere a strumenti, computer, telefoni, tablet e così via, che permettono di trattare direttamente i loro dati personali. Quindi l’esigenza di tutela specifica del minore non più in generale come soggetto da tutelare al pari anche dell’adulto, ma come soggetto da tutelare in modo più specifico e più dettagliato perché proprio per le vulnerabilità che caratterizzano la minore età è necessario apprestare degli strumenti di tutela ad hoc, proprio perché non si può paragonare il minore all’adulto rispetto a quella che è la consapevolezza dell’utilizzo degli strumenti digitali, proprio perché nel nostro ordinamento c’è un’attenzione rispetto al minore in quanto tale, in quanto soggetto che deve godere di una tutela specifica anche dal punto di vista del trattamento dei dati personali. Quindi in qualche modo abbiamo un passaggio dovuto proprio all’utilizzo di quelli che vengono chiamati i nuovi media. Quindi se rispetto al passato, se rispetto al momento storico si tutelava la riservatezza in quanto tale e quindi anche la riservatezza del minore veniva tutelata di fronte all’utilizzo delle figure, riferimenti delle figure dei minori rispetto a quello che poteva essere diffuso sui giornali o in televisione, l’utilizzo dei nuovi media e cioè di tutte quelle tecnologie che utilizzano i dati personali, ha richiesto questa attenzione in più. La logica quando noi parliamo di minori di età è sempre quella di dover prestare attenzione, la massima attenzione al processo di formazione dell’identità personale, mentre per un adulto questa formazione può dirsi conclusa o comunque si può continuare a realizzare in delle modalità che sicuramente sono più consapevoli, il minore è per antonomasia il soggetto la cui identità personale è in divenire, è informazione, è infatti un processo, parliamo di formazione, di costruzione dell’identità personale e il punto di vista che si adotta è che l’utilizzo degli strumenti digitali che i minori utilizzano sia ormai talmente diffuso nella quotidianità del minore che lo può utilizzare per svago, per studio. Pensiamo anche ai tempi pandemici a come il minore più che in altre in altre occasioni era perennemente di fronte ad uno schermo, questo utilizzo sempre più diffuso, pensiamo anche a quanto sempre di più i minori utilizzino gli strumenti tecnologici anche dei genitori o pensiamo a tutti gli strumenti che sono proprio nelle case, tutta una serie di strumenti dell’Internet of Things, tutta una serie di strumenti che i minori hanno a disposizione in modo semplicissimo. Però interagendo con tutti questi strumenti, inevitabilmente, l’utilizzo degli strumenti che sono connessi alla rete e quello che poi è il modo in cui i dati vengono trattati e quindi le risposte che la rete da al minore stesso che la utilizza sono tali da essere in grado di incidere sulla formazione dell’identità personale. Proprio rispetto a questo elemento è necessario prestare delle tutele nuove, un’attenzione nuova. Il tema dell’attenzione alla privacy in senso ampio del minore, comunque, non è completamente nuovo. Perché di privacy del minore si inizia a parlare addirittura nell’89, quindi in tempi abbastanza risalenti, ben prima della diffusione della rete per come la conosciamo oggi, però la Convenzione di New York che è la Convenzione sui diritti del fanciullo del 1989, poi ratificata in Italia nel 91, più o meno in quello stesso periodo, prevede che il minore debba essere tutelato da qualsiasi interferenza arbitraria o illegale nella sua vita privata, nella sua famiglia, nella sua corrispondenza, in generale, nella sua privacy. Ricordiamoci che anni 80, anni 90 siamo ancora in una concezione di privacy come riservatezza, principalmente. Quindi il riconoscimento di questa tutela da qualsiasi interferenza arbitraria o illegale, quindi qualsiasi tipo di intromissione dall’esterno che può incidere appunto sulla sua vita privata, sulla sua famiglia, sul suo domicilio, sulla sua corrispondenza e addirittura va oltre perché dice e neppure di affronti illegali contro il suo onore e la sua reputazione, quindi in tutte le varie sfaccettature della riservatezza che abbiamo già descritto, e questa è la disposizione dell’articolo 16 della Convenzione di New York. In più, l’articolo 17, non parlando della riservatezza, però dice che il minore deve essere garantito, il fanciullo anzi dice la convenzione, deve essere garantito rispetto all’accesso ai media e alle tecnologie. Quindi vediamo come pure in un tempo in cui ancora non si parlava di privacy come trattamento dei dati personali distinto dalla riservatezza, abbiamo un’attenzione particolare nei confronti del minore: da un lato dal punto di vista della tutela della sua sfera più intima, dall’altro si cerca di incentivare l’accesso dei minori, dei fanciulli verso l’utilizzo delle tecnologie, del tipo di tecnologie che si potevano creare anche in prospettiva futura. E quindi questa doppia anima da un lato di tutela particolarmente mirata verso la riservatezza, dall’altro questo riconoscimento del minore come soggetto che deve poter accedere alle tecnologie perché è qualcosa che sicuramente può essere utile ai fini del suo sviluppo ai fini della sua crescita. Quindi in qualche modo viene veicolata dalla Convenzione di New York dell’89 un’immagine abbastanza moderna del minore come soggetto che poteva incidere sul proprio processo educativo, formativo, proprio anche attraverso l’utilizzo delle delle tecnologie.

Da un punto di vista di diritto interno, in realtà di privacy del minore non abbiamo per lungo tempo nessun tipo di riferimento. Un riferimento era però presente già nel codice di procedura penale: in particolare l’articolo 114 del codice di procedura penale, in forza del quale si tutelava il minore attraverso un divieto di pubblicazione delle sue generalità e delle sue immagini. Quelli che oggi chiamiamo dati perché sicuramente le generalità di una persona o l’immagine di una persona rientrano nella nozione di dati. Quindi il divieto di pubblicare informazioni come generalità e immagini che ritraessero dei minori che fossero coinvolti in senso ampio da un procedimento di fronte all’autorità giudiziaria penale e quindi che fossero testimoni, persone offese, danneggiati dal reato, insomma qualsiasi tipo di situazione attorno alla quale potesse posizionarsi la figura di un minore rispetto ad un procedimento penale, quanto meno fino al momento in cui non avessero raggiunto questi minori la maggiore età. Quindi una tutela di fronte a insomma alla circolazione delle notizie riferite a determinati procedimenti penali che coinvolgessero dei minori. In un secondo momento il codice della privacy, quindi siamo nel 2003, estende questa stessa tutela che il codice di procedura penale prevedeva rispetto ai procedimenti penali, a qualsiasi altro procedimento di fronte all’autorità giudiziaria. Quindi a livello proprio di riservatezza del minore si ha questa particolare attenzione. Attenzione che tra l’altro era prevista anche all’interno dei codici deontologici di alcune categorie professionali, in particolare il Codice deontologico dell’attività giornalistica che è molto legato ovviamente ai temi dei procedimenti giudiziari. E nel codice deontologico dell’attività giornalistica che è del 96, già si faceva riferimento in particolare all’articolo 7, al fatto che il giornalista, dal punto di vista deontologico, non dovesse procedere alla pubblicazione dei nomi dei minori coinvolti in fatti di cronaca e comunque non soltanto i nomi, qualsiasi tipo di informazione che potesse permettere poi di ricondurre alla sua identificazione. Perché la logica che viene sancita, il principio che viene sancito in questo codice deontologico dell’attività giornalistica è che la riservatezza del minore deve essere tutelata anche quando ci sono delle ragioni che giustificano il diritto di cronaca. Quindi quando si svolge attività di cronaca, attività di critica, comunque bisogna prestare la massima attenzione al minore. Ovviamente tutte queste cose poi sono sì previste nel codice, però poi sono oggetto delle pronunce giurisprudenziali della Cassazione. La Suprema Corte ad esempio nel 2013 si esprime espressamente nel senso di richiedere che nell’ambito dell’attività giornalistica sia doveroso evitare qualsiasi riferimento che possa ledere la riservatezza dei minori. Quindi proprio questa attenzione che anche ovviamente a livello di giurisprudenza si ha sempre rispetto a queste categorie più vulnerabili di soggetti che appunto anche quando si esercita il diritto di cronaca, il diritto di critica è sempre necessario che siano destinatari di una specifica attenzione. A tutto ciò ovviamente non sta attenta soltanto la giurisprudenza ma anche il Garante privacy, in particolare con tutta una serie di provvedimenti, ne riporto uno del 2001, quindi in un tempo anche precedente al Codice della privacy ma successivo al Codice deontologico dell’attività giornalistica del 96, perché proprio già nel 2001, quindi in tempi non sospetti rispetto all’utilizzo, al riconoscimento del diritto alla protezione dei dati personali, comunque si faceva riferimento al diritto alla riservatezza dei minori anche di fronte alle notizie o a fatti di cronaca riportati che riguardano personaggi noti. Quindi anche prima della Cassazione, già il Garante riconosceva l’assoluta necessità di fare attenzione a tutelare i figli anche rispetto a fatti che riguardano soggetti noti nel caso di specie era figlio di un di un parlamentare, perché in tutti questi casi non si deve per far valere il diritto di critica, il diritto di cronaca, non si deve mai perciò affievolire quello che è il diritto alla privacy dei soggetti che sono coinvolti, a maggior ragione appunto se i soggetti in questione sono dei minori. Insomma, già prima del GDPR, per quanto non si facesse riferimento esplicito alla tutela di minori nel trattamento di dati personali, comunque si faceva particolare attenzione a garantire che il minore non subisse delle interferenze idonee ad incidere negativamente, ad impattare negativamente sulla formazione della sua identità personale.

Passiamo quindi al GDPR. Già nei considerando del GDPR sono presenti una serie di riferimenti espliciti ai minori. In particolare, la logica che seguono i considerando è che quando si ha di fronte al trattamento dei dati personali dei minori di età, è necessario rendersi conto che si è di fronte ad un soggetto che è meno consapevole del significato della portata che il trattamento dei suoi dati può avere e dei rischi che quindi ciò può comportare, quindi è necessario prestare attenzione alla sua personalità. Il considerando 38, ad esempio, dice espressamente che i minori meritano una specifica protezione perché sono meno consapevoli dei rischi di Internet. Devono essere particolarmente tutelati da misure di salvaguardia che permettano l’esercizio dei loro diritti di fronte a qualsiasi attività di trattamento dei loro dati personali. In particolare si richiede attenzione di fronte a tutte quelle attività di trattamento dei dati personali che hanno finalità di marketing, oppure che svolgono attività di profilazione del minore, perché ovviamente profilare il minore al fine di rivolgergli, per esempio, delle determinate pubblicità mirate e personalizzate rispetto alle sue preferenze può incidere effettivamente sulla sua sfera giuridica soggettiva e quindi è necessaria una specifica attenzione. Ancora, il considerando 65 fa riferimento all’esercizio del diritto all’oblio e dedica un passaggio anche al minore perché addirittura: dice che il diritto all’oblio è particolarmente fondamentale che sia riconosciuto nei confronti del minore nel momento in cui acquista l’età del consenso digitale, perché potrebbe volerlo esercitare rispetto ad un consenso al trattamento dei dati personali prestato quando era al di sotto della soglia dell’età del consenso digitale e quindi era meno consapevole, sotto quell’età, e quindi una volta che compie l’età del consenso digitale deve riconfermare il consenso già prestato e altrimenti esercitare il diritto all’oblio rispetto ai dati che erano stati trattati, aveva consentito che venissero trattati prima del compimento dell’età per il consenso digitale. Ancora un altro considerando è il considerando 58 che fa riferimento in generale al principio di trasparenza e che quando descrive il principio di trasparenza dice rispetto ai minori è necessaria una particolare protezione, una protezione specifica, perché il minore è meno consapevole e quindi deve ricevere delle informazioni che riguardano il trattamento, che devono essere elaborate in un linguaggio particolarmente chiaro, particolarmente semplice, proprio perché devono essere dei termini che anche il minore possa facilmente comprendere. Insomma già nei considerando troviamo delle linee di attenzione alla figura del minore rispetto all’adulto. Poi vi è la norma che è espressamente dedicata al minore, è la norma di cui all’articolo 8. Già nella rubrica dell’articolo 8 del GDPR, la rubrica è il titolo della norma, dice: condizioni applicabili al consenso dei minori in relazione ai servizi della società dell’informazione. E poi ci sono i tre paragrafi dell’articolo 8 che ci descrivono la disciplina. Innanzitutto si fa riferimento appunto nella rubrica ai servizi della società dell’informazione. Diciamo che la definizione di servizi della società dell’informazione è contenuta in una direttiva del 2015, la 1535 del 2015 dice che i servizi della società dell’informazione sono tutti i servizi prestati a distanza, normalmente dietro una retribuzione e per via elettronica nei confronti di un destinatario dei servizi stessi. Diciamo che in generale sono un po’ tutte le attività che vengono svolte in rete che possono consentire l’accesso alle informazioni o ad attività di comunicazione. Quindi sono servizi della società dell’informazione: la posta elettronica, i social network, le banche dati, le newsletter. Vediamo quindi la norma perché si fa riferimento alle condizioni applicabili al loro consenso. Quindi, innanzitutto parliamo del consenso dei minori. Infatti il paragrafo 1 dice qualora si applichi l’articolo 6, paragrafo 1, lettera a, che è la condizione di liceità del trattamento che si fonda sulla prestazione del consenso. Quindi, innanzitutto, rispetto al minore è fondamentale che ci sia il suo consenso alla luce delle precisazioni che vengono fatte in questo articolo. Allora sempre il paragrafo 1 fa riferimento all’offerta diretta dei servizi della società dell’informazione. Questo riferimento all’offerta diretta vuol dire che la disciplina dell’articolo 8 non si applica a tutti i servizi della società dell’informazione, ma si applica soltanto a quelli che sono offerti in modo diretto ai minori. Quindi se sono il titolare di un trattamento ed esplicito che il servizio che offro è rivolto soltanto ai maggiorenni, allora non sono tenuto ad applicare le regole di quell’articolo 8. Ovviamente nella misura in cui, pur se io lo dovessi esplicitare, questa esplicitazione non venga poi smentita da altri elementi. Per esempio, il fatto che sia un tipo di servizio che per il contenuto che ha è evidente che verrà utilizzato anche da dei minori. Il problema è che il GDPR non ci dà delle precisazioni rispetto a come individuare quali siano gli elementi che possono smentire il fatto che il servizio sia offerto soltanto ai maggiorenni. Da questo punto di vista, quindi, possiamo fare riferimento un po’ al dato comparatistico, possiamo guardare all’esperienza statunitense che è un’esperienza in cui invece vengono espressamente delineati alcuni fattori, alcuni esempi, che sono utili a capire quando un certo servizio sia destinato o meno ai minori di età. E in particolare guardiamo alla disciplina in materia statunitense che è facile ricordare con l’acronimo COPPA che sta per Children’s Online Privacy Protection Act, che è la disciplina statunitense sulla privacy dei minori e che descrive una serie di fattori che ci permettono di capire se il servizio è offerto in modo diretto ai minori o meno, a prescindere appunto da quello che poi il titolare possa sostenere. E questi fattori sono per esempio il contenuto del sito, il tipo di attività che viene svolta su quel sito e il tipo di contenuti che sono fruibili su un certo sito, contenuti audio o contenuti visivi o il fatto che ci siano delle pubblicità che sono rivolte ad un target di bambini o comunque di soggetti minori, o il fatto che all’interno del sito, insomma del servizio, ci siano dei riferimenti a personaggi famosi tra i più piccoli o insomma celebrità che sono facilmente riconoscibili per i bambini o il fatto che ci siano dei modelli o dei soggetti a loro volta di minore età. Quindi,tutta una serie di esempi che effettivamente creano un contesto digitale a misura di bambino o comunque a misura di minore. Tutti questi fattori possono contribuire a ritenere che quel certo servizio sia effettivamente destinato, rivolto a dei soggetti minori. Questo è descritto nella disciplina statunitense, però sono dei parametri, delle linee che effettivamente poi facendo riferimento al dato comparatistico, anche il Garante privacy di qualsiasi Stato europeo o il giudice può sicuramente guardare a questi come esempi utili anche nella propria attività svolta a livello nazionale ed europeo. Siamo di fronte a tutta una serie di possibili contesti in cui effettivamente è necessario, è opportuno garantire queste figure che noi presumiamo essere più fragili, bisognose di tutela rispetto agli adulti, proprio perché su tutte queste piattaforme, su tutti questi siti, su tutti questi servizi che il minore si vede offerto, poi lui stesso può generare dei dati attraverso l’attività che poi realizza nella fruizione di questi servizi, pensiamo all’attività che realizza quando fruisce di un social network, durante un utilizzo di questi servizi, la fruizione di questi servizi genera dei dati personali. Questi dati personali possono poi essere utilizzati dal gestore di questo stesso sito per profilare la loro figura del minore e quindi poi presentare delle pubblicità che possono incidere sulla sua attività, sulla sua formazione.

Il paragrafo 1 fa riferimento all’età di 16 anni, quindi 16 anni per il legislatore europeo è l’età soglia in qualche modo dopo la quale il minore può prestare il consenso. In realtà però, l’ultimo inciso del paragrafo 1 dice che gli Stati membri possono stabilire per legge un’età inferiore a tali fini, purché non inferiore a 13 anni. Quindi, con ciò il legislatore europeo permette agli Stati membri di stabilire al loro interno, quale sia l’età del consenso digitale, l’età del consenso digitale, che però è al massimo individuata in 16 anni o al minimo in 13 anni. E questo è un esempio in cui il regolamento, il GDPR, pur essendo un regolamento, non riesce nell’obiettivo di uniformazione, perché quello che è successo è che tutti gli Stati membri dell’Unione europea hanno scelto età diverse, in alcuni paesi hanno scelto 13 anni, in altri 14, in altri 15, in altri 16. Quindi abbiamo una disciplina che da questo punto di vista è leggermente diversa in base ai Paesi, l’Italia con il decreto legislativo 101 del 2018, che è il decreto legislativo non di recepimento del Regolamento, perché il Regolamento non si recepisce, ma il decreto legislativo che è servito a uniformare la normativa interna con il GDPR. L’articolo 2 quinquies del nuovo Codice, del Codice privacy rinnovato appunto dal decreto legislativo 101, prevede che nel nostro Paese l’età del consenso digitale sia 14 anni. Quindi vuol dire che il minore ultraquattordicenne potrà prestare il consenso. Quindi in Italia l’età del consenso digitale è quella di anni 14. Il minore ultraquattordicenne presta il consenso, il minore infraquattordicenne, quindi più piccolo di 14 anni (paragrafo 1), dice che il trattamento è lecito soltanto se e nella misura in cui il consenso è prestato o autorizzato dal titolare della responsabilità genitoriale (noi tutto l’articolo 8, laddove indica l’età di anni 16, lo dobbiamo rileggere come se al posto di 16 ci fosse scritto 14). Quindi il trattamento dei dati personali del minore è lecito ove il minore abbia almeno 14 anni, ove il minore abbia un’età inferiore a 14 anni il trattamento è lecito solo e nella misura in cui tale consenso sia prestato, autorizzato dal titolare della responsabilità genitoriale. Ovviamente le due situazioni richiedono una serie di considerazioni. Partiamo dal minore ultraquattordicenne, quindi il minore che presta il consenso in modo autonomo. Ovviamente questa l’abbiamo chiamata età del consenso digitale perché la regola che conosciamo tutti è che il minore in realtà, proprio perché minore non abbia una capacità d’agire, perché la capacità di agire, l’articolo 2 del Codice civile dice che viene raggiunta al raggiungimento della maggiore età. Quindi questo vuol dire che il consenso digitale si pone come strumento di esercizio della propria capacità in un’ottica di eccezione rispetto alla regola. Quindi la regola è che la capacità di agire si acquisisce, la capacità di agire è la capacità di incidere sulla propria sfera giuridica soggettiva, si acquisice ai 18 anni. Però questa prestazione del consenso si pone appunto come eccezione rispetto alla regola. E in realtà non ci sono grossi problemi nel considerare il fatto che ci siano delle eccezioni alla regola, perché da questo punto di vista il GDPR non ha introdotto una regola completamente nuova o diciamo inaspettata, perché nel codice civile, ma anche in leggi speciali, ci sono tutta una serie di riferimenti che riconoscono la necessità del minore di autodeterminarsi e quindi rispetto a specifiche situazioni conosciamo la possibilità che il minore incida in tutto ciò che riguarda un po’ le estrinsecazione della propria personalità. Quindi, insomma, ci sono già una serie di riferimenti nel nostro ordinamento che anticipano la capacità del minore di autodeterminarsi, quindi ecco da questo punto di vista non è una cosa totalmente nuova però appunto dobbiamo tenere conto del fatto che è una eccezione, un aspetto comunque particolare. Per quanto riguarda invece il minore infraquattordicenne, lì è necessaria una attenzione in più perché è vero che sicuramente non si vuole in nessun modo impedire l’accesso alle tecnologie che utilizzano i dati da parte dei minori infraquattordicenni però è necessario che questo incentivo all’utilizzo delle tecnologie o comunque questa anche inevitabilità dell’utilizzo di tecnologie da parte dei minori sia appunto realizzata in un modo che presti la massima attenzione al fatto che siamo di fronte a dei soggetti più vulnerabili; sempre nella logica per cui per il nostro legislatore fino ai 14 anni è necessario stare più attenti rispetto al processo di formazione dell’identità personale. Ecco quindi che l’articolo 8 dice che il trattamento dell’infraquattordicenne è lecito solo se e nella misura in cui è prestato o autorizzato dal titolare della responsabilità genitoriale. Allora innanzitutto con titolare della responsabilità genitoriale non includiamo soltanto il genitore ma chiunque svolga la responsabilità genitoriale per il minore, quindi anche per esempio il tutore, quindi va inteso in un senso ampio. Ci concentriamo sui verbi prestato e o autorizzato, perché sembrano sinonimi, però vanno interpretati in un modo diverso. Quindi prestato ci dice l’ipotesi in cui il rappresentante legale del genitore manifesta egli stesso una volontà positiva al trattamento dei dati. Quindi è come in questo caso della prestazione il genitore o comunque il tutore, colui che esercita la responsabilità genitoriale, in qualche modo si va a sostituire, in questo caso nell’attività di prestazione il consenso quindi è direttamente l’esercente la responsabilità genitoriale che presta il consenso per il minore. Invece autorizzato lo dobbiamo leggere in un modo diverso, autorizzato è quindi la situazione in cui il minore presta il proprio consenso direttamente, però ai fini del trattamento è necessario che il consenso del minore venga integrato o comunque confermato dall’esercente la responsabilità genitoriale proprio perché è una sorta di autorizzazione rispetto al consenso che il minore ha prestato in un’iniziale diciamo autonomia. Ovviamente qual è il problema, che tutta questa bella regola si scontra un po’ con la realtà, perché nella realtà è facile immaginare che un minore che utilizza autonomamente gli strumenti digitali sia in grado di aggirare il consenso o comunque la partecipazione del genitore, perché il minore conferma magari che il genitore è d’accordo semplicemente al posto del genitore, il genitore nemmeno sa di questa prestazione del consenso e non ha nemmeno modo di controllarlo, quindi diciamo la questione che si pone è come assicurarsi che questa regola rispetto all’infraquattordicenne venga rispettata.

Qui subentra il principio di accountability del titolare. È il titolare ad essere responsabile per fare di tutto affinché effettivamente vengano rispettati i requisiti della norma. Come fa a fare di tutto, ovviamente come al solito alla luce delle tecnologie a disposizione, dovrà realizzare, dovrà predisporre delle misure necessarie idonee a garantire che la regola venga effettivamente applicata. Quindi c’è proprio l’obbligo del titolare seppure non sia scritto espressamente nell’articolo 8 però in virtù del principio dell’accountability, di responsabilizzazione del titolare, riconosciamo, individuiamo questo dovere del titolare di adoperarsi al meglio in ogni modo ragionevole, quindi sempre anche nel rispetto della proporzionalità, affinché sia possibile verificare che il consenso sia stato prestato o autorizzato da un esercente la responsabilità genitoriale, quindi sostanzialmente che il minore non abbia prestato il consenso senza che il genitore ne sia a conoscenza. Anche qui, piccolo problema: ricaviamo questo dovere del titolare, ma al titolare non vengono date delle linee per rispettare o comunque per sapere in modo definitivo come è giusto adoperarsi. E quindi anche qui, proprio perché il GDPR su questo è lacunoso, possiamo ricorrere al dato comparatistico, riguardiamo di nuovo alla disciplina statunitense che anche rispetto a questo è più completa. Abbiamo tutta una serie di esempi che ritroviamo nella disciplina degli Stati Uniti. Per esempio il titolare può adoperarsi fornendo dei moduli da compilare, quindi il genitore deve compilare un modulo, deve riempire delle caselle da cui effettivamente poi fornisce in modo diretto il consenso al trattamento dei dati da inviare magari via mail o da compilare in un form al momento della registrazione su un certo servizio. Un altro esempio può essere che il genitore debba dare conferma attraverso l’indicazione delle generalità di una carta di credito, oppure che debba fare un collegamento web, quindi una videochiamata attraverso la quale presti effettivamente il consenso. O ancora vengono applicati degli strumenti di riconoscimento facciale attraverso la somministrazione, l’upload di una fotografia. Oppure il genitore può caricare un documento, la fotocopia del documento. Oppure ancora rispondere a specifiche domande. Insomma, tutta una serie di possibilità attraverso cui il titolare può far sì che sia il più vero possibile, il più quasi sicuro possibile che il genitore sia effettivamente partecipe alla prestazione di questo consenso. Rimanendo sul GDPR, quello che possiamo dire è che sicuramente qualsiasi richiesta venga fatta al titolare che risponde del principio di responsabilizzazione, però d’altra parte facciamo sempre valere anche il principio di proporzionalità, quindi il titolare sarà chiamato a predisporre le misure più idonee possibili però sempre sempre all’interno di un approccio proporzionato. Quindi in base a quelli che sono i rischi per il minore che il trattamento porta con sé, dovrà predisporre delle misure più o meno elastiche. Quindi se si tratta di una situazione a basso rischio, magari una conferma via e-mail o di compilazione del form della registrazione è più che sufficiente. Invece se si tratta di attività di trattamento ad alto rischio, allora magari può essere richiesta quella misura più stringente, più complicata, che dia maggiori certezze del fatto che il genitore abbia partecipato. Quindi sempre un approccio al rischio, che in base alla valutazione del rischio che il minore in questo caso corre rispetto al trattamento dei suoi dati, ricordiamoci sempre che la misura della gravità del rischio la stabilisce il titolare stesso, poi però sarà responsabile della sua valutazione nel caso in cui non sia corretta, e poi predisporre le misure che alla luce di queste considerazioni vengono considerate più idonee. Ovviamente i problemi permangono perché resta il fatto che se il metodo di verifica del consenso genitore è troppo blando, allora il minore magari riesce ad aggirarlo, così come se è troppo stringente pensiamo a quelle riguardanti il caricamento della carta di credito, che è un metodo particolarmente difficile per il minore, magari da aggirare, allora lì il problema che si pone è che possano essere magari limitate le possibilità del minore di accedere al servizio perché un genitore sicuramente è più restio dal lasciare i dati della sua carta di credito su un certo sito che poi magari utilizza il minore stesso. Quindi da un lato il rischio di aggiramento del minore, dall’altro il rischio che il consenso non venga prestato, però un bilanciamento poi di volta in volta da fare in relazione al caso concreto perché la logica per quanto poi ci sia questo rischio è comunque che bisogna sempre bilanciare da un lato il diritto del minore ad accedere ai servizi digitali, dall’altro però l’esigenza della sua sicurezza e in questo ovviamente il ruolo del titolare della responsabilità genitoriale è fondamentale. Peraltro teniamo comunque conto del fatto che questa regola riguarda gli infraquattordicenni, quindi comunque dal compimento del 14º anno poi il minore può intervenire direttamente.

Peraltro anche rispetto al modo in cui intervengono i genitori si pongono delle questioni, in particolare i genitori devono essere per forza d’accordo? O basta la volontà di uno dei due? Per esempio questo è un altro tema che si pone in realtà ben prima del discorso specifico sul trattamento dei dati personali perché è un tema che si è posto in generale rispetto alla pubblicazione delle immagini dei minori. E su questo la giurisprudenza più risalente era effettivamente più incline a riconoscere il fatto che bastasse la volontà di uno. Un esempio antecedente ovviamente le dinamiche social è quello trattato da una Cassazione del 2006, in particolare la 21172 che era riferito a una domanda di risarcimento dei danni che la madre di un minore avanzava nei confronti dell’altro genitore perché questo genitore, personaggio noto, aveva portato i figli con sé in spiaggia, con la nuova compagna e le fotografie della giornata in spiaggia erano state pubblicate da dei giornali. La nuova compagna in particolare era un personaggio televisivo e in queste fotografie risultava in topless. La madre agisse per risarcimento dei danni provocati nei confronti della propria dignità e della dignità del minore che risultava essere state lese da questa pubblicazione. La Cassazione invece diceva che la partecipazione, la volontà del genitore che aveva permesso che queste foto venissero scattate era sufficiente ad integrare la volontà necessaria alla pubblicazione anche delle immagini dei minori in queste fotografie e che quindi la domanda di risarcimento del danno che la madre aveva avanzato andava rigettata. Un secondo esempio un po’ più recente e che si va più diffondendo è quello per cui si richiede la volontà congiunta dei due genitori. Da questo punro di vista citiamo una ordinanza del Tribunale di Mantova del 2017, che è stata particolarmente studiata e commentata perché è stata una ordinanza abbastanza rilevante, perché qui, per la prima volta, c’è questo cambio di passo un po’ più netto della giurisprudenza, che poi è stato seguito anche da sentenze successive di altri tribunali. In questo caso invece entrando in gioco lo specifico aspetto dei social network (che invece nel caso di prima non c’era perché abbiamo detto che era del 2006), e con riferimento specifico ai social network, invece, la Corte, il giudice mantovano si è pronunciato nel senso di ritenere fondamentale la partecipazione di entrambi i genitori. Il caso qui era quello di genitori tra loro separati, ma con un affido condiviso dei figli minori e nell’accordo di separazione addirittura i genitori avevano scritto di non ammettere la pubblicazione delle foto dei figli su Facebook o comunque i social network. La madre in particolare, si impegnava a non farlo, tuttavia non rispettava questo impegno che era stato preso nell’accordo di separazione e quindi non solo continuava a pubblicare foto dei figli su Facebook, ma nemmeno aveva rimosso quelle che aveva già postato come con il marito si erano detti. Quindi il marito, il padre dei bambini d,ei figli minori, si rivolgeva al giudice chiedendo di inibire questa attività che la moglie continuava a porre in essere e a obbligare alla rimozione delle immagini già pubblicate. Il tribunale dà pienamente ragione al padre. Conferma questa richiesta del padre e il tribunale mantovano in questa ordinanza appunto del 2017 afferma proprio l’imprescindibilità del consenso di entrambi per la pubblicazione delle foto, perché la logica è che la circolazione delle foto dei minori su internet, in particolare i network, è una pubblicazione che non è fine a se stessa, perché nel momento in cui ho posto la foto di mio figlio minore non la sto pubblicando su internet e poi ho la certezza che la posso vedere solo io. Ma il giudice afferma che nel funzionamento dei social network, nel funzionamento della rete è implicita la pericolosità, è implicito il rischio per il minore dato dal fatto che la circolazione dell’immagine poi è incontrollabile. Un’immagine, una volta che viene postata effettivamente, poi può circolare, può giungere anche a dei soggetti sconosciuti che la possono utilizzare in qualsiasi modo. Quindi la pubblicazione dell’immagine del minore è in sé potenzialmente lesiva, potenzialmente rischiosa, potenzialmente pregiudizievole e quindi la soglia di accettabilità della pubblicazione richiede il consenso di entrambi, quindi senza il consenso di entrambi non è possibile, perché il rischio è talmente elevato che è più opportuno evitare questa combinazione.

Altro esempio, Tribunale di Rieti che è di poco successivo perché del 2019 però questa è una sentenza e non ordinanza e qui siamo di fronte ad una situazione invece di genitori separati in cui il padre aveva una relazione con un’altra donna. Questa donna stessa postava le foto dei figli del compagno, figli minori su Facebook e su determinati social e la madre di questi bambini interveniva per richiedere la cancellazione. E anche il giudice di Rieti ha fatto riferimento allo stesso identico principio sancito dal giudice mantovano due anni prima, perché proprio si sancisce la necessità di questa attività condivisa da parte dei genitori perché la diffusione e la circolazione delle immagini sui social network va considerata potenzialmente lesiva. Questa tendenza rientra perfettamente in quello che è in generale la disciplina del rapporto tra genitori e figli, perché il principio che regola l’attività dei genitori nei confronti dei figli, guardiamo gli articoli 315, 315 bis del codice civile, ci dicono proprio che i genitori devono sempre realizzare nei confronti dei figli attività che siano volte a rispondere a quelle che sono le inclinazioni dei figli, le volontà dei figli. La volontà del figlio deve essere presa in considerazione. Quindi anche la volontà del figlio capace di discernimento può essere considerato dal giudice anche nel caso di disaccordo dell’altro genitore. Però sono tutte situazioni che vanno viste nel caso concreto, ciò che occorre è che di fronte allo scontro tra l’esercente la responsabilità genitoriale interviene il giudice e il giudice quando deve decidere rispetto a delle vicende dei fatti che riguardano un minore deve sempre valutare il principio che è riconosciuto a livello ONU del “best interest of the child“. La logica è sempre quella di prendere una decisione che nel caso concreto sia in grado di soddisfare i migliori interessi del minore i best interest of the child. Un esempio in tal senso,sempre di merito, è una decisione del giudice romano in questo caso, in cui c’era uno scontro tra madre e figlio, quindi non tra i genitori ma tra madre e figlio, perché il figlio si scontrava con la madre in quanto questa pubblicava continuamente immagini su Facebook del figlio minore, non solo pubblicava le immagini, ma pubblicava anche post quindi per iscritto in cui descriveva che il figlio aveva determinati problemi e aveva determinate questioni per cui non stava bene e pubblicava tutto ciò su Facebook. Il figlio si rivolgeva quindi al giudice e il giudice riteneva effettivamente di dover intervenire rispetto a questo comportamento della madre perché andava a considerare il comportamento della madre come tale da incidere in modo potenzialmente irrimediabile sul rapporto tra madre e figlio. In particolare, il figlio chiedeva anche che gli venisse consentito di andare a studiare all’estero per allontanarsi dalla madre per tutto il malessere che gli aveva provocato questo suo attivismo sui social e il giudice effettivamente accoglieva la richiesta del figlio sostenendo che il rapporto madre figlio era talmente compromesso dall’utilizzo dei social da parte della madre che solo attraverso l’allontanamento magari si sarebbe potuto ristabilire. Insomma il ruolo del giudice da questo punto di vista è molto importante e sempre deve andare a verificare le situazioni del caso concreto.

Chiudendo sul tema del consenso, il considerando sul diritto all’oblio torna a questo punto del discorso perché rispetto al minore infraquattordicenne il cui consenso viene prestato o autorizzato dal genitore, dobbiamo tenere conto che al compimento dell’età del consenso digitale il minore deve avere la possibilità di confermare quel consenso o altrimenti esercitare il diritto all’oblio rispetto al consenso precedentemente prestato. Proprio perché la logica è che una volta compiuta l’età del consenso digitale, deve essere lui personalmente a prendere una decisione rispetto alla liceità del trattamento dei dati personali. Infatti tornando all’articolo 8, al testo dell’articolo 8, il riferimento è che il trattamento è lecito, le condizioni sono proprio quelle di liceità che richiedono la partecipazione diretta dell’interessato una volta che giunge all’età del consenso digitale.

Ultimo aspetto, il paragrafo 3 dell’articolo 8 che ci dice che il paragrafo 1 (quindi quello riferito alla prestazione, alla liceità del trattamento) non pregiudica le disposizioni generali di diritto dei contratti e questo è un aspetto importante perché il porre un’età del consenso digitale sotto la maggiore età è qualcosa che si pone come eccezione rispetto alla regola e la conferma che sia un’eccezione in realtà, la da lo stesso paragrafo 3 proprio perché dice che questa previsione dell’articolo 8 non incide, non intacca sulle regole, sulle norme degli Stati membri. Quindi tutte le regole che gli Stati membri abbiano rispetto alla validità, all’efficacia di un contratto, non sono minimamente intaccate da questa previsione. Quindi qui cosa succede, succede che poi di volta in volta bisognerà far interagire le norme di diritto dei contratti con le norme sulla protezione dei dati personali, laddove le due debbano essere applicate in un medesimo contesto, perché potremmo essere di fronte ad una situazione in cui il minore ha l’età del consenso digitale, perché magari a 15 anni, però, non avendo raggiunto la maggiore età, non può stipulare un contratto valido. Quindi potremmo essere di fronte ad una situazione in cui il trattamento dei dati personali è lecito, però il contratto a cui il trattamento afferisce è un contratto annullabile perché il rimedio previsto per il contratto stipulato da minori di età è l’annullabilità. Quindi, di fronte all’eventuale annullamento, perché l’annullamento non è automatico, l’annullamento deve essere chiesto dall’interessato entro cinque anni da quando è stipulato il contratto, siamo di fronte a quelle situazioni in cui effettivamente potremmo avere un contratto annullabile, ma un consenso validamente prestato, quindi un trattamento di dati personali è lecito. Ecco, in questi casi l’interazione fra le due discipline ovviamente sarà tale che, in caso di annullamento del contratto, appunto perché stipulato dal minore di età, nell’eventualità di annullamento del contratto allora automaticamente dovrà cessare anche il trattamento di dati personali che da quel contratto dipende, proprio perché non toccandosi le regole sulla esecuzione, l’efficacia e la validità dei contratti stipulati dai minori, sarà necessario poi di volta in volta far interagire le due discipline.

Diritto dei dati – I diritti dell’interessato

I diritti dell’interessato: accesso ai dati, rettifica dei dati, cancellazione dei dati, oblio, limitazione del trattamento, portabilità dei dati, opposizione al trattamento.

Passiamo a vedere quali sono i diritti dell’interessato che fanno un po’ da contraltare rispetto a quelli che sono gli obblighi dei titolari del trattamento proprio perché tutti i vari obblighi poi vanno a specificarsi nei diversi diritti che vengono riconosciuti, guardiamo agli articoli da 15 in poi del GDPR e in particolare il diritto di accesso ai dati personali, il diritto di rettifica, di integrazione, di cancellazione e che sono diritti un po’ più noti anche nella disciplina della privacy precedente e poi in particolare il diritto all’oblio e il diritto alla portabilità dei dati sono invece dei diritti di introduzione recente perché sono del GDPR stesso. Nel complesso quello che ci interessa è avere chiaro che tutti questi diritti in modo appunto complessivo vanno a rendere esercitabile in concreto il più ampio diritto all’autodeterminazione per quanto riguarda il controllo, il trattamento, la protezione dei dati personali, quindi in generale parliamo di autodeterminazione rispetto alle proprie informazioni. Iniziamo con l’accesso, l’accesso di cui all’articolo 15 del GDPR. L’accesso come già dal nome possiamo facilmente intuire è volto ad accedere, a reperire, a ottenere delle informazioni. Informazioni rispetto alle finalità del trattamento, alle categorie di dati che vengono trattati (sono dati comuni o se sono i dati particolari dell’articolo nove), informazioni rispetto al soggetto titolare del trattamento, al periodo per cui è previsto il trattamento dei dati o informazioni rispetto ai propri diritti. Banalmente un interessato che non conosce quali sono i propri diritti perché non conosce la normativa ha diritto di accedere a queste informazioni, di chiederle al titolare, o ancora importante il diritto a conoscere se delle proprie informazioni saranno utilizzate per attività interamente automatizzate, ovvero i processi decisionali automatizzati. La logica è sempre quella di garantire che il soggetto interessato al trattamento dei propri dati possa nel tempo mantenere un controllo, anche dopo che il trattamento è iniziato e quindi, per esempio, verificare se effettivamente le condizioni di liceità del trattamento perdurano, se il soggetto titolare sta rispettando le finalità che aveva dichiarato e così via.

Proprio perché riguarda il mantenimento del controllo rispetto alle proprie informazioni, il diritto all’accesso è un diritto che possiamo esercitare sempre. Quindi non è possibile un rapporto tra titolare e interessato in cui il diritto d’accesso sia subordinato, ad esempio, ad un certo tempo. Posso chiedere l’accesso in qualsiasi momento per cui perduri il trattamento. Questa logica è fondamentale proprio perché in ogni momento si ha diritto di conoscere come si sta svolgendo questo rapporto che riguarda il trattamento dei nostri dati e poi perché l’accesso tra tutti i diritti è un po’ il diritto che viene esercitato in apertura, l’accesso in qualche modo è strumentale all’esercizio dei diritti successivi, perché se voglio esercitare il diritto alla cancellazione magari prima esercito un accesso per conoscere meglio le dinamiche e poi valuto che effettivamente voglio procedere alla cancellazione di dati. Quindi nessun vincolo temporale. E poi l’altra cosa importante è che nel momento in cui lo esercito, il titolare mi deve rispondere innanzitutto entro un tempo ragionevole quindi così come io interessato non ho limiti di tempo per fare la richiesta, dall’altra parte invece il titolare ha dei limiti di tempo per rispondere alla mia richiesta. Si dice entro un termine ragionevole, ovviamente in considerazione delle tecnologie a disposizione del titolare e delle sue esigenze organizzative, però deve farlo entro un tempo appunto ragionevole, al più tardi entro un mese dalla richiesta. Questo periodo di un mese può essere anche prorogato fino a un massimo di due mesi, purché il titolare, quindi questo è fondamentale, purché il titolare comunichi all’interessato il ritardo, quindi la necessità di questa proroga che deve essere effettivamente necessaria al titolare e quali sono le ragioni che la rendono necessaria, quindi deve essere trasparente al massimo rispetto al motivo per cui questa risposta esiterà ad essere fornita all’interessato proprio perché la regola sarebbe che deve farlo entro un tempo ragionevole e senza ingiustificato ritardo. Per quanto riguarda poi la forma di questa risposta, la forma di questa risposta è libera, le informazioni che il titolare fornirà all’interessato possono essere fornite in qualunque forma, quindi sia cartacea, telematica o che sia in formato audio o che sia in formato video, purché la forma in questione sia intellegibile. Inoltre, oltre al limite diciamo della intellegibilità, l’altra caratteristica fondamentale delle informazioni che vengono fornite a seguito di accesso è che devono essere fornite in modo completo e chiaro.

Di regola, l’esercizio dell’accesso non prevede un pagamento. Per evitare però che un interessato possa abusare del diritto che ha di accedere alle informazioni, allora di fronte ad una richiesta reiterata delle informazioni, il titolare può richiedere, può addebitare un contributo di spese all’interessato, e sarà un contributo che ovviamente dovrà essere parametrato in base ai costi amministrativi necessari all’adempimento della richiesta e quindi per giudicare che questi costi richiesti siano corrispondenti a quanto effettivamente ammonta l’onere amministrativo in questione, bisogna anche documentare queste spese. Quindi di regola non si paga nulla però, purché siano documentati e di fronte a richieste reiterate è possibile addebitare il costo dell’accesso. Ultimo aspetto legato all’accesso è che l’esercizio dell’accesso è subordinato dall’articolo 15 alla identificazione dell’interessato, quindi il titolare deve poter identificare il soggetto interessato. Oltre a dare le proprie generalità per il resto l’interessato non deve addurre nessun tipo di motivazione, quindi qualunque sia il motivo per cui sto esercitando l’accesso non devo giustificarmi con il titolare, lo esercito senza dover motivare il perché della mia richiesta. Se ponesse degli ostacoli, se ponesse limitazioni rispetto all’esercizio dei suoi diritti allora andrebbe contro a quel principio di correttezza già trattato. Quindi qui ritroviamo un’altra concretizzazione del principio della correttezza che è proprio quella da parte del titolare di permettere all’interessato di esercitare nel modo più semplice possibile i suoi diritti. Le stesse regole legate ai tempi di esercizio del diritto e di risposta da parte del titolare, valgono per l’accesso e valgono anche per i diritti di integrazione, di rettifica (articolo 16 del GDPR). Questi diritti sono dei diritti che in qualche modo vanno a tutelare in modo più specifico, più mirato, il diritto all’identità personale dell’interessato perché la rettifica e l’integrazione sono dei diritti che permettono attraverso il loro esercizio di contestualizzare, di completare, di aggiornare le informazioni che compongono la rappresentazione verso l’esterno della persona e quindi in questo modo rendere questa rappresentazione pienamente aderente alla realtà attuale di quel soggetto e quindi a tutelarne l’identità personale. Perché la logica è che se rispetto alla mia identità personale, la rappresentazione che si fa della stessa è una rappresentazione che si basa su informazioni incomplete o informazioni non aggiornate, allora la rappresentazione che esce fuori della mia persona è una rappresentazione falsata, non corretta e quindi lesiva della mia identità personale. Attraverso l’esercizio del diritto alla rettifica e all’integrazione si interviene proprio da questo punto di vista e quindi si ricostituisce con il maggior grado possibile di accuratezza la mia rappresentazione perché andiamo a completare tutte le informazioni che non dovessero essere aderenti. Quello che dobbiamo sempre pensare è che tutto ciò che è incompleto in questo tipo di contesto, inesatto, poco chiaro, rende l’informazione in qualche modo falsata e in generale la logica è sempre quella per cui l’informazione falsata può divenire in determinati modi lesiva della nostra identità personale.

In modo complementare a questi diritti di accesso, rettifica, integrazione è la cancellazione e l’oblio, siamo nell’articolo 17. Se io interessato mi rendo conto che sono di fronte a determinati motivi che l’articolo 17 mi elenca, posso chiedere la cancellazione dei dati che mi riguardano. Alcuni esempi sono per esempio il fatto che quei dati non siano necessari alle finalità che il titolare sta perseguendo e qui stiamo concretizzando per esempio il principio di minimizzazione, oppure i dati che ho fornito non sono necessari davvero alle finalità che il titolare persegue, quindi li cancello perché non li servono. Ancora, il trattamento ha come condizione di liceità il mio consenso, io revoco il mio consenso, quindi viene meno la condizione di liceità, chiedo la cancellazione. Oppure scopro che il trattamento dei dati si sta realizzando in modo illecito e quindi chiedo la cancellazione; tutta una serie di motivi per cui posso chiedere la cancellazione. Però proprio perché ci sono delle situazioni in cui mi devo trovare, riguardo alla cancellazione non siamo di fronte ad un diritto esercitabile senza motivarlo, proprio perché è necessario ritrovarsi in determinate situazioni che appunto l’articolo 17 ci elenca. Peraltro anche quando la nostra richiesta è fondata, la cancellazione, nel senso di distruzione di dati, non è l’unico modo in cui si può soddisfare la richiesta dell’interessato perché sicuramente la distruzione dei dati che sono nella disponibilità del titolare è un primo modo, però sono idonei a soddisfare il diritto di cancellazione anche altre attività, in particolare la anonimizzazione dei dati, qualsiasi attività che renda impossibile reidentificare il soggetto. Quindi cancellare questi dati non è l’unica cosa che il titolare può fare, ma lo stesso scopo si può raggiungere anche rendendo anonimi questi dati con le tecnologie a disposizione, purché appunto sia fatto in un modo tale da rendere impossibile che i dati anonimi che restano, permettano di reidentificare il soggetto a cui si riferivano. Tant’è che mentre la anonimizzazione è possibile perché caratteristica della anonimizzazione è proprio questa scissione in qualche modo definitiva tra informazione e persone a cui si riferiscono, d’altra parte lo stesso scopo non si potrebbe raggiungere con la pseudonimizzazione, quindi con l’attribuzione ai dati di uno pseudonimo, pseudonimizzazione dei dati. Proprio perché nella pseudonimizzazione, rispetto alla anonimizzazione dei dati, non c’è questo elemento di definitività, perché se attribuisco uno pseudonimo rispetto ad un dato, in un secondo momento potrei di nuovo identificare il soggetto, invece se lo rendo anonimo automaticamente non posso reidentificare la persona a cui si riferivano. Quindi la cancellazione si può realizzare in tutti i modi con cui rendo irreversibile il collegamento tra un dato, un’informazione e una persona. Ovviamente anche qui teniamo sempre conto che a tutela del titolare vige sempre il principio di proporzionalità, per cui tutte queste attività si possono pretendere nella misura in cui il titolare abbia poi la possibilità a livello di costi, di tecnologie e di organizzazione propria, per soddisfare la richiesta. Ovviamente nel caso in cui il titolare aveva anche trasmesso a dei terzi i nostri dati di cui chiediamo la cancellazione, quindi rispetto ai quali esercitiamo il diritto alla cancellazione, il titolare dovrà rivolgere anche a questi terzi l’indicazione rispetto alle attività che ha svolto per la cancellazione e quindi questi terzi che avevano ricevuto i nostri dati saranno tenuti a fare altrettanto.

Nella pratica quello che succede è che il soggetto interessato spesso e volentieri esercita il diritto alla cancellazione principalmente in casi in cui si rende conto che il trattamento viene realizzato in assenza di un fondamento, in assenza di una condizione di liceità. In tutti questi casi il titolare può effettivamente rispondere anche in modo diverso rispetto all’accoglimento della richiesta, ad esempio il titolare potrebbe non accogliere la mia richiesta e dimostrare che il fondamento giustificativo del trattamento sussiste perché siamo nelle condizioni di liceità dell’articolo sei, e allora potrebbe respingere la nostra richiesta e quindi continuare il trattamento, verificando che effettivamente la richiesta non sia fondata.

L’articolo 17 fa anche riferimento al diritto all’oblio. Il diritto all’oblio è un diritto di nuova introduzione nel GDPR. È un diritto che conosciamo già da prima però se ne parla per la prima volta a livello normativo nel contesto del trattamento dei dati. Quindi noi conoscevamo già il diritto all’oblio con riferimento alla tutela di quella che oggi chiamiamo riservatezza, la privacy intesa come riservatezza. Con il GDPR a livello normativo entra in gioco l’oblio anche rispetto al trattamento dei dati. Sottolineo a livello normativo perché, come vi dico tra poco, la giurisprudenza aveva iniziato già a toccare questo aspetto. Allora in generale mi pare che lo avessimo già accennato nella prima lezione, il diritto all’oblio è il diritto ad essere dimenticati. Quindi il diritto di una persona a chiedere che determinate notizie sul suo conto, trascorso un certo periodo di tempo, vengano cancellate. Perché? Perché ormai risultano dimenticate o comunque sconosciute, ignote alla generalità dei consociati e quindi non c’è più interesse a venirne a conoscenza. Quindi anche delle notizie che tempo addietro erano state legittimamente divulgate, erano state pubblicate in un certo momento storico in modo del tutto legittimo, tempo dopo si può richiedere che vengano cancellate proprio perché non rivestono più un interesse, non hanno più interesse ad essere conosciute. Ed essere conosciute vuol dire ad essere divulgate attraverso i circuiti dell’informazione che un tempo erano soltanto i giornali o al massimo la televisione, ormai anche e quasi principalmente su internet. Quindi il criterio principale, sicuramente per verificare la fondatezza della richiesta di esercitare il diritto all’oblio è il trascorrere del tempo. Quindi è necessario che sia trascorso un tempo tale che abbia fatto perdere rilevanza alla notizia. A meno che poi non siano nel frattempo emersi dei fatti nuovi o comunque determinate dinamiche che in qualche modo riescono ad integrare il quadro che si era delimitato anni addietro, tempo addietro. Però a meno che non ci siano questi fatti nuovi o comunque questi aspetti che un tempo non erano noti allora diciamo effettivamente passato un certo periodo di tempo si può dire che la notizia non sia più di interesse per la collettività. 

Un altro diritto è quello alla limitazione del trattamento. Il diritto alla limitazione del trattamento è previsto dall’articolo 18 del GDPR. Ed è un diritto che può essere esercitato soltanto nei casi indicati dall’articolo 18 che sono quattro. Sono quindi delle ipotesi tassative. Vuol dire che non sono degli esempi di situazioni in cui può essere esercitato, ma sono proprio le uniche ipotesi in cui si può esercitare la limitazione. La prima ipotesi è quella in cui l’interessato contesta l’esattezza dei dati, quindi sostiene che i dati non siano esatti, i dati sul suo conto, e quindi per il periodo necessario a verificare l’esattezza o meno di questi dati, il titolare per rispondere al diritto di limitazione, sospende – limitazione nel senso di sospensione in questo caso – sospende il trattamento. Una seconda ipotesi, quella alla lettera b dell’articolo 18, è quella situazione in cui il trattamento risulti essere illecito, però l’interessato chiede al titolare di limitare l’utilizzo dei dati ma comunque di non interrompere definitivamente il trattamento. Quindi evidentemente sono situazioni in cui il trattamento si rivela essere illecito però l’interessato ha comunque dei motivi per preferire che il trattamento continui seppur in modo limitato e quindi chiede la limitazione ma anche la prosecuzione del trattamento stesso. Una terza ipotesi, lettera c dell’articolo 18, è quella in cui i dati non sono più necessari al titolare, però di nuovo l’interessato chiede che ci sia una limitazione del trattamento alla sola conservazione dei dati perché evidentemente questa conservazione gli serve per l’accertamento o l’esercizio dei suoi diritti in sede giudiziaria. Quindi se magari quei dati li devo utilizzare perché mi servono in sede giudiziaria allora chiedo che seppure il titolare non abbia più motivo per trattare i dati, comunque limiti il trattamento alla sola conservazione e li conservi così che io li possa utilizzare in sede giudiziaria. Poi ultima ipotesi, quella della lettera d, in cui l’interessato si oppone al trattamento che è necessario per un legittimo interesse del titolare e quindi, in questo caso (come nel primo, quello della lettera a), il titolare limiterà il trattamento nel periodo che è necessario a verificare che il suo legittimo interesse prevale sull’interesse del soggetto i cui dati personali vengono trattati. Ora da questa descrizione si capisce che le ipotesi più simili tra loro sono la prima e l’ultima e le due in mezzo. Perché la prima e l’ultima si coglie la loro natura cautelare. La logica è impedire la prosecuzione del trattamento per il periodo necessario all’accertamento di una situazione che è invece incerta: prima ipotesi quella dell’esattezza dei dati o meno, secondo ipotesi quella della necessarietà o meno del trattamento per legittimo interesse. E quindi per il periodo di tempo, per questo si parla di natura cautelare, per il periodo di tempo necessario all’accertamento di queste situazioni si limita il trattamento alla sola conservazione. Poi nel caso in cui si rileva che i dati sono esatti o il legittimo interesse del titolare prevale su quello dell’interessato, allora il titolare ne darà comunicazione all’interessato e riprenderà il trattamento così come lo svolgeva prima. Invece, nel caso in cui la verifica rispetto all’esattezza, rispetto alla prevalenza dell’interesse, dia ragione all’interessato allora poi l’interessato potrà chiedere la cancellazione dei dati o potrà insomma decidere come procedere. Nei casi invece delle lettere b e c, e quindi quelle riguardanti le richieste dirette di limitazione da parte del dell’interessato (nel primo caso abbiamo detto anche se il trattamento è lecito e nel secondo caso abbiamo detto quando i dati serve che siano conservati perché il soggetto interessato li utilizzi in sede giudiziaria), allora in questi casi finché perdura la limitazione, i dati saranno comunque trattati dal titolare, quando poi finisce questo periodo, allora si procederà alla cancellazione di questi dati. Nel primo caso, perché il trattamento è illecito, quindi comunque l’illiceità del trattamento comporta la cancellazione, nel secondo caso perché il trattamento non è più necessario e quindi si procede alla cancellazione. Ciò che rileva però è che comunque ci si debba trovare in una di queste quattro ipotesi, non è possibile chiedere la limitazione del trattamento per ipotesi diverse da queste quattro. Quindi l’interessato potrà richiederlo in queste quattro ipotesi che però non deve descrivere. Quindi la richiesta deve partire dall’interessato che però non deve dire “mi sto ritrovando nell’ipotesi della lettera a, b, c o d”, deve semplicemente avanzare la richiesta. Poi, se il titolare non vuole soddisfare queste richieste, sarà lui a dover dimostrare che non si è all’interno del perimetro delineato dall’articolo 18 e quindi risponderà che non intende procedere alla limitazione del trattamento, dando dimostrazione dell’infondatezza della richiesta perché non aderente all’elenco dell’articolo 18. Quando invece deve soddisfare la richiesta come lo fa? Da un punto di vista tecnico quello che deve fare, quello che deve svolgere, è un’attività di contrassegno dei dati, deve in qualche modo imprimere sui dati interessati dalla richiesta un vincolo di inutilizzabilità, cioè questi dati devono dal punto di vista tecnico non essere più utilizzati, né essere considerati utilizzabili e si dovrà limitare alla loro conservazione. Diciamo che questa marcatura, questo contrassegno dei dati interessati dalla richiesta può avvenire poi in qualsiasi modo, sta al titolare individuare il modo in cui limiterà il trattamento. Quindi ad esempio, li può trasferire in un sistema di trattamento diverso da quello dove sono, oppure li può rendere inaccessibili, oppure li può rimuovere. Insomma, il modo in cui lo fa è nella sua discrezionalità, purché appunto soddisfi la richiesta, ovviamente sempre con il solito principio di proporzionalità, nei limiti di quanto gli è possibile in base ai costi che questa operazione comporta, in base alle sue tecnologie a disposizione.

Altro articolo che come l’oblio è stato introdotto nel GDPR per la prima volta è il diritto alla portabilità dei dati. Il diritto alla portabilità è un diritto che forse più di tutti esprime quella doppia anima del GDPR e cioè di tutela contestuale della persona nella rappresentazione della identità personale attraverso i dati e contestualmente tutela del mercato attraverso la circolazione dei dati. Perché il diritto alla portabilità è proprio funzionale non solo appunto a tutela della persona ma anche proprio al funzionamento del mercato digitale. Proprio perché la trasmissione dei dati in cui la portabilità tipicamente si realizza, permette una circolazione dei dati che possono essere utilizzati anche a livello di mercato, anche a livello di attività svolta dai professionisti del mercato in qualunque tipo di settore, e quindi poi è in questo modo la loro circolazione in qualche modo permette di generare ricchezza appunto anche per gli operatori economici e quindi aumentare e favorire la concorrenza nelle dinamiche di mercato. Innanzitutto il primo strumento, la prima estrinsecazione della portabilità è proprio quella della trasmissione, quindi si richiede la trasmissione di dati che sono in capo a un certo titolare, ad un altro titolare. E questo deve avvenire, prevede l’articolo 20 del GDPR, in un modo che sia accessibile, che sia chiaro, che sia strutturato, si dice interoperabile, nel senso che il titolare che trasmette i dati di cui dispone all’altro titolare deve farlo in modo tale che questo titolare possa utilizzare questi dati. Però poi la portabilità in generale è qualcosa che permette effettivamente anche il loro accesso e il loro riutilizzo. Cioè quando trasmetto devo poi permettere al secondo titolare di utilizzarli perché se li trasmetto in un formato per cui poi il titolare che li riceve non li può utilizzare allora non se ne fa niente. Quindi il diritto alla portabilità include in sé non solo la trasmissione ma anche la possibilità di accedervi, di riutilizzarli, di riceverli, di mantenerli, di conservarli. Deve essere reso possibile tutto questo e la ratio appunto è quella di rendere il più semplice possibile la circolazione di questi dati facendo, sempre attenzione alla tutela della persona, perché la loro circolazione permette di favorire la concorrenza sul mercato. L’articolo 20, però, delimita quali sono i dati che possono essere oggetto di portabilità. Innanzitutto non tutti i dati possono essere oggetto di portabilità. In particolare, l’articolo 20 prevede che siano portabili i dati trattati con mezzi automatizzati e la cui condizione di liceità si fondi su un consenso, oppure sulla conclusione di un contratto. Quindi le uniche ipotesi sono queste: la condizione di liceità, quella del consenso e quella del contratto (le lettere a e b dell’articolo 6). Non tutti i dati, quindi, possono essere oggetto della portabilità, innanzitutto per i parametri sopra accennati e poi perché non possono essere oggetto di portabilità i dati che sono stati oggetto di esercizio dell’oblio, proprio perché una volta che sono stati cancellati non sono più nella disponibilità del titolare, né tantomeno possono essere portati, trasmessi, i dati anonimi proprio perché rispetto ai dati anonimi manca quel collegamento tra informazione e persona e quindi non posso pretendere che vengono trasferiti dei dati anonimi. Per il resto, di regola, le rappresentazioni digitali dell’interessato con tutte le informazioni personali che lo riguardano tendenzialmente possono essere trasmesse, addirittura posso trasmettere quei dati che ho generato mediante le mie attività. Quindi se utilizzando un certo sito, ho generato una serie di dati riferiti alle mie ricerche, alla mia navigazione, o i cookie che ho generato, oppure la mia cronologia delle ricerche, oppure ho utilizzato dei dati riferiti alla mia localizzazione, tutti questi dati che ho generato attraverso la mia diretta attività li posso trasferire perché sono stati generati dalla mia attività concreta e diretta. Però, se questi dati sono stati poi utilizzati dal titolare del trattamento in modo da analizzarli e da queste analisi, principalmente l’analisi basata sul calcolo delle probabilità, sono stati generati dei nuovi dati, questi nuovi dati non possono essere oggetto della trasmissione, oggetto della portabilità, proprio perché sono dati analizzati dal titolare, quindi su cui il titolare ha svolto un’attività di analisi, sono i cosiddetti dati inferenziali e i dati derivati, di questi dati non può essere chiesta la trasmissione perché non sono soltanto generati dall’interessato, ma sono rielaborati dal primo titolare in un modo tale che impedisce la trasmissione. Proprio perché sono oggetto di tutta un’attività di lavoro che è stata svolta dal titolare e che in qualche modo, sempre nelle logiche di favore per il mercato, della concorrenza, rappresentano una conoscenza, un vantaggio conoscitivo, un know how che per quel titolare diventa un vantaggio economico sugli altri concorrenti e quindi per il funzionamento del mercato è considerato in qualche modo lesivo poi della sua attività la richiesta della loro trasmissione. Quindi ci fermiamo appunto soltanto ai dati che sono stati generati direttamente dall’interessato.

Altro diritto è previsto all’articolo 21 ed è il diritto di opposizione al trattamento. Il diritto di opposizione si realizza attraverso una dichiarazione di volontà con cui l’interessato esprime appunto la volontà di interrompere il trattamento in via definitiva. Ovviamente al titolare resta la possibilità di dimostrare la mancanza di motivi che giustificano questa interruzione e quindi se riesce a dimostrarlo può procedere nel trattamento. L’articolo 21 prevede in particolare che il titolare si debba astenere dal trattamento dei dati, quindi che debba interrompere il trattamento. A questo punto, è il momento in cui deve astenersi dal trattamento, implicitamente la norma richiede anche che li cancelli, perché, come già detto più volte, la semplice conservazione del dato è di per sé un trattamento (tant’è che abbiamo detto che quando limitiamo il trattamento svolgiamo solo l’attività di conservazione), quindi se si deve astenere dal trattamento, anche la conservazione è un trattamento e quindi è ritenuta in contrapposizione con l’esercizio della opposizione. Quindi l’opposizione dovrebbe includere automaticamente la cancellazione, a meno che il titolare non riesca a dimostrare che non sussistono i motivi per cui il  soggetto interessato può avanzare questo tipo di richiesta. L’opposizione, infatti, si può richiedere solo in due casi e cioè nei casi in cui il trattamento abbia come condizione di liceità le previsioni delle lettere e ed f dell’articolo 6. Le previsioni dell’articolo 6 sono quando il trattamento è necessario per l’esecuzione di un compito di pubblico interesse di cui viene rivestito il titolare e poi la lettera f invece quando il trattamento è necessario per il perseguimento di un legittimo interesse del titolare. Solo quando la condizione di liceità è una di queste due si può esercitare l’opposizione. Ovviamente quando si è in questa ipotesi, poi l’opposizione può essere esercitata in qualsiasi momento e poi starà al titolare dimostrare che la richiesta non può essere soddisfatta perché effettivamente il pubblico interesse nella lettera e e il legittimo interesse del titolare della lettera f, prevalgono sull’interesse dell’interessato e quindi il trattamento può effettivamente continuare, in quanto non ci sono dei motivi validi per ritenere prevalente l’esercizio di questo potere inibitorio, di questo potere di interrompere il trattamento. Quindi per l’interessato, nel caso in cui ci si trovi di fronte alle situazioni previste dalla lettera e ed f, è semplice fare questa richiesta, perché deve semplicemente dire perché vuole avvalersi di questo diritto però poi non deve dimostrare nulla, starà al titolare dover dimostrare che l’interesse dell’interessato è meno rilevante nel bilanciamento che bisogna sempre fare rispetto agli interessi indicati alle lettere e ed f dell’articolo 6, che appunto sono condizioni di liceità del trattamento.